La inteligencia artificial se ha convertido en una de las tecnologías más visibles de nuestro tiempo, pero también en una de las más difíciles de explicar con precisión. El término aparece asociado a sistemas capaces de conversar, traducir idiomas, reconocer objetos en una fotografía, recomendar contenidos, ayudar a escribir programas informáticos o generar imágenes a partir de unas pocas palabras. Bajo esa misma denominación conviven, sin embargo, técnicas muy diferentes, desarrolladas durante décadas y nacidas de problemas científicos que comenzaron mucho antes de que los actuales asistentes digitales entraran en la vida cotidiana. Comprender la inteligencia artificial exige por ello mirar más allá de sus manifestaciones recientes y preguntarse qué significa realmente construir una máquina capaz de realizar tareas que asociamos con la percepción, el aprendizaje, el razonamiento o el lenguaje. No se trata simplemente de observar lo que estas tecnologías pueden hacer, sino de entender las ideas, los métodos y las transformaciones de la computación que hicieron posible su aparición.
La historia de la inteligencia artificial tampoco comienza con los ordenadores modernos. Durante siglos, matemáticos, filósofos, inventores y científicos imaginaron mecanismos capaces de ejecutar operaciones, seguir reglas o reproducir parcialmente determinadas capacidades humanas. Aquellas aspiraciones estaban todavía muy lejos de lo que hoy denominamos IA, pero planteaban preguntas que acabarían resultando decisivas: ¿puede formalizarse el razonamiento?, ¿es posible representar una tarea mediante una secuencia precisa de operaciones?, ¿hasta qué punto una máquina puede manipular símbolos sin comprenderlos del mismo modo que una persona? El desarrollo de la lógica matemática y de las primeras máquinas de cálculo fue convirtiendo algunas de estas cuestiones filosóficas en problemas técnicos concretos. Con la aparición de la computación durante el siglo XX surgió finalmente un instrumento capaz de ejecutar algoritmos complejos a gran velocidad y, con él, una posibilidad nueva: intentar reproducir mediante máquinas ciertas funciones intelectuales que hasta entonces parecían exclusivamente humanas.
Desde sus comienzos, la inteligencia artificial avanzó siguiendo caminos diferentes. Algunos investigadores intentaron construir sistemas que representaran explícitamente conocimientos y razonaran mediante reglas; otros exploraron modelos capaces de reconocer regularidades a partir de ejemplos. Hubo periodos de enorme entusiasmo en los que parecía que las máquinas inteligentes estaban próximas, seguidos por etapas de decepción cuando las expectativas superaron ampliamente las capacidades reales de la tecnología. Esa alternancia entre avances, límites y reformulaciones constituye una parte esencial de la historia de la disciplina. La IA no apareció de forma repentina ni siguió una progresión continua. Muchas ideas consideradas hoy fundamentales atravesaron décadas de investigación, cambios de enfoque y dificultades técnicas antes de convertirse en herramientas realmente eficaces. Incluso conceptos que actualmente parecen inseparables de la inteligencia artificial —como el aprendizaje automático o las redes neuronales— poseen una trayectoria mucho más larga de lo que podría sugerir su reciente popularidad.
Uno de los cambios más profundos se produjo cuando numerosos sistemas dejaron de depender exclusivamente de instrucciones detalladas escritas de antemano y comenzaron a extraer patrones a partir de datos. En lugar de especificar manualmente todas las reglas necesarias para distinguir una imagen, interpretar una señal o realizar una predicción, podía diseñarse un procedimiento capaz de ajustar su comportamiento mediante ejemplos. Este principio abrió el camino al aprendizaje automático y posteriormente a formas mucho más sofisticadas de aprendizaje mediante redes neuronales. El aumento de la capacidad de cálculo, la disponibilidad de grandes cantidades de información digital y el desarrollo de nuevos métodos de entrenamiento permitieron abordar problemas que durante mucho tiempo habían resultado extraordinariamente difíciles para los ordenadores. Reconocer imágenes, transcribir voz, traducir idiomas o identificar relaciones dentro de enormes conjuntos de datos dejó progresivamente de ser un territorio reservado a experimentos muy limitados y comenzó a integrarse en aplicaciones utilizadas por millones de personas.
El lenguaje representa uno de los capítulos más importantes de esta evolución. Para un ordenador, una palabra no posee por sí misma significado, intención ni experiencia; debe convertirse en una representación susceptible de ser procesada matemáticamente. Conseguir que una máquina pueda trabajar con textos requiere establecer relaciones entre palabras, contextos y estructuras lingüísticas, y hacerlo de una manera suficientemente flexible como para enfrentarse a expresiones que nunca ha visto exactamente de la misma forma. Durante décadas se ensayaron diferentes estrategias para resolver este problema, desde sistemas construidos mediante reglas hasta métodos estadísticos y redes neuronales cada vez más complejas. Los modelos de lenguaje actuales son consecuencia de esa larga trayectoria y de una transformación fundamental en la manera de procesar grandes secuencias de información. Su capacidad para producir textos coherentes puede resultar sorprendente, pero no constituye un fenómeno aislado ni surgido de la nada: representa la convergencia de avances acumulados en computación, matemáticas, lingüística, aprendizaje automático y arquitectura de redes neuronales.
Este recorrido permite además situar la inteligencia artificial en una perspectiva más amplia. La disciplina no consiste en construir una copia electrónica de la mente humana ni puede reducirse a una única técnica. Es un campo heterogéneo que reúne métodos destinados a resolver problemas mediante sistemas computacionales capaces de analizar información, encontrar regularidades, realizar inferencias, adaptarse a ejemplos o producir resultados nuevos. Algunas aplicaciones son muy específicas y funcionan dentro de dominios estrechamente definidos; otras reúnen capacidades diversas y pueden enfrentarse a tareas considerablemente más abiertas. Compararlas directamente con la inteligencia humana puede resultar útil para formular determinadas preguntas, pero también puede inducir a confusión si se olvida que ambas funcionan de maneras profundamente diferentes. Una máquina puede superar ampliamente a una persona en ciertas operaciones y, al mismo tiempo, carecer de muchas de las capacidades que utilizamos de manera espontánea para interpretar una situación cotidiana.
Esta primera aproximación seguirá precisamente el camino que conduce desde las raíces intelectuales de la computación hasta las máquinas capaces de aprender y trabajar con el lenguaje. El propósito no será elaborar un catálogo de aplicaciones actuales, ni adelantar los debates sociales, éticos y culturales que plantea la inteligencia artificial generativa, sino comprender los fundamentos que permiten explicar su existencia. Los primeros intentos de mecanizar el cálculo y el razonamiento, las preguntas formuladas por Alan Turing, el nacimiento de la inteligencia artificial como disciplina científica, el predominio inicial de los sistemas simbólicos, sus crisis posteriores y el desarrollo del aprendizaje automático forman parte de una misma historia. Redes neuronales, aprendizaje profundo, reconocimiento de imágenes y procesamiento del lenguaje prolongaron después esa trayectoria hasta desembocar en los grandes modelos contemporáneos. Comprender ese proceso ayuda a contemplar la inteligencia artificial actual con una perspectiva más serena: no como una aparición súbita ni como una máquina misteriosa dotada de capacidades inexplicables, sino como el resultado provisional de una larga construcción científica y tecnológica en la que cada avance abrió nuevas posibilidades y, al mismo tiempo, nuevas preguntas.
La inteligencia artificial ha dejado de ser una expresión reservada a laboratorios, universidades o relatos de ciencia ficción para convertirse en una presencia habitual en la vida cotidiana. Aparece cuando un teléfono reconoce una voz, cuando una plataforma recomienda una película, cuando un sistema detecta patrones en una imagen médica, cuando un programa traduce un texto o cuando una herramienta conversa con nosotros y produce imágenes, música o código. Esa familiaridad, paradójicamente, no ha hecho más sencillo explicar qué es realmente la inteligencia artificial. El término se utiliza para designar tecnologías muy diferentes y, con frecuencia, se mezcla con ideas procedentes de la imaginación popular: máquinas que «piensan», programas que «comprenden» o sistemas que parecen comportarse como si poseyeran una mente propia. Antes de estudiar su historia, sus técnicas o sus aplicaciones resulta necesario aclarar el terreno y separar aquello que una máquina hace de la manera en que tendemos a describir lo que hace.
La dificultad comienza precisamente en la palabra «inteligencia». En las personas asociamos la inteligencia con capacidades muy diversas: aprender de la experiencia, resolver problemas, utilizar el lenguaje, reconocer situaciones, adaptarse, establecer relaciones entre ideas o tomar decisiones. Pero trasladar esa palabra al funcionamiento de una máquina puede resultar engañoso si suponemos que ambos tipos de actividad son equivalentes. Un sistema informático puede realizar operaciones extraordinariamente complejas y obtener resultados que parecen inteligentes sin experimentar el mundo como lo hace una persona. Puede identificar regularidades en cantidades de información imposibles de revisar manualmente, calcular probabilidades a enorme velocidad o producir una respuesta lingüística convincente, mientras que otras tareas aparentemente sencillas para un ser humano pueden seguir planteándole grandes dificultades. Comprender la inteligencia artificial requiere, por ello, abandonar tanto la tentación de humanizarla como la de reducirla a una simple calculadora sofisticada.
Una forma más útil de aproximarse al problema consiste en observar las capacidades que estos sistemas pueden desarrollar. Algunas tecnologías están diseñadas para automatizar tareas bien delimitadas; otras aprenden relaciones a partir de grandes conjuntos de ejemplos, realizan predicciones sobre información nueva o generan contenidos que no estaban almacenados previamente como una respuesta fija. Bajo el nombre de inteligencia artificial conviven así métodos destinados a clasificar, reconocer, recomendar, traducir, planificar, producir lenguaje o crear imágenes. Lo importante no es imaginar una única «inteligencia» escondida dentro de todas estas máquinas, sino comprender que existen diferentes procedimientos computacionales capaces de realizar funciones que, vistas desde fuera, pueden recordar determinadas habilidades humanas. La historia de la IA será en buena medida la historia de cómo esas capacidades fueron formuladas como problemas susceptibles de ser tratados matemáticamente y ejecutados por ordenadores.
También conviene evitar otra confusión frecuente: pensar que todos los sistemas de inteligencia artificial poseen el mismo alcance. Durante gran parte de su desarrollo, la disciplina produjo herramientas extraordinariamente especializadas, capaces de resolver problemas concretos dentro de condiciones relativamente bien definidas. Los sistemas contemporáneos de propósito más amplio han modificado parcialmente ese panorama porque pueden trabajar con tareas muy distintas y adaptarse a instrucciones expresadas en lenguaje natural, pero esa versatilidad tampoco significa que exista una inteligencia artificial universal comparable sin más con la inteligencia humana. Entre un programa concebido para detectar una anomalía concreta, un sistema de recomendación, un modelo capaz de reconocer imágenes y un asistente que procesa diferentes tipos de información existen diferencias profundas en arquitectura, entrenamiento, objetivos y capacidades. Hablar de «la IA» en singular resulta cómodo, aunque detrás de esa expresión se encuentre en realidad una familia muy extensa de técnicas y sistemas.
Esta variedad ayuda a explicar por qué la inteligencia artificial provoca simultáneamente fascinación, desconcierto y expectativas difíciles de medir. Una demostración espectacular puede producir la impresión de que una máquina domina mucho más de lo que realmente domina, mientras que sus errores recuerdan que una apariencia convincente no garantiza comprensión, exactitud ni capacidad general. Entre el entusiasmo que presenta cada avance como una transformación absoluta y el escepticismo que reduce todo a simples operaciones automáticas existe un espacio mucho más interesante: el de comprender cómo funcionan estas tecnologías, qué problemas resuelven, cuáles son sus límites y por qué determinadas capacidades han podido alcanzarse en un momento histórico concreto. Esa mirada permite estudiar la inteligencia artificial sin convertirla ni en una promesa casi mágica ni en una amenaza abstracta.
Este primer apartado servirá precisamente para construir ese vocabulario básico antes de seguir el recorrido histórico y tecnológico de la disciplina. Será necesario examinar por qué la propia expresión «inteligencia artificial» admite interpretaciones distintas, qué semejanzas y diferencias pueden establecerse con la inteligencia humana, qué significa que un sistema automatice, aprenda, prediga o genere, y cómo distinguir herramientas altamente especializadas de sistemas capaces de desenvolverse en un abanico más amplio de tareas. Sobre esa base podrá abordarse después la evolución de la IA con mayor precisión. Antes de preguntar cuándo aparecieron las primeras máquinas inteligentes o cómo llegaron a aprender a partir de datos, conviene saber exactamente de qué hablamos cuando afirmamos que una máquina realiza una tarea «inteligente».
1.1. Una expresión conocida pero difícil de definir
Pocas expresiones tecnológicas han pasado con tanta rapidez del vocabulario especializado al lenguaje cotidiano como «inteligencia artificial». Se utiliza para hablar de asistentes conversacionales, sistemas de reconocimiento de imágenes, programas que recomiendan contenidos, herramientas científicas, vehículos automatizados o aplicaciones capaces de producir textos e ilustraciones. Esa enorme variedad explica parte del problema: empleamos una sola denominación para referirnos a sistemas que pueden perseguir objetivos muy diferentes y funcionar mediante métodos también distintos. La expresión resulta intuitiva porque parece indicar de inmediato de qué estamos hablando —una inteligencia construida mediante tecnología—, pero en cuanto intentamos convertir esa intuición en una definición precisa aparecen las dificultades. No existe una propiedad única y fácilmente medible que permita observar un programa y determinar, como si se tratara de una característica física, si posee o no «inteligencia artificial». Más que designar un objeto concreto, el término identifica un amplio campo científico y tecnológico dedicado a desarrollar sistemas capaces de realizar determinadas tareas asociadas, en distintos grados, con capacidades que consideramos inteligentes.
Una primera dificultad procede de que tampoco existe una definición universalmente sencilla de inteligencia. Reconocer un rostro, comprender una frase, aprender una regularidad, resolver un problema, adaptarse a una situación nueva o elegir entre varias alternativas pueden considerarse manifestaciones de inteligencia, pero ninguna de ellas la agota por completo. Cuando estas capacidades se trasladan al ámbito informático, la cuestión se vuelve todavía más compleja. Algunas definiciones de inteligencia artificial han puesto el acento en construir máquinas que reproduzcan ciertos comportamientos humanos; otras se han interesado menos por la semejanza con las personas y más por la capacidad de resolver problemas de manera eficaz. También se ha intentado definir la disciplina a partir del razonamiento, de la toma de decisiones, de la adaptación al entorno o del cumplimiento de objetivos. Cada perspectiva ilumina una parte distinta del fenómeno y, al mismo tiempo, demuestra por qué resulta difícil encerrarlo dentro de una fórmula breve que siga siendo válida para todas las tecnologías y todas las épocas.
La propia historia de la informática ha contribuido a desplazar continuamente esas fronteras. Actividades que en determinados momentos parecían pruebas impresionantes de inteligencia —realizar cálculos complejos, jugar a determinados juegos, reconocer caracteres impresos o encontrar rutas entre numerosos itinerarios posibles— pueden terminar integrándose en tecnologías tan habituales que dejamos de percibirlas como inteligencia artificial. Cuando una capacidad se vuelve fiable, cotidiana y comprensible, tendemos a considerarla simplemente informática. Este fenómeno, denominado a veces «efecto IA», muestra que nuestra percepción de lo que merece ser llamado inteligente también cambia con el progreso tecnológico. La frontera se desplaza hacia problemas todavía no resueltos, y aquello que ayer parecía extraordinario pasa a convertirse en una función ordinaria de un programa o de un dispositivo. Por eso una definición basada únicamente en aquello que sorprende a una determinada generación estaría condenada a envejecer muy rápidamente.
Resulta más útil entender la inteligencia artificial como una disciplina que construye modelos y procedimientos computacionales capaces de tratar problemas para los que no siempre resulta suficiente especificar de antemano una secuencia rígida de instrucciones aplicable a todos los casos posibles. Esto no significa que todo sistema de IA funcione de la misma manera ni que deba poseer todas las capacidades que asociamos con la inteligencia. Un programa puede estar diseñado para realizar una tarea muy concreta y continuar formando parte legítimamente de este campo. Lo decisivo es estudiar qué información recibe, cómo la representa y procesa, qué tipo de resultado produce y mediante qué mecanismos consigue responder adecuadamente a situaciones diferentes. Esta perspectiva evita convertir la inteligencia artificial en una cualidad misteriosa que una máquina «tiene» o «no tiene» y permite analizarla como un conjunto de métodos, arquitecturas y objetivos susceptibles de investigación científica.
Existe además una diferencia importante entre describir el funcionamiento de un sistema y utilizar el lenguaje cotidiano para hablar de él. Decimos que una máquina «ve», «entiende», «decide» o «aprende» porque esas palabras permiten comunicar de manera sencilla lo que observamos desde fuera, pero deben emplearse con cuidado. En informática poseen con frecuencia un sentido operacional: indican que un sistema puede procesar imágenes, relacionar elementos lingüísticos, seleccionar una opción o modificar determinados parámetros a partir de información disponible. Las palabras son similares a las utilizadas para describir actividades humanas, aunque los procesos subyacentes no tienen por qué ser equivalentes. Mantener esta distinción será fundamental para estudiar la IA con precisión, porque evita tanto atribuir a las máquinas capacidades que no se han demostrado como negar el valor de funciones computacionales que pueden ser extraordinariamente complejas y útiles.
Por ello, quizá la mejor forma de comenzar a comprender la inteligencia artificial no sea buscar una frase definitiva, sino reconocer qué intenta abarcar el concepto y por qué sus límites permanecen abiertos. Se trata de un campo que cambia a medida que aparecen nuevos métodos, aumentan las capacidades de cálculo y surgen problemas que antes parecían inaccesibles para las máquinas. Sus definiciones han evolucionado junto con la propia disciplina y probablemente continuarán haciéndolo. Esta flexibilidad no convierte a la inteligencia artificial en una expresión vacía; obliga, más bien, a utilizarla con precisión y a preguntar siempre de qué capacidad, método o sistema estamos hablando. A partir de esa cautela conceptual será posible abordar una cuestión todavía más delicada: qué relación existe realmente entre aquello que denominamos inteligencia en los seres humanos y las capacidades que atribuimos a una máquina.
¿Qué entendemos por inteligencia artificial?. Una representación visual de la pregunta central que acompaña a la inteligencia artificial desde sus orígenes: qué significa atribuir inteligencia a una máquina.
Bajo el término inteligencia artificial se agrupan técnicas y sistemas muy distintos, desde programas especializados en clasificación y reconocimiento hasta modelos capaces de trabajar con lenguaje, imágenes o grandes conjuntos de datos. Su diversidad hace difícil establecer una única definición y obliga a distinguir entre automatización, aprendizaje, predicción y generación, así como entre capacidades humanas y procesos realizados mediante sistemas artificiales.
1.2. Inteligencia humana e inteligencia artificial
Comparar la inteligencia humana con la inteligencia artificial resulta casi inevitable, porque buena parte del vocabulario con el que describimos estas tecnologías procede de capacidades que conocemos primero en nosotros mismos. Hablamos de aprender, reconocer, recordar, razonar, decidir o comprender, y utilizamos esas mismas palabras para explicar lo que hace una máquina. La semejanza lingüística puede ser útil, pero también induce a pensar que ambos tipos de inteligencia funcionan de una manera comparable. La inteligencia humana es el resultado de un organismo vivo, de una historia evolutiva y de una experiencia individual que integra percepción, memoria, emociones, lenguaje, cuerpo, relaciones sociales y aprendizaje continuo. Una inteligencia artificial, en cambio, es un sistema construido para procesar información mediante procedimientos computacionales. Puede alcanzar resultados extraordinarios en determinadas tareas, pero esos resultados no implican que reproduzca el conjunto de procesos mediante los cuales una persona percibe, interpreta y actúa en el mundo.
La inteligencia humana posee además una notable capacidad para desenvolverse en situaciones abiertas y cambiantes. Una persona puede utilizar conocimientos adquiridos en un ámbito para resolver problemas diferentes, comprender una ironía, interpretar el estado de ánimo de otra persona, modificar un plan cuando aparecen circunstancias inesperadas o aprender a partir de muy pocos ejemplos. Gran parte de estas operaciones se apoya en una experiencia acumulada que no suele presentarse como una base de datos ordenada: aprendemos mientras vivimos, nos movemos, conversamos, observamos y nos relacionamos con un entorno físico y social. Buena parte de ese conocimiento es implícito. Sabemos, por ejemplo, que un vaso puede romperse si cae, que una promesa crea una expectativa o que una frase puede significar algo diferente según el contexto, sin necesidad de reconstruir conscientemente todas las reglas que sustentan esas conclusiones. Esa combinación de conocimientos explícitos e implícitos constituye una de las razones por las que muchas actividades aparentemente sencillas han resultado difíciles de trasladar a las máquinas.
Los sistemas de inteligencia artificial funcionan de otro modo. Sus capacidades dependen del diseño del sistema, de los métodos empleados, de la información con la que trabajan y, en muchos casos, del proceso mediante el cual ajustan una gran cantidad de parámetros. Pueden analizar volúmenes de datos muy superiores a los que una persona podría revisar, detectar regularidades difíciles de apreciar manualmente o ejecutar determinadas operaciones con enorme rapidez y precisión. En dominios concretos, una máquina puede superar ampliamente las capacidades humanas sin que ello implique poseer una inteligencia general superior. Una calculadora realiza operaciones aritméticas a una velocidad imposible para una persona, y un sistema especializado puede examinar millones de posiciones de un juego o comparar enormes cantidades de información, pero esa ventaja permanece vinculada al tipo de problema para el que ha sido construido. La comparación entre humanos y máquinas pierde sentido cuando se plantea como una competición global y resulta mucho más esclarecedora cuando se pregunta qué clase de capacidades posee cada uno y bajo qué condiciones funcionan.
La diferencia se hace especialmente visible ante situaciones nuevas o ambiguas. Las personas recurren constantemente al contexto, a conocimientos del mundo, a intenciones, expectativas y experiencias previas para interpretar lo que sucede. Los sistemas artificiales también pueden utilizar contexto y generalizar a partir de patrones aprendidos, pero su funcionamiento depende de representaciones computacionales y de relaciones extraídas de los datos o incorporadas mediante su diseño. Por ello, una respuesta aparentemente sofisticada puede convivir con un error sorprendente. No existe contradicción: una máquina puede manejar con enorme eficacia ciertas estructuras y, al mismo tiempo, carecer de la experiencia cotidiana que permite a una persona detectar inmediatamente que algo no encaja. Esta asimetría ayuda a comprender por qué medir la inteligencia artificial únicamente por la capacidad de imitar comportamientos humanos puede ofrecer una visión incompleta de sus verdaderas fortalezas y limitaciones.
También conviene distinguir inteligencia de conciencia, una confusión frecuente cuando las máquinas producen comportamientos cada vez más convincentes. Resolver problemas, generar lenguaje o reconocer imágenes no demuestra por sí mismo la existencia de experiencia subjetiva, sentimientos o conciencia de uno mismo. Son cuestiones conceptualmente diferentes. La inteligencia puede estudiarse a través de capacidades observables y de mecanismos de procesamiento de información, mientras que la conciencia plantea problemas filosóficos y científicos de otra naturaleza. Atribuir automáticamente estados mentales humanos a un sistema porque conversa de manera fluida supone pasar de lo que efectivamente hace la tecnología a una interpretación que necesita argumentos adicionales. De igual modo, negar que exista alguna forma de capacidad computacional relevante simplemente porque no funciona como una mente humana impediría comprender el alcance real de estas herramientas.
La relación más interesante entre inteligencia humana e inteligencia artificial aparece, por ello, no en la búsqueda de una equivalencia perfecta, sino en sus diferencias y complementariedades. Las máquinas pueden ampliar determinadas capacidades humanas: analizar información, detectar patrones, automatizar operaciones o explorar rápidamente numerosas posibilidades. Las personas aportan experiencia vital, objetivos, interpretación social, responsabilidad, criterio y una comprensión del mundo construida desde la interacción con otros seres humanos y con el entorno. Estudiar ambas formas de resolver problemas permite evitar dos simplificaciones opuestas: imaginar la inteligencia artificial como una réplica digital de la mente humana o considerarla únicamente una automatización trivial. Entre ambos extremos aparece un campo mucho más fértil: sistemas capaces de realizar operaciones que asociamos con la inteligencia, pero mediante mecanismos propios, cuyas posibilidades se entienden mejor cuando dejamos de preguntar si una máquina “piensa como nosotros” y comenzamos a examinar qué puede hacer realmente, cómo lo consigue y cuáles son los límites de esa capacidad.
1.3. Automatizar, aprender, predecir y generar
Buena parte de la confusión en torno a la inteligencia artificial desaparece cuando dejamos de pensar en ella como una cualidad abstracta y observamos qué tipo de operaciones realizan realmente los sistemas. Cuatro verbos permiten ordenar una parte importante de ese panorama: automatizar, aprender, predecir y generar. No son equivalentes ni describen siempre la misma clase de tecnología, pero juntos ayudan a entender cómo ha evolucionado la informática desde programas que ejecutaban instrucciones previamente definidas hasta sistemas capaces de ajustar su comportamiento a partir de datos y producir resultados nuevos. Esta distinción resulta especialmente útil porque muchas aplicaciones actuales combinan varias de estas funciones dentro de un mismo proceso. Un sistema puede automatizar una tarea utilizando un modelo que ha aprendido previamente de numerosos ejemplos, emplear ese aprendizaje para realizar una predicción y convertir después esa predicción en una respuesta, una imagen o una secuencia de acciones. Lo que desde fuera parece una única operación inteligente suele ser, en realidad, la combinación organizada de varios mecanismos diferentes.
Automatizar significa hacer que una máquina ejecute una tarea con poca o ninguna intervención humana durante su funcionamiento normal. La automatización es mucho más antigua que la inteligencia artificial y no debe confundirse con ella. Un temporizador que enciende una calefacción a una hora determinada, una hoja de cálculo que aplica una fórmula o un programa que ordena automáticamente una lista realizan tareas automatizadas sin necesidad de aprender nada. En estos casos, el comportamiento ha sido definido de antemano mediante reglas claras: si ocurre una determinada condición, el sistema ejecuta una acción prevista. La inteligencia artificial puede utilizarse para automatizar procesos mucho más difíciles de describir mediante reglas exhaustivas, como clasificar fotografías, detectar mensajes no deseados o interpretar lenguaje natural. La diferencia esencial no está en que la máquina actúe por sí sola, sino en cómo se obtiene el criterio que guía esa actuación. En una automatización tradicional, ese criterio suele estar programado explícitamente; en numerosos sistemas de IA, se deriva en parte de patrones aprendidos a partir de datos.
Aprender, dentro de este contexto, tampoco significa aprender como lo hace una persona. En aprendizaje automático, un sistema modifica determinados parámetros internos para mejorar su rendimiento en una tarea según la información utilizada durante el entrenamiento. En lugar de escribir manualmente todas las reglas necesarias para distinguir un correo legítimo de uno fraudulento, por ejemplo, pueden proporcionarse numerosos casos y emplear un procedimiento matemático que detecte regularidades útiles para realizar esa clasificación. El sistema no memoriza necesariamente una respuesta exacta para cada situación posible, sino que intenta construir una representación que le permita enfrentarse también a ejemplos nuevos. Este proceso constituye uno de los cambios más importantes en la historia reciente de la inteligencia artificial: el conocimiento operativo de la máquina ya no tiene que introducirse siempre en forma de instrucciones detalladas, sino que puede emerger del ajuste progresivo del modelo frente a grandes conjuntos de ejemplos. La calidad de ese aprendizaje dependerá, entre otros factores, de los datos, del método utilizado y de la capacidad del sistema para generalizar más allá de los casos empleados durante el entrenamiento.
Predecir consiste en utilizar las regularidades aprendidas para estimar un resultado a partir de nueva información. La palabra puede sugerir acontecimientos futuros, pero en inteligencia artificial posee un significado más amplio. Un modelo puede predecir si una imagen pertenece a una categoría, qué palabra es probable que aparezca después de otra, cuál de varias opciones se ajusta mejor a unos datos o qué contenido puede interesar a un usuario. En todos estos casos se produce una estimación basada en relaciones extraídas previamente. Muchas aplicaciones que parecen reconocer, clasificar o recomendar pueden entenderse desde esta perspectiva predictiva. La predicción no equivale a certeza: un sistema calcula o estima cuál es la respuesta más plausible según su modelo y la información disponible. Por ello, incluso un sistema muy preciso puede equivocarse, especialmente cuando recibe casos muy diferentes de aquellos con los que fue entrenado o cuando los datos contienen errores, desequilibrios o relaciones poco representativas de la realidad.
Generar representa un paso diferente, aunque profundamente conectado con la predicción. Un sistema generativo no se limita a asignar una etiqueta o elegir entre opciones previamente establecidas, sino que construye una salida nueva siguiendo patrones aprendidos: puede producir un texto, una imagen, una melodía, código informático o determinados tipos de datos sintéticos. «Nuevo» no significa creado desde la nada ni implica necesariamente originalidad en el sentido humano. El modelo trabaja a partir de estructuras estadísticas, relaciones y regularidades obtenidas durante su entrenamiento, y las utiliza para elaborar combinaciones que no tienen por qué haber aparecido exactamente de esa forma con anterioridad. En los modelos de lenguaje, por ejemplo, la generación se apoya en una sucesión de predicciones acerca de qué elementos resultan adecuados dentro de un contexto. En sistemas de imagen, otros procedimientos permiten transformar representaciones aprendidas en composiciones visuales coherentes con una instrucción. La generación, por tanto, no sustituye a la predicción: con frecuencia surge precisamente de procesos predictivos repetidos y organizados de manera que producen una salida compleja.
Estos cuatro conceptos permiten observar una continuidad importante en el desarrollo de la inteligencia artificial. Automatizar libera determinadas tareas de una ejecución manual; aprender permite obtener criterios de funcionamiento a partir de ejemplos; predecir utiliza esos criterios para responder ante información nueva; generar emplea modelos aprendidos para construir resultados que no estaban preparados de antemano como respuestas fijas. Una aplicación concreta puede contener solo una de estas funciones o combinarlas en diferentes grados, y ninguna de ellas basta por sí sola para definir toda la inteligencia artificial. Su importancia reside en mostrar que detrás de expresiones aparentemente extraordinarias existen operaciones que pueden analizarse con precisión. Comprender esta diferencia será esencial para distinguir, en el siguiente paso, entre sistemas diseñados para resolver problemas muy específicos y otros capaces de desenvolverse en una gama mucho más amplia de tareas.
1.4. Inteligencia artificial específica y sistemas de propósito general
Durante décadas, la mayor parte de la inteligencia artificial se desarrolló alrededor de problemas muy concretos. Un sistema podía aprender a reconocer determinados objetos, jugar a un juego, detectar anomalías en una señal, recomendar contenidos o clasificar documentos, pero esa competencia no implicaba que pudiera trasladarse con facilidad a tareas completamente distintas. Esta forma de inteligencia artificial suele describirse como específica, estrecha o especializada: está concebida para desenvolverse dentro de un dominio determinado y optimizada para resolver una clase limitada de problemas. Su eficacia puede ser extraordinaria y, en algunos casos, superar ampliamente el rendimiento humano en la tarea para la que ha sido diseñada, pero fuera de ese marco sus capacidades pueden disminuir de manera drástica. La especialización no debe interpretarse como una limitación menor ni como una etapa inferior de la tecnología. De hecho, numerosos sistemas utilizados en ciencia, industria, medicina, finanzas o comunicaciones son valiosos precisamente porque concentran su funcionamiento en objetivos bien definidos y pueden alcanzar una gran precisión dentro de ellos.
La inteligencia artificial específica adopta formas muy diferentes. Un programa destinado a detectar defectos en una cadena de producción no necesita conversar sobre historia; un sistema de navegación no requiere escribir poesía; un modelo dedicado a identificar determinadas estructuras en imágenes científicas puede ser extremadamente avanzado sin poseer ninguna capacidad relevante fuera de ese ámbito. Esta separación entre competencias recuerda que hablar de «inteligencia» no significa necesariamente disponer de una facultad general aplicable a cualquier situación. En ingeniería, restringir un sistema puede incluso ofrecer ventajas importantes: permite delimitar mejor sus objetivos, controlar sus condiciones de uso, evaluar su rendimiento con criterios claros y reducir la complejidad de aquello que debe aprender. Buena parte de la historia de la inteligencia artificial estuvo marcada por este enfoque, en el que cada problema se abordaba mediante herramientas diseñadas específicamente para sus características.
El panorama comenzó a cambiar con el desarrollo de modelos entrenados sobre conjuntos de datos mucho más amplios y diversos. En lugar de construir un sistema desde cero para cada tarea, empezó a ser posible desarrollar modelos capaces de adquirir representaciones útiles para múltiples aplicaciones y adaptarse posteriormente a objetivos diferentes. Esta transformación dio lugar a lo que hoy suele describirse como sistemas o modelos de propósito general. Su rasgo distintivo no es que puedan hacer literalmente cualquier cosa, sino que una misma base tecnológica puede utilizarse para tareas variadas sin necesidad de diseñar un modelo independiente para cada una. Un sistema puede trabajar con preguntas, resúmenes, clasificación de textos, traducción, generación de contenidos o análisis de documentos a partir de una arquitectura común y de un entrenamiento suficientemente amplio. En algunos casos, además, puede combinar diferentes tipos de información, lo que amplía todavía más su versatilidad.
La expresión «propósito general» debe emplearse, sin embargo, con cierta precisión. No equivale automáticamente a inteligencia artificial general, ni implica que el sistema posea todas las capacidades cognitivas humanas o pueda desenvolverse con la misma solidez en cualquier contexto. Un modelo puede mostrar una gran flexibilidad y seguir presentando limitaciones importantes: cometer errores elementales, depender de la forma en que se formule una instrucción, perder rendimiento en situaciones poco representadas en sus datos o comportarse de manera irregular ante problemas aparentemente similares. Su amplitud funcional procede de haber aprendido regularidades transferibles entre numerosas tareas, no de haber alcanzado necesariamente una comprensión universal del mundo. Esta diferencia resulta esencial para evitar que la expansión de capacidades se confunda con una inteligencia ilimitada.
La transición desde sistemas especializados hacia modelos más generales también modifica la manera de diseñar y utilizar la inteligencia artificial. En el enfoque tradicional, el desarrollador podía construir una herramienta para un objetivo muy delimitado y entrenarla específicamente para cumplirlo. En los sistemas de propósito general, un mismo modelo puede actuar como una infraestructura sobre la que se construyen numerosas aplicaciones posteriores. Esto permite reutilizar capacidades adquiridas previamente, reducir la necesidad de crear soluciones completamente independientes y adaptar la tecnología mediante instrucciones, ajustes adicionales o herramientas externas. Al mismo tiempo, aumenta la dificultad de prever todos los contextos en los que el sistema será utilizado. Cuanto más amplio es su campo de aplicación, más complejo resulta evaluar de antemano cada posible comportamiento, error o uso inesperado.
La distinción entre inteligencia específica y propósito general no establece, por tanto, dos categorías absolutamente separadas, sino un continuo de capacidades. Existen sistemas extremadamente estrechos, otros que combinan varias funciones relacionadas y modelos capaces de desenvolverse en dominios muy distintos. La dirección general del desarrollo reciente ha ampliado esa versatilidad, pero la especialización continúa siendo fundamental allí donde se requiere precisión, control y conocimiento profundo de un ámbito concreto. Comprender esta diferencia permite interpretar mejor la evolución de la inteligencia artificial: no como una marcha lineal desde máquinas «menos inteligentes» hacia otras «más inteligentes», sino como una diversificación entre herramientas especializadas y plataformas capaces de reutilizar conocimientos y capacidades en tareas cada vez más variadas. Esa expansión explica parte de la fascinación actual por la IA, pero también obliga a analizar con mayor cuidado qué significa realmente que un sistema parezca competente en muchos terrenos distintos.
1.5. Entre la fascinación tecnológica y la comprensión científica
La inteligencia artificial ocupa hoy un lugar extraño en la cultura contemporánea: es al mismo tiempo una herramienta técnica, un campo científico, una promesa económica, un motivo de inquietud y una poderosa fuente de imaginación. Pocas tecnologías recientes han adquirido una presencia pública tan intensa en tan poco tiempo. Cada avance importante puede provocar titulares grandilocuentes, expectativas desmesuradas o temores igualmente exagerados, como si cada nueva capacidad anunciara de inmediato una transformación total de la sociedad. Parte de esa reacción resulta comprensible. Cuando una máquina produce un texto coherente, reconoce una imagen, compone una melodía o responde a una pregunta compleja, el resultado puede parecer sorprendente porque se aproxima a actividades que durante mucho tiempo consideramos profundamente humanas. La fascinación surge precisamente en esa frontera entre lo familiar y lo inesperado: reconocemos la tarea, pero no estamos acostumbrados a que una máquina la realice con tanta soltura.
Sin embargo, el asombro puede convertirse fácilmente en una barrera para comprender. Cuando una tecnología produce resultados impresionantes, existe una tendencia natural a atribuirle más capacidades de las que realmente posee. Una respuesta convincente puede interpretarse como comprensión profunda; una imagen bien construida, como imaginación; una predicción acertada, como conocimiento del futuro. El lenguaje cotidiano refuerza esa impresión porque hablamos de máquinas que «aprenden», «entienden», «deciden» o «crean». Estas expresiones pueden ser útiles si se entienden como abreviaturas funcionales, pero se vuelven problemáticas cuando pasan a describir propiedades que no han sido demostradas. La comprensión científica exige separar cuidadosamente el efecto producido en el observador del mecanismo que lo hace posible. Un sistema puede generar una conducta sorprendente sin funcionar como una mente humana, del mismo modo que un avión puede volar sin reproducir la anatomía de un ave. El resultado puede ser comparable en algún aspecto, mientras que el proceso que lo produce es radicalmente diferente.
En el extremo contrario aparece otra simplificación: considerar que, puesto que una máquina opera mediante cálculos, todo lo que hace carece de interés y puede reducirse a una ejecución mecánica trivial. Esta postura tampoco ayuda a entender la inteligencia artificial. Que un sistema funcione mediante operaciones matemáticas no significa que sus capacidades sean simples ni que los problemas resueltos sean menores. Reconocer patrones en enormes conjuntos de datos, representar relaciones complejas, adaptarse a ejemplos o generar resultados coherentes a partir de múltiples variables requiere métodos sofisticados y décadas de investigación acumulada. La ciencia no pierde valor cuando descubre el mecanismo que explica un fenómeno; ocurre justamente lo contrario. Comprender cómo funciona una tecnología permite apreciar mejor su dificultad real, distinguir sus logros de las interpretaciones exageradas y evaluar con mayor precisión aquello que todavía no puede hacer.
La inteligencia artificial necesita, por tanto, una mirada doble: suficientemente abierta para reconocer la importancia de sus avances y suficientemente crítica para no confundirlos con capacidades que pertenecen a otro nivel de explicación. Esa actitud científica no consiste en minimizar los logros ni en celebrarlos sin reservas, sino en formular preguntas concretas. ¿Qué problema resuelve el sistema? ¿Con qué información trabaja? ¿Cómo se ha entrenado? ¿En qué condiciones funciona bien? ¿Qué tipo de errores comete? ¿Hasta dónde puede trasladar lo aprendido a situaciones diferentes? Estas preguntas desplazan la atención desde una idea abstracta de «máquina inteligente» hacia propiedades observables y analizables. También permiten comparar sistemas distintos sin recurrir a impresiones subjetivas. Una tecnología puede ser extraordinariamente competente en una tarea y muy limitada en otra; puede producir resultados útiles y, al mismo tiempo, requerir supervisión; puede ampliar capacidades humanas sin sustituir el juicio de las personas que la emplean.
Esta forma de aproximarse a la IA resulta especialmente necesaria porque la tecnología evoluciona con rapidez y sus manifestaciones visibles cambian constantemente. Las aplicaciones que hoy parecen nuevas pueden integrarse mañana en herramientas ordinarias y dejar de producir sorpresa. Lo que permanece es la necesidad de comprender los principios que hay detrás de ellas. Una perspectiva histórica y científica ayuda a evitar la ilusión de que cada generación tecnológica surge de manera repentina. Los sistemas actuales son el resultado de una larga acumulación de ideas sobre lógica, cálculo, representación del conocimiento, aprendizaje, estadística y computación. Sus capacidades no aparecieron por una especie de salto inexplicable, sino mediante una sucesión de problemas resueltos parcialmente, enfoques abandonados, métodos recuperados y mejoras técnicas que terminaron convergiendo.
Situarse entre la fascinación y la comprensión significa, en última instancia, conservar la curiosidad sin renunciar al análisis. La inteligencia artificial merece atención precisamente porque es una tecnología poderosa y conceptualmente rica, no porque deba envolverse en misterio. El asombro puede ser un buen punto de partida, pero no debe sustituir al conocimiento. Para entender cómo hemos llegado a sistemas capaces de aprender, reconocer patrones y trabajar con lenguaje, será necesario retroceder mucho antes de los modelos contemporáneos y examinar una historia más larga: la de las máquinas, la lógica, el cálculo y el antiguo deseo de convertir determinadas formas de razonamiento en procedimientos que pudieran ser ejecutados de manera automática.
Mucho antes de que existieran ordenadores, redes neuronales o programas capaces de aprender, ya estaba presente una idea que terminaría siendo decisiva: algunas actividades humanas podían descomponerse en una sucesión ordenada de operaciones y, quizá, ser ejecutadas por un mecanismo. El camino hacia la inteligencia artificial comenzó así lejos de los laboratorios informáticos del siglo XX. Sus raíces se encuentran en una historia mucho más antigua, formada por máquinas que imitaban movimientos de seres vivos, instrumentos concebidos para realizar cálculos, intentos de expresar el razonamiento mediante reglas y proyectos destinados a separar una operación intelectual de la persona que la ejecutaba. Ninguno de aquellos inventos era inteligencia artificial en el sentido actual, pero todos contribuyeron a transformar una pregunta aparentemente fantástica —¿puede una máquina realizar por sí misma una actividad compleja?— en un problema cada vez más preciso de ingeniería, matemáticas y lógica.
Los autómatas constituyen una de las expresiones más visibles de esa aspiración. Desde mecanismos hidráulicos y figuras móviles de la Antigüedad hasta sofisticados ingenios mecánicos construidos siglos después, distintas culturas crearon artefactos capaces de ejecutar secuencias de movimientos sin una intervención humana continua. Su importancia para esta historia no reside en atribuirles una inteligencia que evidentemente no poseían, sino en algo más elemental: demostraban que una conducta aparentemente autónoma podía surgir de la organización adecuada de piezas, energía y mecanismos de control. Un pájaro artificial podía mover las alas, una figura podía escribir o un reloj astronómico reproducir ciclos celestes mediante procesos físicos cuidadosamente diseñados. La máquina comenzaba a mostrar que la complejidad visible no tenía por qué depender de una acción humana realizada paso a paso en cada momento.
Junto a la tradición mecánica fue desarrollándose otra transformación menos espectacular visualmente, pero mucho más profunda: la progresiva formalización del cálculo y del razonamiento. Si una operación puede expresarse mediante reglas claras, se abre la posibilidad de que esas reglas sean ejecutadas de manera sistemática. La matemática moderna avanzó precisamente mediante la creación de lenguajes simbólicos capaces de representar relaciones abstractas sin depender exclusivamente de la intuición. En ese contexto surgió el proyecto intelectual de convertir ciertas formas de razonamiento en procedimientos manipulables. Gottfried Wilhelm Leibniz llevó esta ambición particularmente lejos al imaginar formas de cálculo que no se limitaran a las cantidades, sino que pudieran intervenir también en la resolución lógica de controversias. La aspiración era extraordinaria: que parte del razonamiento pudiera expresarse de manera suficientemente precisa como para ser sometida a reglas de cálculo.
Durante el siglo XIX, la mecanización del cálculo adquirió una dimensión nueva con los proyectos de Charles Babbage. Sus máquinas ya no pertenecían únicamente al mundo de los mecanismos concebidos para ejecutar una única secuencia fija, sino que introducían elementos que anticipaban principios esenciales de la computación. La Máquina Analítica, aunque nunca llegó a construirse completamente en vida de Babbage, fue concebida con una arquitectura capaz de ejecutar distintas operaciones siguiendo instrucciones. Esa separación entre el mecanismo físico y la secuencia de órdenes que debía realizar representaba una idea decisiva: una misma máquina podía servir para propósitos diferentes si era posible modificar el procedimiento que gobernaba su funcionamiento. El problema dejaba de ser únicamente fabricar una máquina capaz de hacer algo y comenzaba a convertirse en el de especificar formalmente qué debía hacer.
Ada Lovelace percibió una consecuencia todavía más profunda de aquella concepción. Si una máquina podía operar siguiendo reglas sobre entidades representadas mediante símbolos, su ámbito potencial no tenía por qué limitarse estrictamente a la aritmética. Siempre que determinados elementos pudieran expresarse de una forma adecuada y someterse a relaciones formales, una máquina podría en principio manipularlos conforme a instrucciones. Esta intuición ensanchaba enormemente el horizonte de la computación: las máquinas podían convertirse en instrumentos para procesar representaciones, no simplemente en calculadoras mecánicas. El paso conceptual era enorme porque acercaba dos mundos que hoy parecen inseparables —información y máquina—, aunque todavía faltaran muchas décadas para disponer de la electrónica necesaria para convertir esa idea en una tecnología práctica.
A finales del siglo XIX y comienzos del XX, la lógica matemática, la teoría de los algoritmos y el estudio de los fundamentos de las matemáticas profundizarían ese cambio. El interés ya no se centraba únicamente en resolver problemas particulares, sino en determinar qué significa realmente seguir un procedimiento, demostrar una proposición o realizar una operación de forma completamente definida. De ese esfuerzo surgirían conceptos indispensables para la futura ciencia de la computación. La inteligencia artificial heredaría mucho más tarde ese territorio intelectual: máquinas capaces de actuar automáticamente, símbolos susceptibles de manipulación, instrucciones expresadas con precisión y problemas convertidos en procedimientos ejecutables. Antes de preguntar si una máquina podía ser inteligente, había sido necesario descubrir algo más básico y quizá más revolucionario: que una parte del cálculo, del razonamiento formal y del tratamiento de la información podía desprenderse de la mente que lo realizaba y convertirse en una secuencia de operaciones que una máquina fuese capaz de ejecutar.
2.1. El antiguo sueño de construir máquinas capaces de actuar por sí mismas
La idea de fabricar seres artificiales capaces de moverse, obedecer órdenes o realizar tareas sin intervención humana constante es muy anterior a la ciencia moderna. Mucho antes de que existieran motores eléctricos, dispositivos electrónicos o programas informáticos, distintas sociedades imaginaron objetos animados y mecanismos que parecían poseer una actividad propia. En los relatos míticos de la Antigüedad aparecen estatuas que cobran vida, guardianes artificiales y criaturas construidas por artesanos divinos; en tradiciones posteriores vuelven a encontrarse figuras semejantes bajo formas diferentes. Estos relatos no constituyen antecedentes tecnológicos directos de la inteligencia artificial, pero muestran algo importante: la posibilidad de crear artificialmente una entidad capaz de actuar ha acompañado durante siglos a la imaginación humana. La máquina autónoma fue primero una aspiración cultural mucho antes de convertirse en un problema de ingeniería.
Detrás de esa imaginación existía una pregunta profunda acerca de la relación entre apariencia y mecanismo. Un ser vivo se mueve sin que podamos observar desde fuera todas las causas de sus acciones; un objeto fabricado, en cambio, parece necesitar que alguien lo empuje, lo maneje o lo dirija. Construir una máquina capaz de ejecutar una secuencia por sí misma alteraba esa experiencia intuitiva. El movimiento podía almacenarse, por así decirlo, dentro de la organización del mecanismo: pesos, engranajes, agua, aire comprimido, resortes o sistemas semejantes podían producir comportamientos previstos después de que el constructor hubiera dejado de intervenir. La autonomía era todavía limitada y completamente determinada por la estructura física del artefacto, pero introducía una idea que acabaría teniendo enorme importancia: el comportamiento visible de una máquina podía depender de una organización interna diseñada de antemano.
Con el tiempo, ese deseo de reproducir acciones dejó de limitarse al movimiento. Las máquinas podían imaginarse como instrumentos capaces de ejecutar secuencias ordenadas, regular procesos o responder de manera diferente según determinadas condiciones. Esta posibilidad fue especialmente importante porque obligaba a descomponer una actividad compleja en operaciones elementales. Para que una máquina pudiera realizar una tarea, el constructor debía preguntarse qué pasos la componían, en qué orden tenían que ejecutarse y mediante qué mecanismo podía representarse cada uno. De manera todavía rudimentaria aparecía así una forma de pensamiento que siglos más tarde sería esencial para la computación: transformar una acción en un procedimiento. La máquina no necesitaba conocer el propósito general de la tarea; bastaba con que estuviera organizada de manera que cada etapa condujera correctamente a la siguiente.
Esta concepción fue modificando también la imagen de la propia máquina. Un mecanismo dejó de ser únicamente una herramienta que multiplicaba la fuerza humana y comenzó a concebirse como un dispositivo capaz de organizar acciones. Una palanca, una rueda o una polea ayudan físicamente a una persona; un mecanismo automático introduce además una secuencia temporal y un cierto grado de control. La diferencia parece pequeña, pero es conceptualmente decisiva. Cuando una máquina puede realizar una serie de operaciones sin recibir una orden humana distinta para cada movimiento, aparece la posibilidad de separar el diseño del proceso de su ejecución. El ser humano determina previamente las condiciones y el mecanismo las desarrolla después. Esta separación entre quien establece un procedimiento y aquello que lo ejecuta se convertirá, muchos siglos más tarde, en uno de los fundamentos de las máquinas programables.
También conviene evitar una interpretación retrospectiva demasiado cómoda. Aquellos sueños y primeros mecanismos no eran intentos de construir inteligencia artificial en el sentido actual, y sus creadores no disponían de nuestros conceptos de información, programa o algoritmo. Resultaría engañoso presentar una línea recta que condujera inevitablemente desde las antiguas criaturas artificiales hasta los ordenadores contemporáneos. Lo que sí puede reconocerse es una continuidad en ciertas preguntas. ¿Puede reproducirse artificialmente una función que observamos en los seres vivos? ¿Puede una máquina ejecutar por sí misma una secuencia compleja? ¿Es posible incorporar instrucciones a un mecanismo? ¿Hasta dónde puede llegar una acción automática antes de necesitar nuevamente la intervención humana? Cada época respondió con los recursos intelectuales y técnicos que tenía disponibles, y esas respuestas fueron ensanchando gradualmente lo que podía imaginarse y construirse.
El antiguo sueño de la máquina autónoma es importante, por tanto, menos por las semejanzas superficiales con nuestras tecnologías actuales que por el cambio intelectual que representa. Fabricar un artefacto capaz de actuar significaba admitir que determinadas conductas podían analizarse, reproducirse y organizarse mediante mecanismos. Primero se trató fundamentalmente de movimiento y secuencias físicas; más adelante el mismo principio se extendería al cálculo, a la manipulación de símbolos y finalmente al procesamiento de información. Entre una figura mecánica que repite una secuencia y un sistema moderno capaz de aprender existen diferencias inmensas, pero ambos pertenecen a una historia más amplia: la búsqueda de medios para trasladar a una construcción artificial una actividad que antes requería la presencia continua de un ser humano. Los autómatas históricos convertirían esa aspiración en algunos de sus ejemplos más espectaculares y permitirían comprobar, mucho antes de la era informática, hasta dónde podía llegar el ingenio mecánico.
2.2. Autómatas y antecedentes históricos
Los autómatas constituyen uno de los capítulos más sugestivos de la historia de la técnica porque hicieron visible, mucho antes de la computación, una idea decisiva: una máquina podía ejecutar una secuencia compleja de acciones sin que una persona tuviera que dirigir cada movimiento. En la Antigüedad ya encontramos dispositivos basados en agua, aire, contrapesos y sistemas de válvulas capaces de producir efectos automáticos. Entre los nombres más conocidos se encuentra Herón de Alejandría, activo en el siglo I, cuya obra describió numerosos mecanismos neumáticos e hidráulicos, puertas que podían abrirse automáticamente y dispositivos teatrales capaces de encadenar movimientos. Estos ingenios no “pensaban” ni tomaban decisiones, pero mostraban que una serie de acciones aparentemente autónomas podía ser descompuesta, ordenada y reproducida mediante un mecanismo físico. Esa capacidad de convertir una secuencia en funcionamiento automático representa uno de los antecedentes intelectuales más importantes de la posterior mecanización del cálculo.
El interés por estos dispositivos no desapareció con el mundo antiguo. En distintas regiones de Asia y del mundo islámico continuó desarrollándose una rica tradición de ingeniería mecánica. Un caso especialmente destacado es el de al-Jazari, ingeniero de finales del siglo XII y comienzos del XIII, conocido por describir relojes, mecanismos hidráulicos, fuentes automáticas y figuras móviles. Algunos de sus dispositivos incorporaban sistemas de control mediante flotadores, levas y válvulas, y permitían modificar ciertos comportamientos ajustando componentes mecánicos. Estos ejemplos son importantes porque muestran que la automatización no fue una invención súbita de la Europa moderna, sino el resultado de una historia técnica amplia y geográficamente diversa. A medida que relojería, hidráulica y mecánica se perfeccionaban, los constructores aprendían a coordinar movimientos cada vez más complejos y a diseñar máquinas capaces de repetir secuencias con una regularidad antes difícil de alcanzar.
Durante la Baja Edad Media y el Renacimiento, los grandes relojes astronómicos añadieron una nueva dimensión a esta tradición. No se limitaban a medir el tiempo: podían representar ciclos celestes, mover figuras, activar campanas o reproducir escenas religiosas y cívicas a determinadas horas. El mecanismo interno actuaba como una especie de coreografía material, en la que engranajes y ruedas dentadas convertían el paso del tiempo en una secuencia de acontecimientos visibles. La relojería resultó fundamental porque obligó a alcanzar una precisión cada vez mayor en la coordinación de movimientos y ofreció una imagen poderosa del mundo entendido como sistema regulado. En los siglos XVII y XVIII, esta cultura mecánica se combinó con avances en fabricación de instrumentos, dando lugar a autómatas de extraordinaria sofisticación que ya no buscaban únicamente medir o señalar, sino imitar acciones humanas y animales con un realismo creciente.
El siglo XVIII fue especialmente brillante en este terreno. Jacques de Vaucanson construyó figuras mecánicas célebres, entre ellas músicos automáticos y un pato mecánico que simulaba diversos comportamientos de un animal vivo. Más tarde, Pierre Jaquet-Droz y sus colaboradores desarrollaron autómatas como El Escritor, El Dibujante y La Música, capaces de ejecutar tareas complejas mediante mecanismos internos cuidadosamente programados en sentido mecánico. El Escritor, por ejemplo, podía trazar caracteres mediante una secuencia controlada de movimientos. Lo fascinante de estos dispositivos no estaba solo en su apariencia, sino en la manera en que una acción compleja era almacenada físicamente dentro del mecanismo. Levas, discos, ruedas y piezas móviles determinaban el orden de las operaciones. Cada gesto había sido previsto por el constructor, pero una vez puesto en marcha el autómata podía reproducirlo sin intervención continua.
Estos ingenios permiten comprender una diferencia esencial entre automatismo y aprendizaje. El autómata histórico ejecutaba una conducta predefinida; no modificaba por sí mismo sus reglas a partir de la experiencia ni construía nuevas estrategias. Su aparente autonomía procedía de la complejidad del mecanismo, no de una capacidad adaptativa. Precisamente por eso son tan útiles para entender los antecedentes de la inteligencia artificial: muestran una etapa en la que la cuestión principal consistía en reproducir una conducta mediante secuencias previamente codificadas en la estructura física de la máquina. El comportamiento podía ser sorprendente y hasta parecer “vivo”, pero seguía estando totalmente determinado por el diseño. Esta distinción ayuda a evitar anacronismos: un autómata del siglo XVIII no era un robot inteligente, aunque sí representaba un avance decisivo en la idea de que una máquina podía contener y ejecutar una serie organizada de instrucciones.
La tradición de los autómatas dejó así una herencia doble. Por un lado, perfeccionó técnicas de control, temporización, transmisión del movimiento y secuenciación mecánica; por otro, cambió la manera de imaginar lo que una máquina podía hacer. Los mecanismos dejaron de concebirse exclusivamente como herramientas para multiplicar fuerza y pasaron a convertirse también en dispositivos capaces de representar acciones, reproducir conductas y ejecutar procedimientos. El paso siguiente exigiría trasladar esa lógica desde el movimiento físico hacia el terreno del cálculo y del razonamiento. Allí aparecería una pregunta nueva: si una máquina puede seguir una secuencia de acciones, ¿podría también seguir una secuencia de operaciones lógicas? En ese punto, la historia de los autómatas empieza a encontrarse con la de la matemática y con pensadores como Leibniz, que imaginaron la posibilidad de mecanizar no solo el movimiento, sino también ciertas formas de pensamiento.
2.3. Leibniz y la mecanización del razonamiento
Con Gottfried Wilhelm Leibniz, la antigua aspiración de construir máquinas capaces de ejecutar acciones automáticas dio un paso decisivo hacia un terreno mucho más abstracto: el razonamiento. Filósofo, matemático, jurista y estudioso de numerosas disciplinas, Leibniz no se limitó a preguntarse cómo podían mecanizarse determinadas operaciones aritméticas, sino que imaginó la posibilidad de representar una parte del pensamiento mediante símbolos y reglas suficientemente precisas como para que pudiera ser tratada de manera sistemática. Su proyecto pertenecía todavía al mundo intelectual del siglo XVII y estaba muy lejos de la informática moderna, pero contiene una intuición extraordinariamente fecunda: si un razonamiento puede expresarse en un lenguaje formal, quizá sea posible transformar algunas de sus operaciones en procedimientos ejecutables. La máquina ya no sería únicamente un mecanismo que mueve piezas; podría convertirse en un instrumento para manipular representaciones de acuerdo con reglas establecidas.
Leibniz conocía bien el problema desde su dimensión material. A partir de la década de 1670 trabajó en una máquina calculadora que desarrollaba ideas anteriores de la mecanización aritmética y utilizaba el denominado cilindro escalonado de Leibniz. El dispositivo estaba concebido para facilitar operaciones como sumas y restas y, mediante procedimientos mecánicos repetidos, abordar multiplicaciones y divisiones. Sus distintas versiones tuvieron dificultades prácticas y no llegaron a convertirse en máquinas de uso generalizado, pero su importancia histórica reside en el intento de trasladar operaciones matemáticas a una estructura física capaz de ejecutarlas. Cada movimiento del mecanismo correspondía a una relación previamente definida entre números. La persona introducía los datos y preparaba la operación; la organización interna de la máquina realizaba después parte del trabajo. La aritmética demostraba así que una actividad intelectual podía, al menos en determinados aspectos, separarse de quien la efectuaba y confiarse a un procedimiento mecánico.
La ambición de Leibniz iba mucho más lejos que aquella calculadora. Durante buena parte de su vida desarrolló la idea de una characteristica universalis, un lenguaje simbólico universal que permitiera representar conceptos y relaciones de una manera rigurosa. Ligada a ella aparecía la aspiración a un calculus ratiocinator, un cálculo del razonamiento mediante el cual ciertas controversias pudieran resolverse manipulando símbolos conforme a reglas, de forma análoga a como se resuelve una operación matemática. Leibniz no llegó a construir un sistema formal completo capaz de realizar semejante programa, y sería anacrónico identificar directamente estas ideas con un lenguaje de programación o con una inteligencia artificial. Su importancia está en el cambio de perspectiva: razonar podía considerarse, en determinados ámbitos, una actividad susceptible de formalización. Allí donde fuera posible traducir conceptos y relaciones a una notación adecuada, el desacuerdo podría transformarse parcialmente en una cuestión de cálculo en lugar de depender únicamente de la argumentación verbal.
Esta aspiración se apoyaba en una convicción fundamental: los símbolos no tenían que limitarse a representar cantidades. También podían servir para expresar relaciones lógicas y combinaciones de conceptos. Esa idea resulta especialmente significativa desde la perspectiva de la historia de la computación, porque anticipa una separación que llegará a ser central mucho después: la distinción entre el soporte físico de una máquina y aquello que puede representarse mediante sus operaciones. Un mecanismo puede trabajar con números, pero los números mismos pueden utilizarse para codificar entidades de naturaleza muy diferente. Leibniz exploró asimismo el sistema binario, basado en los dígitos 0 y 1, y publicó a comienzos del siglo XVIII una exposición sobre su aritmética. No inventó con ello la computación binaria moderna, ni puede establecerse una línea directa desde esos trabajos hasta los ordenadores electrónicos, pero reconoció la extraordinaria capacidad de un sistema numérico construido a partir de dos únicos signos para expresar cualquier cantidad mediante combinaciones ordenadas.
La relevancia de Leibniz para la futura mecanización del pensamiento reside, por tanto, menos en haber anticipado máquinas concretas que en haber reunido varias ideas que después resultarían fundamentales: representar mediante símbolos, establecer reglas para operar con ellos, convertir una actividad compleja en una sucesión de procedimientos y confiar algunas de esas operaciones a una máquina. Todavía faltaban desarrollos decisivos en lógica matemática, teoría de la computación, electrónica y programación, pero el problema comenzaba a formularse de una manera nueva. La pregunta ya no era solamente si una máquina podía calcular, sino hasta dónde podía extenderse aquello que entendemos por cálculo. Si ciertas formas de razonamiento podían formalizarse, entonces la frontera entre una operación intelectual y una operación mecánica dejaba de parecer completamente infranqueable.
Ese proyecto nunca significó que Leibniz creyera que todo pensamiento humano pudiera reducirse sin más a una máquina. Su obra filosófica es mucho más amplia y compleja que esa interpretación, y sus propuestas de cálculo lógico deben entenderse dentro de un esfuerzo por construir instrumentos rigurosos para el conocimiento. Sin embargo, la intuición que contienen tendría una larga descendencia intelectual. En los siglos posteriores, la lógica comenzaría a transformarse progresivamente en una disciplina formal capaz de expresar proposiciones y relaciones mediante sistemas simbólicos cada vez más precisos. Antes de que pudiera existir una máquina programable, era necesario concebir que las operaciones podían representarse, organizarse y ejecutarse según reglas. Leibniz ayudó a abrir precisamente ese horizonte: el de una razón que, al menos en algunos de sus dominios, podía convertirse en procedimiento. El siguiente gran paso consistiría en imaginar una máquina capaz no solo de efectuar cálculos particulares, sino de recibir instrucciones diferentes y modificar su actividad según ellas, una idea que alcanzaría una forma extraordinariamente avanzada en los proyectos de Charles Babbage.
2.4. Charles Babbage y la máquina programable
En la primera mitad del siglo XIX, el problema de mecanizar el cálculo adquirió una dimensión completamente nueva con Charles Babbage. Matemático británico, Babbage conocía bien las dificultades que planteaba la elaboración de tablas numéricas utilizadas en astronomía, navegación, ingeniería y otras actividades científicas. Muchas de ellas se calculaban manualmente y después se copiaban e imprimían, un proceso lento en el que podían introducirse errores. Su respuesta inicial fue imaginar una máquina que realizara automáticamente determinadas operaciones siguiendo un método matemático fijo. Pero aquel proyecto terminaría conduciéndolo mucho más lejos. De la búsqueda de una calculadora mecánica fiable surgió finalmente la concepción de una máquina capaz de recibir instrucciones y ejecutar distintos procedimientos: una idea que, pese a las enormes diferencias tecnológicas, anticipaba algunos principios fundamentales del ordenador programable.
El primero de sus grandes proyectos fue la Máquina Diferencial, concebida durante la década de 1820. Su finalidad era calcular automáticamente tablas numéricas mediante el método de las diferencias finitas, que permite obtener determinados valores utilizando principalmente operaciones de suma. Babbage pretendía reducir así la intervención humana en una tarea propensa a errores y conectar, idealmente, el cálculo con mecanismos capaces de preparar los resultados para su impresión. La máquina debía construirse con miles de piezas mecánicas de gran precisión, algo extraordinariamente exigente para la ingeniería de la época. El gobierno británico apoyó económicamente el proyecto durante años, pero las dificultades técnicas, los costes crecientes y los desacuerdos relacionados con su construcción impidieron terminar la máquina original. Décadas después, Babbage diseñó una versión mejorada, la Máquina Diferencial nº 2, cuyos planos demostraron posteriormente que el principio mecánico era viable cuando se disponía de la precisión industrial necesaria.
Mientras trabajaba en aquellos problemas, Babbage concibió hacia la década de 1830 un proyecto mucho más ambicioso: la Máquina Analítica. La diferencia conceptual era enorme. La Máquina Diferencial había sido pensada para ejecutar una familia determinada de cálculos; la nueva máquina debía poder realizar diferentes operaciones siguiendo instrucciones suministradas externamente. Babbage imaginó una arquitectura formada por componentes con funciones diferenciadas. Denominó “almacén” a la parte destinada a conservar números y resultados, y “molino” al mecanismo encargado de efectuar las operaciones aritméticas. La analogía con elementos que hoy llamaríamos memoria y unidad de procesamiento resulta evidente, aunque no deben identificarse sin matices con componentes electrónicos modernos. Lo verdaderamente novedoso era la organización general: los datos, las operaciones y el mecanismo que las ejecutaba comenzaban a concebirse como elementos distinguibles dentro de un mismo sistema.
Para introducir instrucciones, Babbage se inspiró en las tarjetas perforadas utilizadas en los telares de Joseph-Marie Jacquard, que permitían controlar automáticamente patrones textiles mediante diferentes combinaciones de perforaciones. En la Máquina Analítica, sistemas de tarjetas debían proporcionar información relacionada con las operaciones y con los datos. La máquina estaba concebida además para alterar la secuencia de ejecución bajo determinadas condiciones y para repetir conjuntos de operaciones, principios comparables en sentido general con estructuras que más tarde serían habituales en programación. La importancia de esta concepción reside en que una misma estructura mecánica podía ejecutar procedimientos diferentes dependiendo de las instrucciones recibidas. El comportamiento de la máquina ya no estaba determinado exclusivamente por una única función incorporada físicamente: podía modificarse cambiando la secuencia que debía seguir.
Aquí aparece una de las transformaciones conceptuales más importantes de la historia de la computación. En una máquina especializada, mecanismo y función están estrechamente unidos: el aparato existe para ejecutar una tarea concreta. En una máquina programable, en cambio, una parte de la función puede trasladarse a las instrucciones. Esto permite utilizar el mismo dispositivo para resolver problemas diferentes sin reconstruir físicamente toda la máquina cada vez. Babbage no disponía, naturalmente, de nuestros conceptos modernos de software o código, pero su Máquina Analítica incorporaba de forma embrionaria esa separación entre una arquitectura relativamente general y los procedimientos que debía ejecutar. Esa característica la distingue de muchas calculadoras mecánicas anteriores y explica por qué ocupa un lugar tan destacado en la genealogía conceptual de los ordenadores.
La Máquina Analítica nunca llegó a completarse. Su extraordinaria complejidad, las limitaciones de fabricación, las dificultades económicas y la magnitud del proyecto impidieron convertirla en una máquina plenamente operativa. Sería equivocado presentar a Babbage como inventor directo del ordenador moderno, que surgiría más de un siglo después dentro de un contexto científico y tecnológico muy diferente. Su aportación fue de otra naturaleza: formuló con una precisión excepcional la posibilidad de una máquina mecánica de propósito general capaz de almacenar valores, procesarlos y ejecutar secuencias de instrucciones. El proyecto demostraba que la automatización podía avanzar desde la repetición de un cálculo concreto hacia la ejecución de procedimientos variables.
Esa posibilidad abría una pregunta todavía más profunda. Si una máquina podía recibir instrucciones diferentes, ¿tenía que limitarse necesariamente a manipular cantidades, o podría operar sobre otros elementos siempre que estos fueran representados mediante símbolos adecuados? La respuesta comenzaría a tomar forma gracias a Ada Lovelace, que estudió detenidamente la Máquina Analítica y comprendió que su significado potencial desbordaba el cálculo numérico. Babbage había imaginado la arquitectura de una máquina programable; Lovelace ayudaría a expresar una intuición decisiva para el futuro de la computación: que aquello que una máquina procesa puede representar mucho más que números.
La máquina analítica de Charles Babbage: el antecedente mecánico del ordenador. La máquina analítica concebida por Charles Babbage en el siglo XIX representa uno de los precedentes más importantes de la informática moderna. Aunque nunca llegó a construirse por completo, su diseño incorporaba elementos fundamentales de un ordenador: una unidad de cálculo, un sistema de memoria, mecanismos de control y la posibilidad de ejecutar instrucciones de forma automática. Foto: Bruno Barral. CC BY-SA 2.5. Original file (1,919 × 1,844 pixels, file size: 1.38 MB).

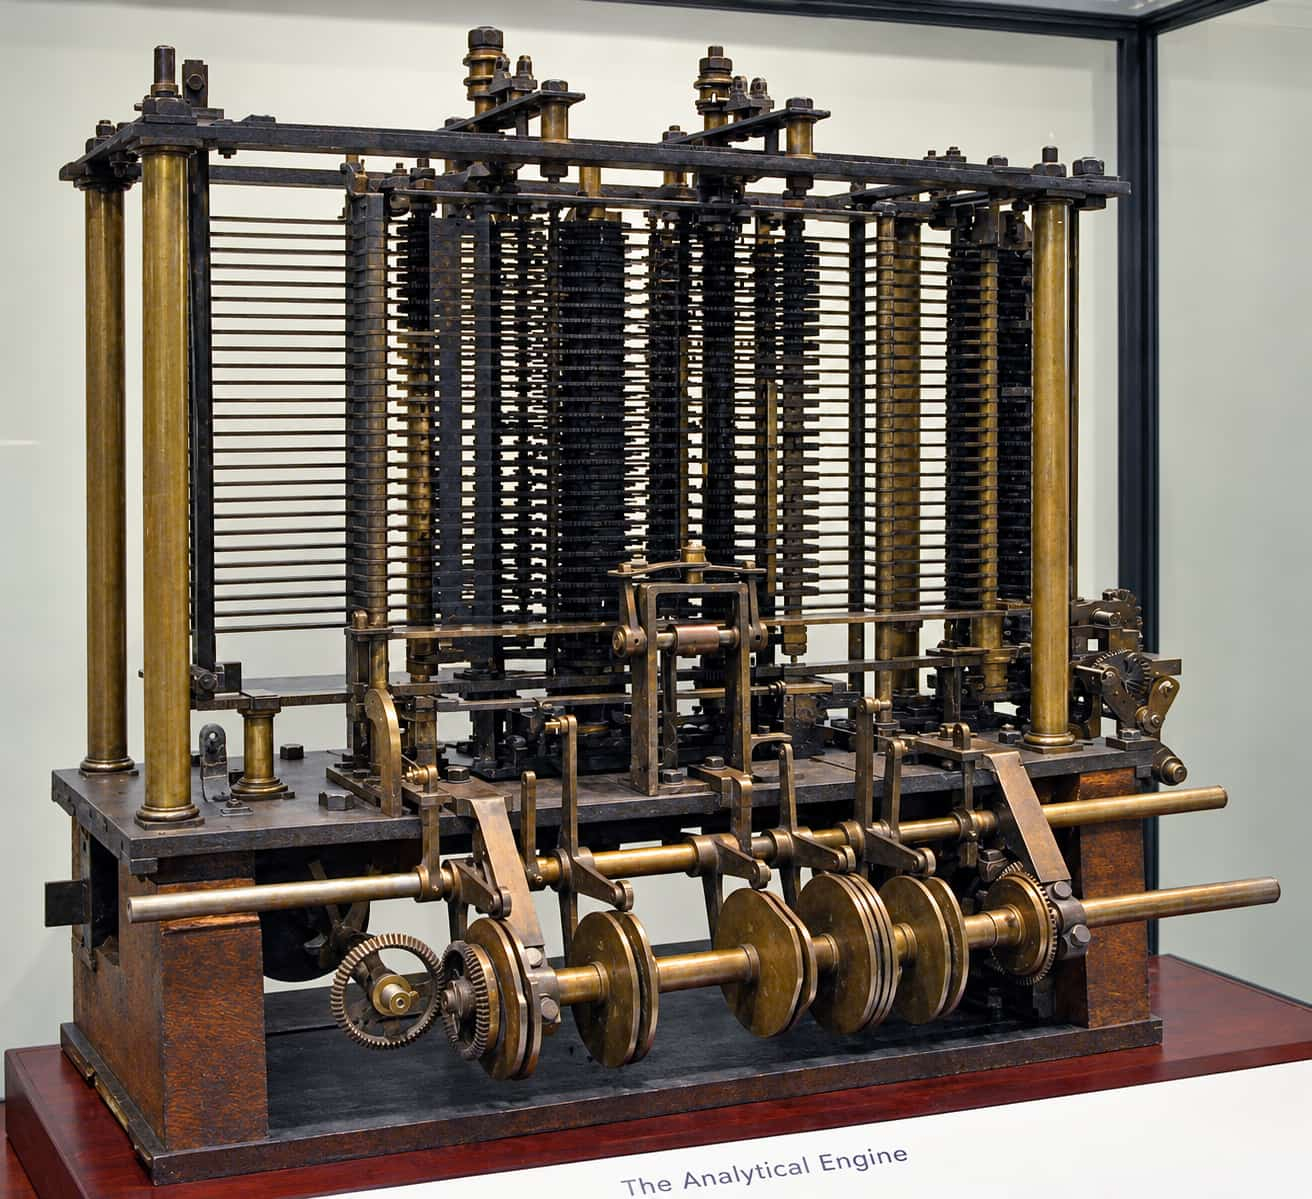
La máquina analítica fue ideada por el matemático e inventor británico Charles Babbage como un dispositivo capaz de realizar cálculos complejos de manera automática y programable. Frente a otras máquinas anteriores, limitadas a operaciones concretas, este proyecto introducía una concepción mucho más ambiciosa: la de una máquina general capaz de seguir una secuencia de instrucciones, almacenar resultados intermedios y resolver problemas mediante un proceso ordenado.
Su importancia histórica reside en que anticipó, en forma mecánica, principios que hoy asociamos al ordenador moderno. Babbage distinguió en su diseño una parte destinada al cálculo —equivalente a una unidad de procesamiento—, otra dedicada al almacenamiento de datos, así como mecanismos de entrada y control inspirados en las tarjetas perforadas utilizadas en los telares de Jacquard. Con ello, la máquina analítica dejaba de ser un simple instrumento de cálculo para convertirse en un auténtico sistema programable.
Este proyecto ocupa también un lugar central en la historia de la inteligencia artificial y de la computación porque abrió la posibilidad de pensar la máquina no solo como herramienta física, sino como estructura lógica capaz de ejecutar operaciones encadenadas. En ese contexto, Ada Lovelace comprendió con especial lucidez que una máquina de este tipo podía operar no solo con números, sino también con símbolos representables mediante reglas formales. Por eso, la máquina analítica no debe verse únicamente como una curiosidad técnica del siglo XIX, sino como uno de los primeros grandes pasos en la larga historia de las máquinas que procesan información.
2.5. Ada Lovelace y la idea de una máquina capaz de operar con símbolos
Ada Lovelace ocupa un lugar singular en la historia de la computación porque comprendió con especial claridad que una máquina programable podía llegar a hacer algo conceptualmente más amplio que efectuar cálculos numéricos. Hija de Lord Byron y formada en matemáticas en un contexto en el que el acceso de las mujeres a la ciencia era todavía muy limitado, Lovelace conoció a Charles Babbage y se interesó profundamente por su Máquina Analítica. En 1843 tradujo al inglés un artículo del ingeniero italiano Luigi Federico Menabrea sobre aquel proyecto y añadió una extensa serie de notas propias, considerablemente más largas que el texto original. En ellas no solo explicó el funcionamiento previsto de la máquina, sino que reflexionó sobre sus posibilidades generales. Su aportación resulta decisiva porque permitió formular con notable anticipación una idea que hoy parece elemental: una máquina puede manipular símbolos siempre que estos sean representados de una manera adecuada y sometidos a reglas precisas.
La Máquina Analítica trabajaba físicamente con cantidades, pero Lovelace entendió que los números podían representar mucho más que magnitudes. Podían utilizarse para codificar relaciones, estructuras o entidades de naturaleza distinta. Si una secuencia musical, por ejemplo, pudiera expresarse mediante relaciones susceptibles de representación formal, la máquina podría operar sobre ellas del mismo modo que trabajaba con cantidades aritméticas. Esta intuición ampliaba radicalmente el significado de la computación. El interés ya no residía únicamente en automatizar operaciones matemáticas, sino en comprender que el cálculo podía convertirse en un procedimiento general de manipulación simbólica. Una máquina no necesitaba “saber” qué era aquello que representaban los símbolos; bastaba con que pudiera tratarlos según reglas definidas. Esa separación entre significado humano y operación formal terminaría siendo una de las bases de toda la informática posterior.
Ada Lovelace y la idea de una máquina capaz de operar con símbolos. Ada Lovelace comprendió que una máquina de cálculo podía ir más allá de las operaciones numéricas y manipular símbolos mediante reglas. Daguerreotipo por Antoine Claudet 1843. Compartido/Shared por/by Paul Graham on x.com. (Imagen restaurada con ia). Dominio Público.
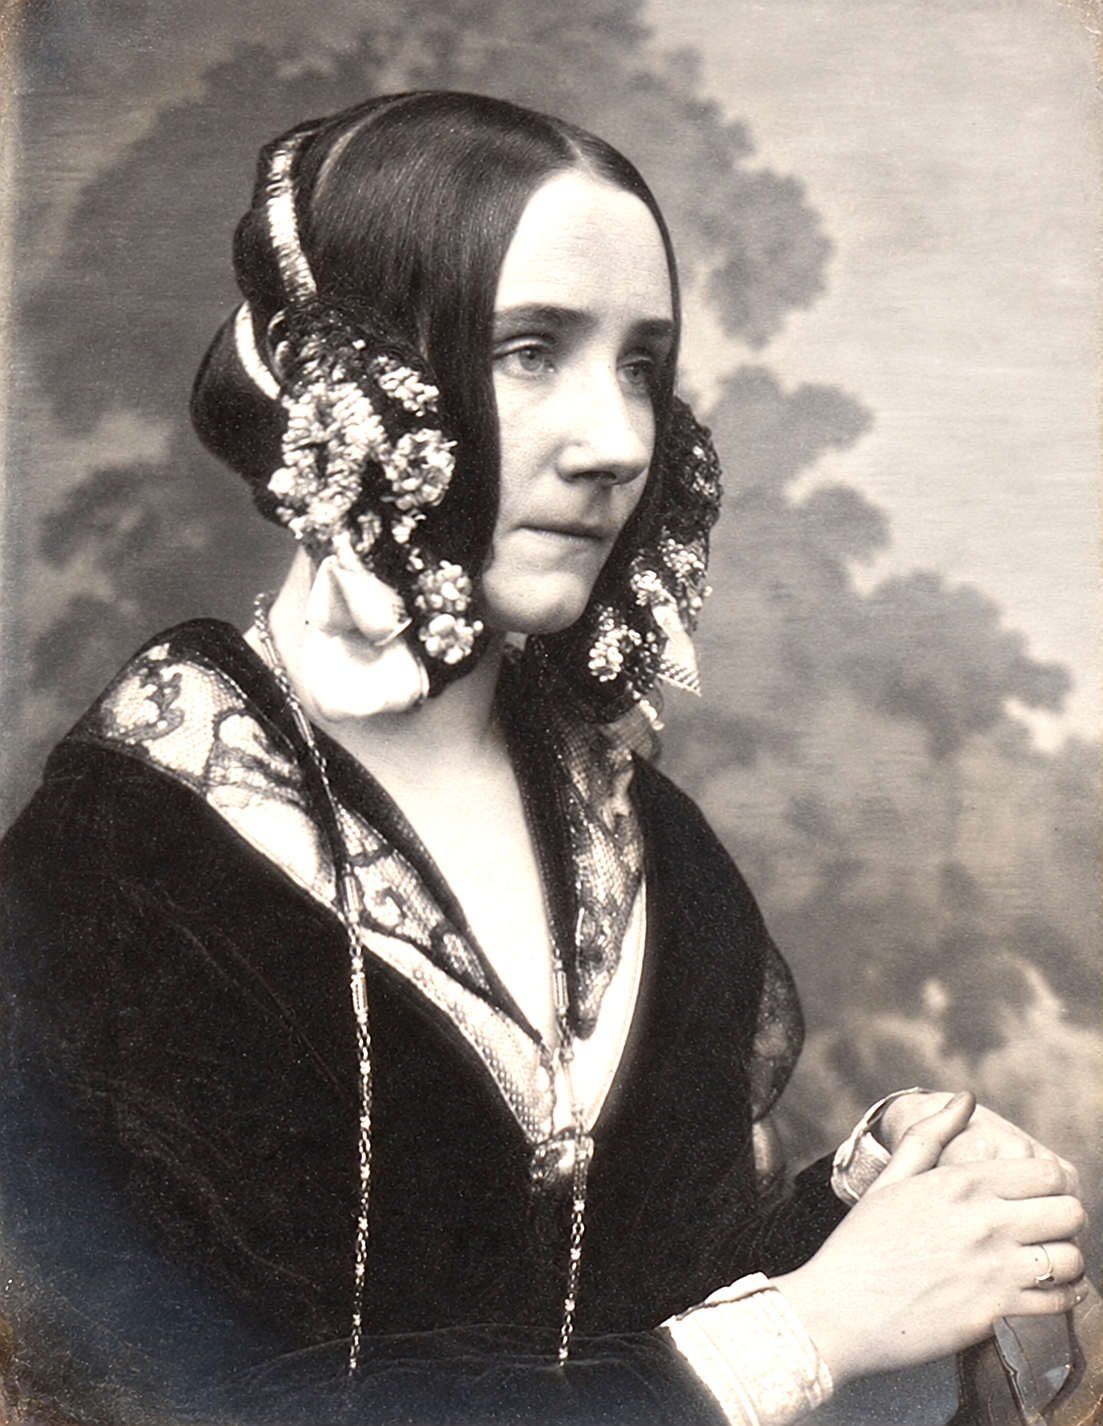
Ada Lovelace estudió las posibilidades de la máquina analítica de Charles Babbage y desarrolló una visión extraordinariamente avanzada para su tiempo. En sus notas señaló que una máquina podía trabajar no solo con números, sino también con símbolos siempre que pudieran expresarse mediante reglas formales. Su reflexión anticipó una idea fundamental de la computación moderna: una máquina programable puede operar sobre representaciones de muy distinta naturaleza.
Entre las notas de Lovelace se encuentra también una descripción detallada de un procedimiento para calcular números de Bernoulli mediante la Máquina Analítica. Ese desarrollo suele citarse como uno de los primeros algoritmos publicados concebidos específicamente para ser ejecutados por una máquina de propósito general. La importancia histórica de este hecho no debe reducirse a una disputa por el título de “primera programadora”, expresión útil pero simplificadora. Lo verdaderamente relevante es que Lovelace mostró cómo una secuencia compleja de operaciones podía organizarse para ser procesada por una máquina cuyo funcionamiento dependía de instrucciones. Identificó relaciones entre operaciones, repeticiones y datos, y pensó el problema desde la lógica interna de la ejecución automática. En otras palabras, no se limitó a contemplar una máquina hipotética: intentó imaginar cómo debía pensarse una tarea para que pudiera ser realizada por ella.
Lovelace fue también notablemente prudente respecto a las capacidades de la Máquina Analítica. En sus notas señaló que la máquina no originaba por sí misma aquello que hacía, sino que podía ejecutar las operaciones que supiéramos ordenarle. Esta observación, formulada mucho antes de que existieran los ordenadores electrónicos, anticipa un debate que reaparecería con fuerza en el siglo XX: hasta qué punto una máquina puede considerarse creadora, inteligente o autónoma. Su postura no era una negación de las posibilidades de la computación, sino una distinción entre la capacidad de ejecutar transformaciones complejas y la atribución de facultades mentales semejantes a las humanas. Precisamente por reconocer el enorme potencial del sistema, Lovelace percibió también la necesidad de describir con cuidado aquello que realmente hacía la máquina y aquello que podía atribuirse únicamente a su diseñador o a las instrucciones recibidas.
Su visión resulta especialmente moderna porque combina amplitud y precisión. Por un lado, imaginó un futuro en el que las máquinas programables podrían trabajar con formas diversas de información; por otro, evitó convertir esa posibilidad en una afirmación vaga sobre máquinas dotadas de pensamiento. Esta tensión entre potencia y límite acompañará toda la historia posterior de la inteligencia artificial. Un sistema puede manipular símbolos, reconocer regularidades y producir resultados inesperados sin que ello implique necesariamente una experiencia consciente o una comprensión humana de aquello que procesa. Lovelace no formuló estas cuestiones con el vocabulario contemporáneo, pero su análisis ya apuntaba hacia una diferencia esencial entre el significado que una persona atribuye a una representación y las operaciones formales que una máquina puede realizar sobre ella.
La importancia de Ada Lovelace reside, por tanto, en haber ayudado a transformar la imagen de la máquina calculadora en la de una máquina simbólica. Babbage había concebido una arquitectura capaz de ejecutar distintos procedimientos; Lovelace comprendió que esa flexibilidad podía extenderse a cualquier ámbito susceptible de representación formal. La consecuencia era enorme: la computación podía dejar de estar restringida al número como objeto y convertirse en un método general para tratar información. En las décadas siguientes, la lógica matemática desarrollaría precisamente los lenguajes formales y las herramientas necesarias para profundizar en esa idea. Antes de que pudiera nacer la inteligencia artificial, había que establecer con mucha mayor precisión qué significa representar un problema, seguir un procedimiento y operar con símbolos. Ese será el siguiente paso en el camino hacia la computación moderna.
Diagrama para el cálculo de los números de Bernoulli mediante la máquina analítica. El diagrama elaborado a partir de las notas de Ada Lovelace sobre la máquina analítica de Charles Babbage organiza una secuencia de operaciones para calcular números de Bernoulli y constituye uno de los primeros ejemplos históricos de un algoritmo concebido expresamente para ser ejecutado por una máquina. Fuente: Ada Lovelace. Este enlace. Dominio público.
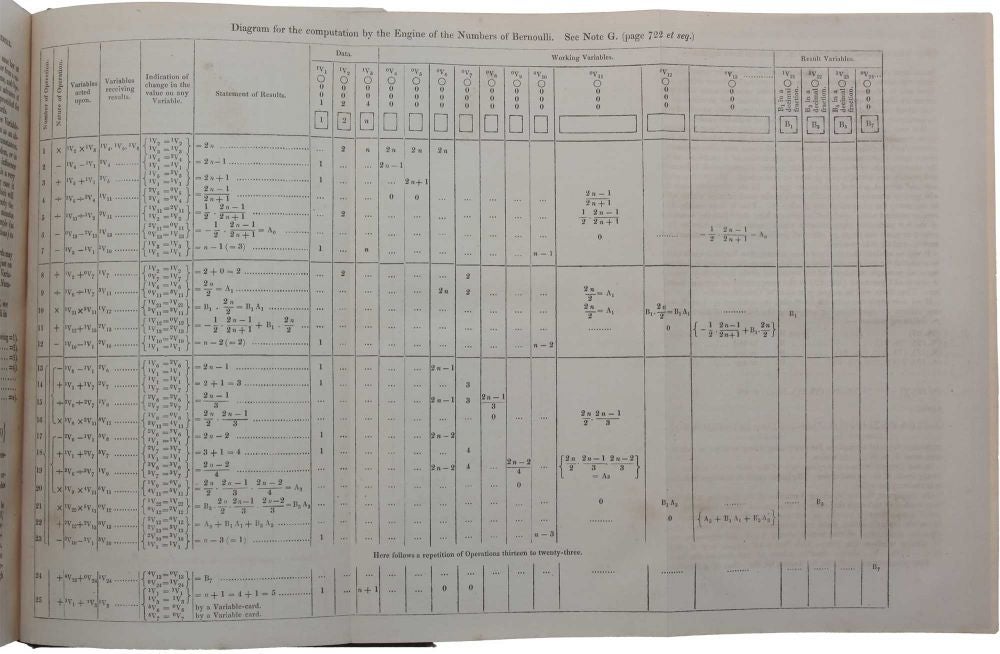
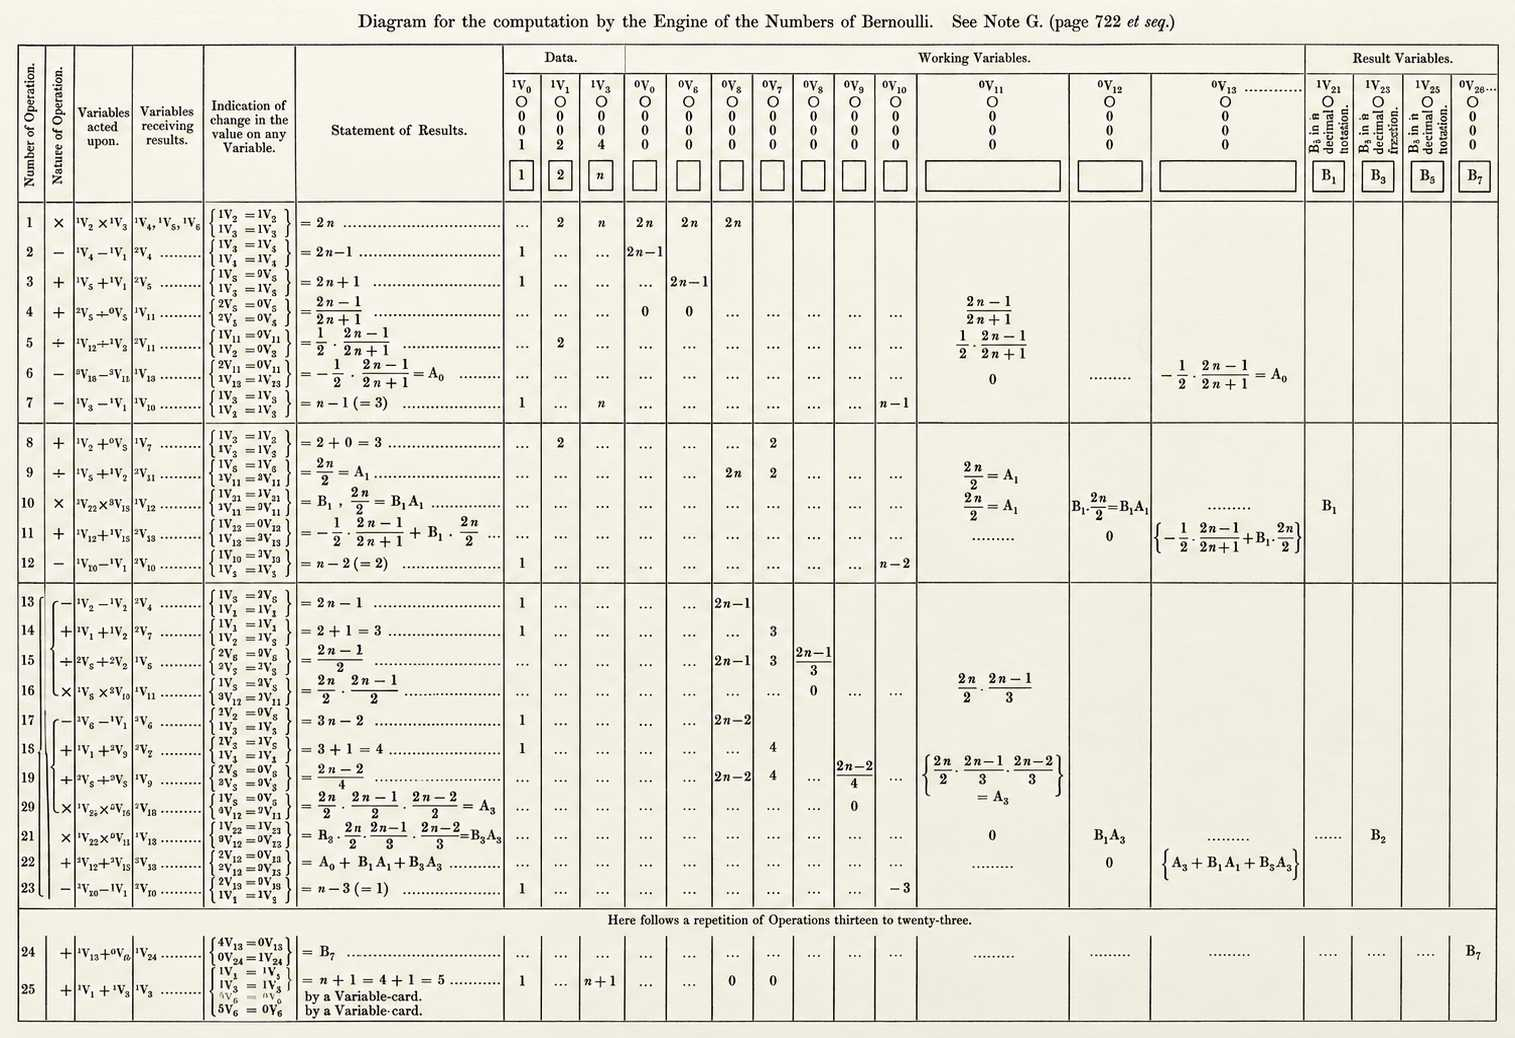
El llamado diagrama para el cálculo de los números de Bernoulli ocupa un lugar singular en la historia de la computación porque muestra, de forma sistemática, cómo una máquina podía ejecutar una secuencia ordenada de operaciones siguiendo instrucciones previamente definidas. Ada Lovelace incluyó este procedimiento en las extensas notas que acompañaban su traducción del artículo de Luigi Federico Menabrea sobre la máquina analítica de Charles Babbage. Aquellas notas, publicadas en 1843, superaban ampliamente el texto original y contenían reflexiones sobre las posibilidades generales de una máquina programable.
El diagrama describe paso a paso las operaciones necesarias para calcular determinados números de Bernoulli, una sucesión matemática utilizada en diversos problemas de análisis y teoría de números. Su importancia no reside tanto en el cálculo concreto como en la manera en que ese cálculo queda descompuesto en una serie precisa de instrucciones, variables, operaciones y resultados intermedios. Es decir, el procedimiento traduce un problema matemático a una estructura formal que una máquina podría seguir mecánicamente.
Por esta razón, suele citarse como uno de los primeros ejemplos de un algoritmo diseñado para ser ejecutado por una máquina de propósito general. Lovelace comprendió que el verdadero potencial de la máquina analítica no estaba limitado a realizar cálculos aislados, sino en la posibilidad de encadenar operaciones y manipular representaciones siguiendo reglas. Esa intuición anticipaba una de las ideas fundamentales de la informática moderna: la separación entre el dispositivo físico y el conjunto de instrucciones que determina lo que ese dispositivo debe hacer.
El interés histórico del gráfico es todavía mayor porque permite observar una forma temprana de pensamiento algorítmico. La tabla distingue operaciones, variables de entrada, resultados parciales y valores finales, y organiza el proceso en una secuencia controlada. Aunque la notación pertenece al siglo XIX y la máquina analítica nunca llegó a construirse completamente en vida de Babbage, el principio subyacente resulta sorprendentemente moderno: una máquina programable puede ejecutar procedimientos complejos si estos se expresan mediante una serie de instrucciones formales.
La aportación de Ada Lovelace fue especialmente relevante porque entendió que ese principio podía ir más allá del cálculo numérico. En sus notas señaló que, si otros tipos de información podían representarse mediante símbolos y relaciones formales, una máquina podría operar también sobre ellos. Esta idea amplió radicalmente la concepción de lo que podía ser una máquina de cálculo y anticipó el concepto moderno de computación de propósito general.
El diagrama de los números de Bernoulli es, por tanto, mucho más que una curiosidad matemática. Representa uno de los momentos en los que empieza a formularse la idea de que una máquina puede seguir un programa, transformar información paso a paso y producir resultados mediante reglas previamente establecidas. En esa transición —del cálculo mecánico al pensamiento algorítmico— se encuentra uno de los antecedentes intelectuales más importantes de la informática y, mucho más tarde, de la inteligencia artificial.
2.6. Lógica matemática, algoritmos y nacimiento de la computación
Entre finales del siglo XIX y la primera mitad del XX se produjo una transformación decisiva: el razonamiento comenzó a estudiarse no solo como actividad filosófica, sino también como estructura formal susceptible de expresarse mediante símbolos y reglas rigurosas. La lógica matemática desarrolló lenguajes capaces de representar proposiciones, relaciones y operaciones con una precisión inédita. Esto permitió plantear preguntas nuevas sobre los propios límites del razonamiento: qué problemas pueden resolverse mediante procedimientos definidos, qué significa demostrar algo paso a paso y hasta dónde puede llegar un método puramente formal. En este contexto, el concepto de algoritmo adquirió una importancia central. Un algoritmo puede entenderse, en términos generales, como una secuencia finita y ordenada de instrucciones para resolver una determinada clase de problemas. La idea es antigua, pero durante este periodo comenzó a adquirir una formulación mucho más precisa, indispensable para el nacimiento de la computación moderna.
Los avances en lógica mostraron que era posible representar operaciones intelectuales mediante sistemas simbólicos cada vez más estructurados. George Boole había dado un paso fundamental en el siglo XIX al desarrollar un álgebra lógica en la que proposiciones y relaciones podían expresarse mediante operaciones formales. Posteriormente, otros matemáticos profundizaron en la idea de construir lenguajes rigurosos capaces de describir el razonamiento. El objetivo no era fabricar ordenadores, sino comprender los fundamentos de las matemáticas y determinar qué podía demostrarse dentro de un sistema formal. Sin embargo, este esfuerzo creó precisamente el terreno conceptual que la computación necesitaba: símbolos, reglas de transformación, procedimientos y estados claramente definidos. Cuando una operación puede describirse de esa manera, deja de depender de una interpretación intuitiva en cada paso y puede imaginarse como algo ejecutable de forma sistemática.
A comienzos del siglo XX, estas investigaciones desembocaron en una cuestión particularmente profunda: qué significa exactamente que un problema sea calculable. No bastaba con afirmar que existe un método; era necesario precisar qué características debía poseer ese método para considerarse efectivo y realizable mediante una secuencia finita de operaciones. Las respuestas desarrolladas en la década de 1930 por figuras como Alonzo Church y Alan Turing ofrecieron modelos formales de computación que, aunque formulados de manera diferente, captaban una misma idea esencial: existen procedimientos que pueden describirse mediante reglas elementales y ejecutarse paso a paso sin necesidad de intuiciones adicionales. Con ello, la noción de algoritmo dejó de ser solo una práctica matemática y se convirtió en un objeto de estudio teórico. La computación empezaba a definirse antes incluso de que existieran los ordenadores electrónicos tal como hoy los conocemos.
El trabajo de Turing resultó especialmente influyente porque propuso una máquina abstracta extremadamente sencilla como modelo del cálculo. Esta máquina teórica podía leer y escribir símbolos, cambiar de estado y seguir reglas previamente especificadas. Su importancia no estaba en su viabilidad mecánica inmediata, sino en demostrar que operaciones complejas podían descomponerse en pasos elementales ejecutables por un sistema formal. A partir de ahí fue posible estudiar qué problemas podían resolverse mediante procedimientos y cuáles escapaban a cualquier método algorítmico general. Esta separación entre lo computable y lo no computable representó una auténtica revolución intelectual. Antes de construir máquinas más potentes, la teoría había comenzado a delimitar qué significa, en sentido estricto, que una máquina pueda calcular.
La transición desde estos modelos abstractos hacia máquinas reales estuvo impulsada también por necesidades prácticas. Durante las décadas de 1930 y 1940 aumentó el interés por dispositivos capaces de realizar cálculos científicos, criptográficos y militares de manera más rápida y fiable. La electrónica ofreció una alternativa a los mecanismos puramente mecánicos y permitió construir sistemas mucho más veloces. Surgieron distintos proyectos de máquinas electromecánicas y electrónicas, desarrollados de forma independiente en varios países, que fueron incorporando principios como el procesamiento automático de secuencias de operaciones, el uso de componentes electrónicos y, progresivamente, la posibilidad de almacenar instrucciones junto con los datos. La computación moderna nació así de la convergencia entre una tradición teórica —lógica, algoritmos y fundamentos matemáticos— y una tradición técnica orientada a construir dispositivos capaces de ejecutar esas ideas físicamente.
Uno de los avances conceptuales más importantes fue precisamente la separación entre hardware y programa. Una máquina podía poseer una estructura física relativamente estable y modificar su comportamiento según las instrucciones que recibiera. Esta idea recogía y ampliaba intuiciones presentes ya en Babbage, pero la electrónica permitió convertirla en una realidad práctica. Los programas podían describir procedimientos diferentes sin necesidad de reconstruir cada vez la máquina. A partir de este principio, los ordenadores dejaron de ser únicamente calculadoras especializadas y se transformaron en dispositivos capaces de ejecutar tareas muy diversas siempre que estas pudieran expresarse mediante algoritmos adecuados. La computación pasó a ser una tecnología general de tratamiento de información.
Con este cambio quedó preparado el escenario para la inteligencia artificial. Antes de intentar construir máquinas capaces de resolver problemas complejos, reconocer patrones o trabajar con lenguaje, había sido necesario establecer algo más fundamental: que una tarea intelectual podía formalizarse, que un procedimiento podía convertirse en algoritmo y que una máquina podía ejecutar ese algoritmo automáticamente. La lógica matemática proporcionó el lenguaje formal, la teoría de la computación definió los límites y posibilidades del cálculo, y los primeros ordenadores ofrecieron finalmente el soporte físico capaz de llevar esas ideas a la práctica. A partir de ese momento, la pregunta dejó de ser únicamente qué puede calcular una máquina y empezó a ampliarse hacia otra mucho más ambiciosa: qué tipo de capacidades asociadas a la inteligencia podrían convertirse también en procedimientos computables.
Alan Turing ocupa una posición singular en la historia de la inteligencia artificial porque su obra enlaza dos preguntas que, en principio, pertenecían a terrenos diferentes. La primera era matemática: ¿qué significa exactamente realizar un cálculo mediante un procedimiento? La segunda era mucho más provocadora: ¿hasta dónde puede llegar una máquina cuando ejecuta esos procedimientos y qué criterio deberíamos emplear para describir su comportamiento como inteligente? Entre ambas cuestiones se extiende buena parte del horizonte intelectual de la computación moderna. Turing no creó la inteligencia artificial como disciplina ni dispuso de los sistemas que décadas después permitirían desarrollarla, pero proporcionó conceptos y preguntas que ayudaron a transformar la máquina calculadora en algo intelectualmente mucho más ambicioso: un dispositivo general capaz de ejecutar procedimientos diversos y, al menos en principio, abordar problemas que antes parecían reservados al razonamiento humano.
La importancia de este cambio no reside únicamente en una invención concreta. Turing contribuyó a formular una manera nueva de pensar las máquinas. Hasta entonces podía resultar natural asociar cada mecanismo con una función determinada: una calculadora calculaba, un telar producía patrones y un autómata repetía movimientos previamente establecidos. La computación abrió otra posibilidad. Una misma estructura podía comportarse de formas diferentes dependiendo de las instrucciones que recibiera. Esa flexibilidad permitía imaginar una máquina no definida exclusivamente por una tarea, sino por su capacidad para ejecutar muchos procedimientos distintos. El concepto de máquina universal llevó esta idea a una formulación teórica de enorme alcance y proporcionó una de las bases para comprender por qué los ordenadores posteriores pudieron convertirse en herramientas generales y no simplemente en dispositivos especializados.
A partir de ahí, la relación entre algoritmos y resolución de problemas adquiría una profundidad nueva. Un problema podía estudiarse preguntando si existía un procedimiento preciso que condujera a su solución y si ese procedimiento podía ser ejecutado mecánicamente. Esta perspectiva permitió delimitar tanto las posibilidades como los límites de la computación. No todo problema admite necesariamente una solución algorítmica general, y descubrir esos límites fue tan importante como demostrar la potencia de las máquinas. La inteligencia artificial heredaría esta tensión desde sus orígenes: para construir sistemas capaces de resolver problemas complejos sería necesario determinar qué partes de una actividad podían expresarse mediante procedimientos, representaciones o estrategias computacionales y cuáles planteaban dificultades mucho más profundas.
Pero Turing no permaneció únicamente en el terreno abstracto del cálculo. En 1950 formuló de manera directa una pregunta que acabaría convirtiéndose en uno de los grandes referentes de la inteligencia artificial: «¿Pueden pensar las máquinas?». La formulación parecía sencilla, aunque escondía un problema inmediato. ¿Qué significa exactamente “pensar”? Si la respuesta depende de una definición previa y universalmente aceptada de pensamiento, la discusión corre el riesgo de quedar atrapada en palabras antes incluso de examinar lo que una máquina puede hacer. Turing propuso entonces desplazar la cuestión desde una propiedad interior difícil de observar hacia el comportamiento. En lugar de intentar determinar directamente si una máquina posee pensamiento, podía preguntarse si era capaz de participar en una interacción lingüística de tal manera que su comportamiento resultara difícil de distinguir del de una persona.
Ese desplazamiento dio lugar al conocido juego de imitación, posteriormente popularizado como test de Turing. Su importancia histórica no consiste en haber proporcionado una prueba definitiva de inteligencia, algo que el propio desarrollo posterior de la disciplina ha hecho mucho más complejo, sino en haber cambiado el modo de plantear la cuestión. La inteligencia podía estudiarse también a través de capacidades observables. Esto abría un territorio fértil, pero igualmente problemático: comportarse como si se comprendiera algo no demuestra necesariamente que exista una experiencia interna comparable a la humana. La relación entre pensamiento, conducta, lenguaje e inteligencia quedaba así planteada como un problema científico y filosófico que seguiría acompañando a la inteligencia artificial durante décadas.
La figura de Turing permite, por ello, observar un momento extraordinario de transición. De un lado se encuentra el estudio formal de la computación: algoritmos, procedimientos, máquinas abstractas y límites matemáticos. Del otro aparece una cuestión mucho más abierta sobre la posibilidad de reproducir mediante máquinas determinadas capacidades asociadas a la mente. Ambos caminos terminarían encontrándose en la inteligencia artificial. Los investigadores posteriores intentarían construir programas capaces de resolver problemas, utilizar lenguaje, aprender o tomar decisiones, y muchas de esas aspiraciones dependerían precisamente de la idea de que una máquina general podía ejecutar procedimientos suficientemente complejos para producir comportamientos que antes parecían exclusivamente humanos.
Este epígrafe seguirá esa doble trayectoria. Partirá de la máquina universal y del significado profundo de la computación, avanzará hacia la relación entre algoritmos y resolución de problemas y llegará después a la célebre pregunta sobre si las máquinas pueden pensar. El juego de imitación permitirá examinar por qué Turing prefirió estudiar conductas observables antes que intentar definir directamente la naturaleza del pensamiento, y esa elección conducirá al problema más delicado de distinguir comportamiento inteligente, inteligencia y pensamiento. La influencia de estas ideas sobre la inteligencia artificial posterior fue enorme: no porque Turing dejara resueltas las cuestiones fundamentales, sino porque formuló algunas de ellas con una claridad suficiente para que pudieran convertirse en problemas concretos de investigación.
3.1. La máquina universal de Turing
En 1936, Alan Turing abordó un problema que pertenecía a los fundamentos de las matemáticas, no al proyecto de construir ordenadores tal como hoy los entendemos. En su trabajo sobre los números computables intentó precisar qué significa realizar un cálculo mediante un procedimiento completamente definido. Para ello imaginó una máquina ideal extremadamente sencilla, hoy conocida como máquina de Turing. No era el plano de un aparato que debiera construirse con engranajes o componentes eléctricos, sino un modelo matemático pensado para representar las operaciones elementales que intervienen en un cálculo mecánico. Su aparente simplicidad ocultaba una consecuencia extraordinaria: si una tarea podía reducirse a una secuencia adecuada de operaciones de este tipo, podía considerarse computable mediante un procedimiento efectivo. Turing proporcionaba así una herramienta conceptual para estudiar el cálculo desde sus principios más básicos y, al hacerlo, terminaba formulando una de las ideas que harían posible pensar en la computadora como una máquina de carácter general.
El modelo puede imaginarse como una cinta dividida en casillas que se prolonga tanto como sea necesario. En cada casilla puede escribirse un símbolo, mientras que un dispositivo lector —la llamada cabeza de lectura y escritura— examina una posición concreta de la cinta. La máquina se encuentra además en uno de varios estados internos posibles. Según el símbolo leído y el estado en que se encuentre, una tabla de reglas determina qué debe hacer a continuación: escribir o sustituir un símbolo, desplazarse a otra casilla, cambiar de estado o detenerse. Con estos elementos mínimos pueden representarse procedimientos de enorme complejidad. La máquina no necesita comprender qué significan los símbolos que manipula; simplemente ejecuta las reglas correspondientes. El interés de Turing consistía precisamente en reducir el cálculo a una sucesión de pasos tan elementales que no quedara ninguna decisión implícita en ellos. Aquello que podía parecer una actividad matemática sofisticada se descomponía en operaciones simples realizadas de manera ordenada.
Pero Turing dio un paso todavía más profundo. En lugar de imaginar una máquina diferente para cada procedimiento, mostró que podía concebirse una máquina especial capaz de simular el funcionamiento de cualquier otra máquina de Turing. Para conseguirlo, bastaba con representar mediante símbolos tanto los datos del problema como la descripción de las reglas de la máquina que se quería reproducir. Esa descripción podía introducirse como información y ser interpretada por la máquina universal. De este modo, el procedimiento dejaba de estar inseparablemente incorporado a la estructura de un dispositivo específico: podía convertirse en información suministrada a una máquina de carácter general. Una misma máquina universal podía comportarse como muchas máquinas distintas según la descripción recibida. Esta es la idea verdaderamente revolucionaria de la universalidad computacional.
La consecuencia conceptual resulta enorme. Una máquina ya no tiene que identificarse necesariamente con la tarea para la que fue construida. Un mecanismo especializado puede estar destinado a una sola función, mientras que una máquina universal puede ejecutar procedimientos diferentes cambiando las instrucciones que recibe. Existe aquí un precedente teórico de la separación moderna entre un ordenador y los programas que se ejecutan en él. No significa que la máquina universal de Turing fuera un ordenador contemporáneo ni que incorporase todos los principios de las arquitecturas posteriores; se trata de un modelo abstracto creado antes de que los ordenadores electrónicos de propósito general se convirtieran en una realidad. Sin embargo, estableció con una claridad extraordinaria que un único sistema suficientemente general podía reproducir cualquier procedimiento computable expresado de la forma adecuada. El repertorio de funciones de la máquina dependía así menos de modificar su estructura física que de cambiar las instrucciones que procesaba.
Esta noción permite comprender por qué los ordenadores posteriores pudieron transformarse en herramientas extraordinariamente versátiles. El mismo dispositivo físico puede utilizarse para realizar cálculos científicos, procesar textos, manipular imágenes, reproducir música o ejecutar una simulación, siempre que esas actividades puedan representarse computacionalmente y exista un programa adecuado para tratarlas. La máquina no cambia esencialmente de naturaleza cada vez que cambia de tarea; cambia la información que procesa y el procedimiento que ejecuta. Turing formuló este principio en un contexto puramente teórico, pero la universalidad terminaría convirtiéndose en una de las ideas centrales de la ciencia de la computación. También permite apreciar que la potencia de un ordenador no deriva únicamente de su velocidad: reside en la combinación entre una arquitectura general y la posibilidad de describir una inmensa variedad de procedimientos mediante instrucciones.
La universalidad, sin embargo, no significa omnipotencia. Turing mostró al mismo tiempo que existen límites fundamentales para aquello que puede resolverse mediante algoritmos: hay problemas para los que no puede existir un procedimiento general capaz de proporcionar siempre una respuesta. Esta circunstancia resulta especialmente importante porque evita interpretar la máquina universal como un dispositivo capaz de solucionar cualquier cuestión imaginable. Su significado es más preciso: puede simular cualquier procedimiento que sea computable dentro del modelo, pero la propia teoría demuestra que lo computable tiene fronteras. Esa combinación de enorme generalidad y límites rigurosos constituye una de las grandes aportaciones de Turing. Antes de preguntarse si una máquina podía manifestar comportamientos inteligentes, había establecido algo esencial: una única máquina podía ejecutar una diversidad potencialmente inmensa de procedimientos. A partir de esa base sería posible plantear una cuestión nueva: qué tipos de problemas pueden transformarse en algoritmos y hasta dónde puede llegar una máquina cuando intenta resolverlos.
Cómo funciona una máquina de Turing
La máquina de Turing es un modelo teórico muy sencillo. Imaginemos una cinta dividida en casillas, cada una de las cuales puede contener un símbolo. Un cabezal lee una casilla cada vez, puede modificar su contenido y desplazarse hacia la izquierda o hacia la derecha.
La máquina dispone además de una serie de estados, representados habitualmente mediante símbolos como q0, q1, q2…. Estos estados no son valores que se estén calculando, sino diferentes situaciones internas de la máquina. Cada una determina qué debe hacer cuando encuentra un símbolo determinado.
Por ejemplo, una regla puede establecer que, si la máquina se encuentra en el estado q0 y lee un
0, debe sustituirlo por un1, avanzar una posición hacia la derecha y pasar al estado q1. En la siguiente casilla vuelve a aplicar otra regla y el proceso continúa.De este modo, una operación compleja puede descomponerse en una sucesión de instrucciones extremadamente simples: leer, escribir, moverse y cambiar de estado.
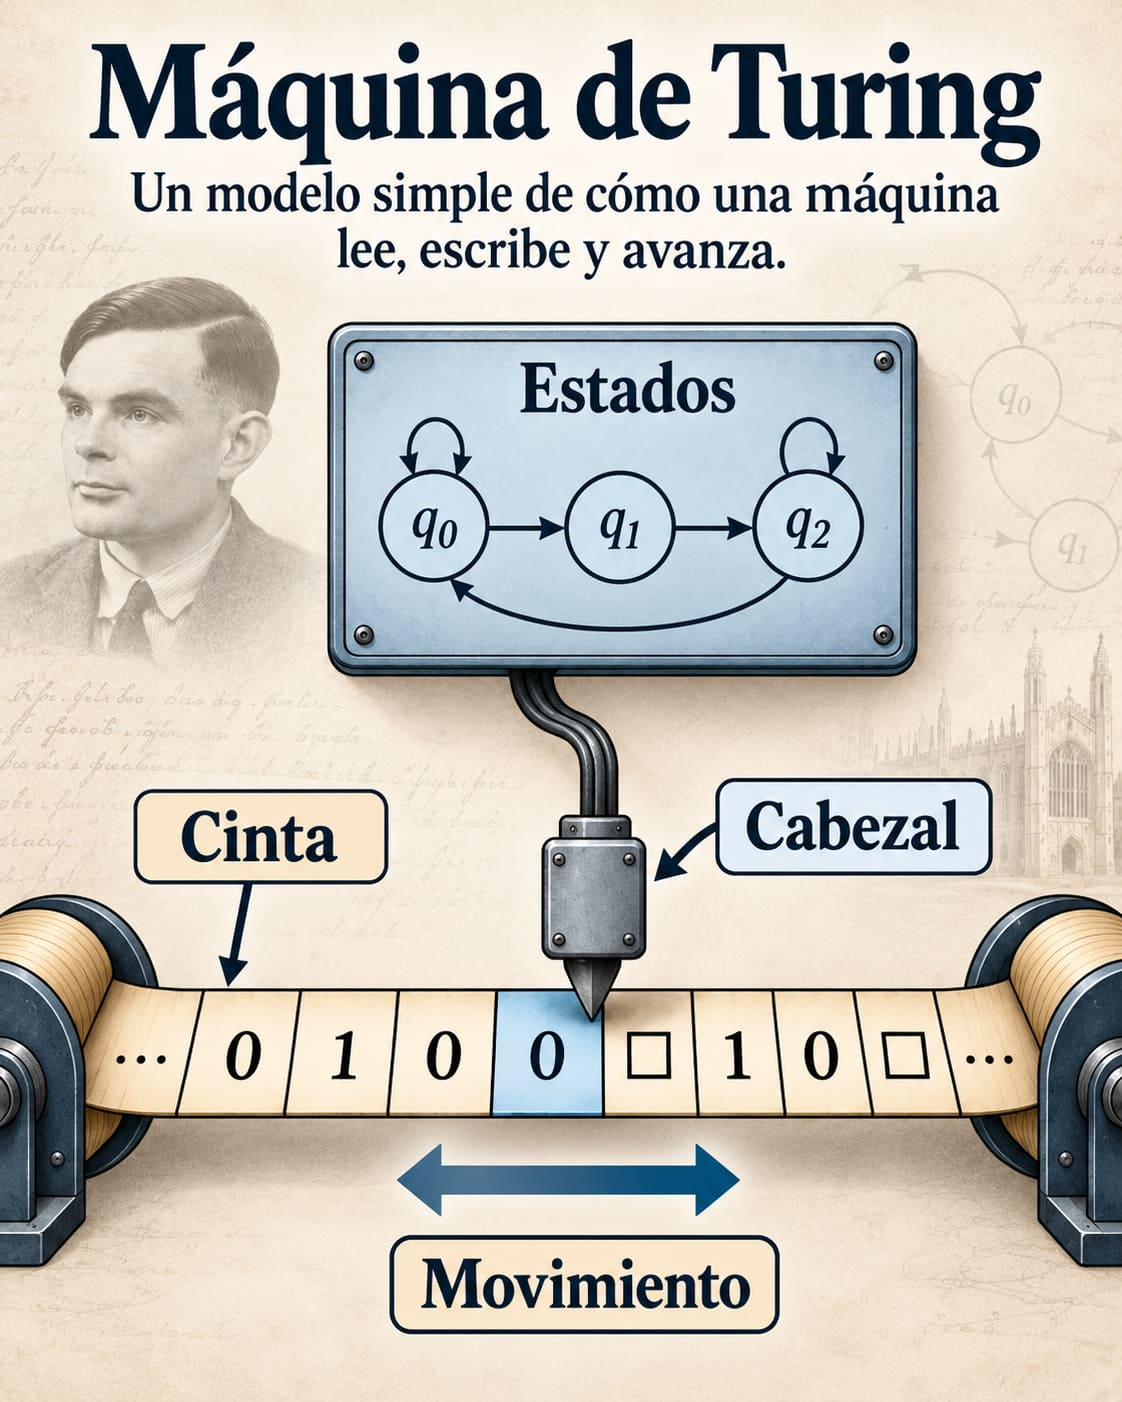
Una máquina de Turing es una máquina imaginaria extremadamente sencilla que va leyendo símbolos de uno en uno y, siguiendo unas reglas, decide qué hacer después.
Piensa en ella como en alguien que tiene delante una tira de papel cuadriculada e interminable.
La cinta es esa tira. En cada casilla puede haber un
0, un1o estar vacía. La máquina solo mira una casilla cada vez.El cabezal sería como un lápiz que puede hacer tres cosas: leer lo que hay en la casilla, escribir o cambiar el símbolo y después desplazarse una casilla a la izquierda o una a la derecha.
¿Y qué son q0, q1 y q2?
Esto es lo más importante: no son números que la máquina esté calculando.
q0,q1,q2son simplemente nombres de estados, es decir, situaciones internas en las que puede encontrarse la máquina.Podemos imaginarlos así:
- q0: «Estoy haciendo la tarea A».
- q1: «Ahora tengo que hacer la tarea B».
- q2: «Ahora estoy haciendo la tarea C».
Las letras y números son únicamente etiquetas. Podríamos llamarlos perfectamente A, B y C.
La máquina combina dos cosas:
lo que está leyendo + el estado en el que se encuentra.
Y con eso consulta una regla que le dice:
«Escribe esto, muévete hacia aquí y pasa al siguiente estado».
Un ejemplo muy sencillo
Supongamos que está en q0 y encuentra un
0.La regla podría decir:
Si estás en q0 y lees 0 → escribe 1, avanza una casilla a la derecha y pasa a q1.
Ahora está en q1 y lee la siguiente casilla.
Otra regla podría decir:
Si estás en q1 y lees 1 → déjalo como está, avanza a la derecha y pasa a q2.
Y así continúa, paso tras paso, hasta que una regla le indica que se detenga.
Eso es básicamente todo.
Y ahí está precisamente la genialidad de Turing: demostrar que, mediante una secuencia suficientemente organizada de operaciones elementales, una máquina extremadamente simple puede realizar cálculos extraordinariamente complejos.
No se necesita explicar matemáticamente q0, q1 y q2 en esta entrada. Con que el lector entienda que significan “situación A, situación B, situación C”, la ilustración ya cumple perfectamente su función.
3.2. Computación, algoritmos y resolución de problemas
La computación puede entenderse como el proceso de transformar un problema en una secuencia de operaciones suficientemente precisa como para que pueda ser ejecutada por una máquina. Esta idea parece sencilla, pero constituye uno de los cambios intelectuales más profundos del siglo XX. Antes de que existieran los ordenadores modernos, resolver un problema dependía muchas veces de la intuición, de la experiencia o de procedimientos no completamente formalizados. La teoría de la computación introdujo otra exigencia: si queremos que una máquina resuelva una tarea, debemos especificar con claridad qué información recibe, qué operaciones puede realizar, en qué orden deben ejecutarse y bajo qué condiciones termina el proceso. El algoritmo se convierte así en un puente entre el problema y la máquina. No es simplemente una lista de instrucciones, sino una descripción estructurada de un método que debe conducir desde unos datos iniciales hasta un resultado.
Un algoritmo eficaz necesita varias propiedades. Sus pasos deben estar definidos con suficiente precisión para evitar ambigüedades, deben poder ejecutarse mediante operaciones elementales y, en los problemas que admiten solución algorítmica, deben conducir a un resultado después de un número finito de etapas. Esta formalización permite separar dos cuestiones que a menudo se confunden: comprender un problema y disponer de un procedimiento para resolverlo. Una persona puede intuir una respuesta o reconocer un patrón sin ser capaz de explicar exactamente cómo ha llegado hasta él; una máquina, en cambio, necesita que el proceso pueda representarse mediante operaciones. El reto consiste por ello en traducir una tarea compleja a una estructura computable. Esa traducción exige decidir qué información es relevante, cómo debe representarse y qué estrategia puede transformar el estado inicial en una solución.
La resolución de problemas mediante algoritmos no implica necesariamente examinar todas las posibilidades. En muchos casos, hacerlo sería demasiado lento incluso para ordenadores muy potentes. Aquí aparece uno de los temas que después será central en inteligencia artificial: la búsqueda. Si un problema admite numerosas alternativas —movimientos posibles en un juego, rutas diferentes, combinaciones de decisiones o soluciones candidatas—, el sistema debe recorrer un espacio de posibilidades y determinar cuáles merecen ser exploradas. Algunos procedimientos garantizan encontrar una solución si existe, pero pueden necesitar enormes cantidades de tiempo o memoria. Otros utilizan reglas prácticas, llamadas heurísticas, para dirigir la búsqueda hacia opciones que parecen más prometedoras. Una heurística no garantiza necesariamente la mejor solución en todos los casos, pero puede hacer abordable un problema que de otro modo resultaría computacionalmente inmanejable. Esta tensión entre exactitud, tiempo y recursos acompañará desde el principio el desarrollo de la inteligencia artificial.
_Qué es un algoritmo sin tecnicismos:
Idea central: un algoritmo es una serie ordenada de pasos para resolver una tarea.
Ejemplo cotidiano:
Una receta de cocina funciona como un algoritmo: indica qué hacer, en qué orden y bajo qué condiciones.
Luego pasas a la computación:
Un ordenador resuelve problemas porque ejecuta instrucciones paso a paso.
Y enlazas con Turing:
_La importancia de Turing fue demostrar que muchos problemas podían expresarse como secuencias formales de operaciones.
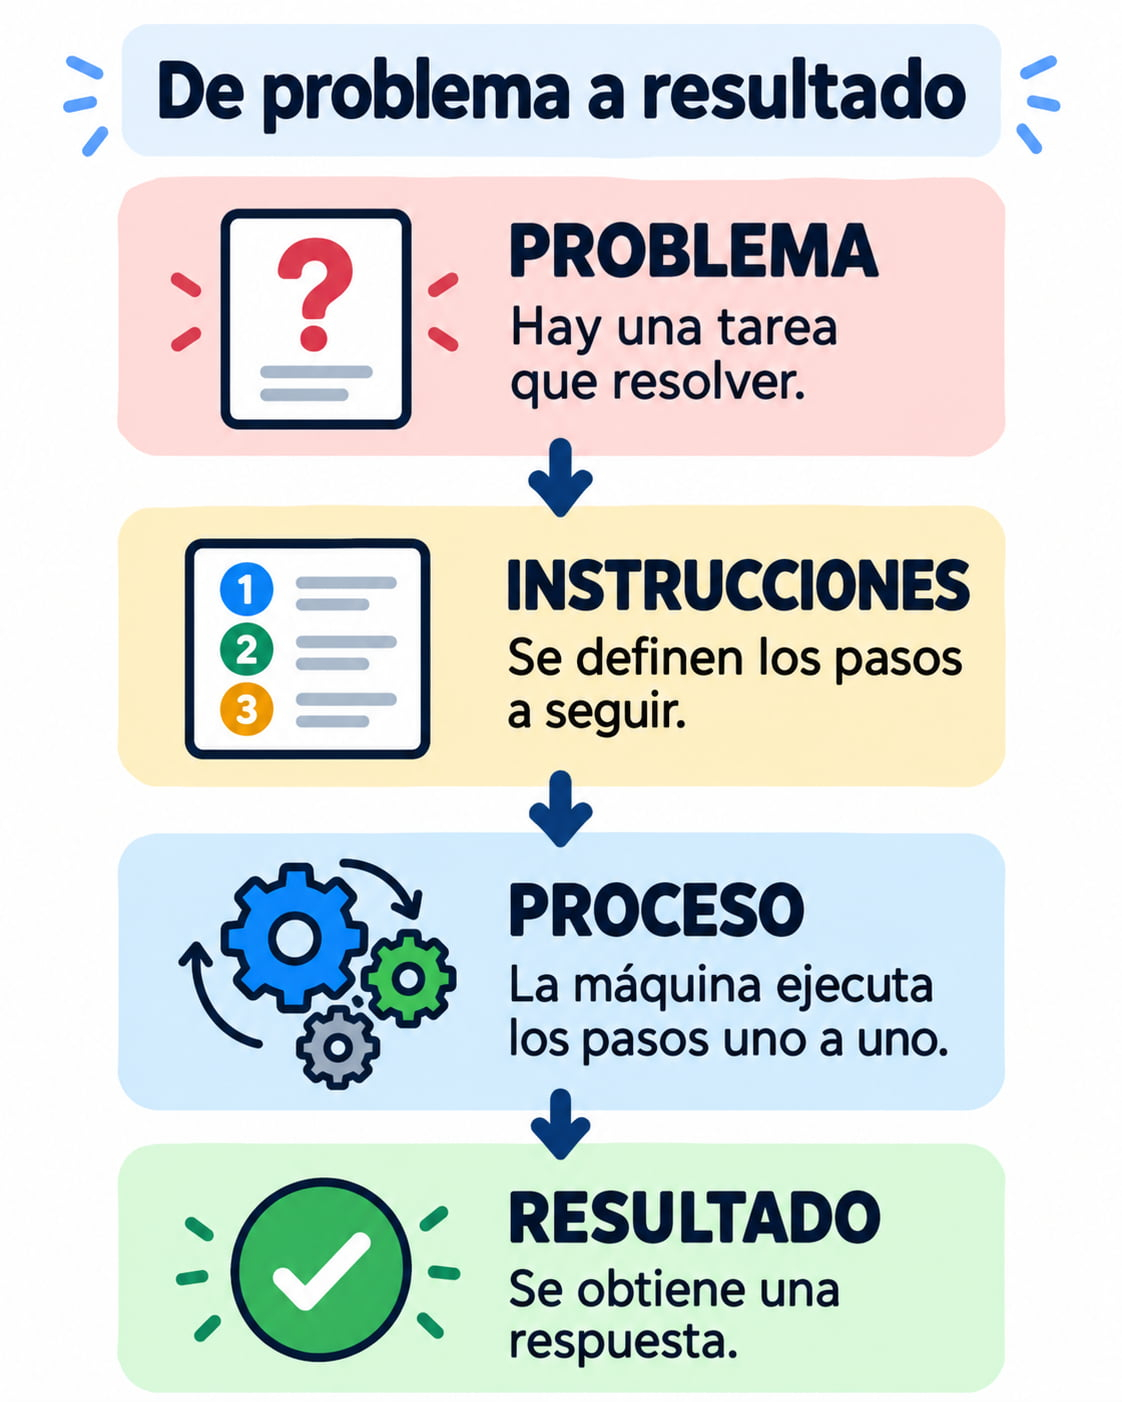
La computación también obliga a distinguir entre problemas difíciles y problemas imposibles de resolver mediante un algoritmo general. El trabajo de Turing mostró que existen límites teóricos que no dependen simplemente de disponer de máquinas más rápidas. Algunos problemas son indecidibles: no existe un procedimiento universal que pueda resolver correctamente todos sus casos. En otros, sí existe una solución algorítmica, pero el número de operaciones necesarias puede crecer de manera tan rápida con el tamaño del problema que su resolución práctica se vuelve extraordinariamente costosa. Esta diferencia entre computabilidad y complejidad es fundamental. Saber que un problema puede resolverse en principio no significa que pueda resolverse de forma útil con los recursos disponibles. La informática moderna se desarrolla precisamente en ese espacio entre lo posible en teoría y lo viable en la práctica.
Desde esta perspectiva, una gran parte de la inteligencia artificial puede entenderse como el intento de encontrar procedimientos computacionales para tareas que no admiten una solución sencilla mediante reglas directas. Resolver un rompecabezas, planificar una secuencia de acciones, interpretar una frase o seleccionar una respuesta adecuada implica trabajar con incertidumbre, información incompleta o espacios de posibilidades enormes. Los primeros investigadores de IA intentaron abordar muchos de estos problemas mediante algoritmos de búsqueda, reglas lógicas y representaciones explícitas del conocimiento. Más adelante aparecerían métodos capaces de aprender patrones a partir de datos, pero la pregunta fundamental permaneció: ¿cómo transformar una tarea aparentemente inteligente en operaciones que una máquina pueda ejecutar? La respuesta no consiste siempre en imitar paso a paso el pensamiento humano, sino en encontrar una representación y un procedimiento que permitan obtener resultados útiles mediante computación.
Esta forma de plantear los problemas cambió profundamente la relación entre máquina e inteligencia. Una computadora no necesita poseer una comprensión humana del objetivo para ejecutar un algoritmo que conduzca a una solución. Puede seguir reglas, comparar estados, evaluar alternativas y producir resultados mediante procesos completamente formales. A partir de ahí surge una cuestión inevitable: si una máquina puede resolver problemas que asociamos con el razonamiento, ¿hasta qué punto debemos considerar inteligente su comportamiento? Turing comprendió que la discusión ya no podía limitarse a lo que una máquina era físicamente capaz de calcular. Una vez establecida la potencia de la computación general, el siguiente paso consistía en enfrentarse a una pregunta mucho más difícil y mucho menos matemática: qué queremos decir exactamente cuando afirmamos que una máquina puede pensar.
3.3. «¿Pueden pensar las máquinas?»
En 1950, Alan Turing publicó en la revista Mind un artículo que acabaría convirtiéndose en uno de los textos fundacionales del debate moderno sobre la inteligencia artificial: Computing Machinery and Intelligence. Su punto de partida era tan directo como incómodo: ¿pueden pensar las máquinas? La pregunta parecía formular con sencillez un problema decisivo, pero Turing advirtió inmediatamente que encerraba una dificultad conceptual considerable. Ni la palabra «máquina» ni, sobre todo, el verbo «pensar» poseían una definición suficientemente precisa como para sostener por sí solos una investigación rigurosa. Intentar responder afirmativa o negativamente sin aclarar antes qué se estaba preguntando podía conducir a una discusión interminable sobre conceptos, intuiciones y definiciones. Por ello, Turing propuso sustituir el problema abstracto de determinar qué ocurre en el interior de una máquina por una cuestión que pudiera examinarse a través de su comportamiento.
Este cambio de enfoque era característico de su manera de abordar los problemas. En lugar de intentar resolver primero qué es el pensamiento en sentido filosófico, Turing buscó un criterio operativo que permitiera discutir las capacidades de una máquina sin depender de una teoría completa de la mente humana. La estrategia tenía una ventaja importante: evitaba convertir la investigación sobre máquinas inteligentes en una disputa previa acerca de la esencia de la inteligencia. Si se exigiera comprender completamente qué significa pensar antes de estudiar si una máquina puede hacerlo, el problema tecnológico quedaría subordinado a una cuestión filosófica todavía abierta. Turing prefirió preguntarse qué clase de conducta consideraríamos indicativa de inteligencia y si una máquina podría llegar a producirla. Así, el foco se desplazaba desde una propiedad interior difícil de observar hacia manifestaciones externas susceptibles de comparación.
La audacia de la propuesta se entiende mejor si se considera el contexto de la época. Los ordenadores electrónicos apenas comenzaban a desarrollarse y estaban asociados principalmente con cálculos científicos, militares y administrativos. Imaginar que aquellas máquinas pudieran mantener conversaciones, utilizar lenguaje, aprender o desarrollar comportamientos suficientemente complejos como para ser comparados con los humanos parecía una hipótesis extraordinariamente ambiciosa. Turing, sin embargo, no identificaba la inteligencia con una capacidad misteriosa reservada necesariamente a organismos biológicos. Su trabajo anterior sobre computación había demostrado la enorme generalidad de las máquinas programables: una misma estructura podía ejecutar procedimientos muy diferentes si recibía las instrucciones adecuadas. La cuestión era entonces hasta dónde podía extenderse esa versatilidad y si determinadas actividades vinculadas tradicionalmente al pensamiento podían también abordarse computacionalmente.
La pregunta «¿pueden pensar las máquinas?» introducía además una tensión que seguirá apareciendo en toda la historia de la inteligencia artificial. Cuando una máquina resuelve un problema, ¿debemos considerar que está razonando o simplemente afirmar que ejecuta un procedimiento? Si produce lenguaje coherente, ¿está comprendiendo lo que dice o únicamente manipulando estructuras? Estas preguntas no tienen respuestas automáticas, porque dependen en parte de lo que entendamos por pensamiento, comprensión e inteligencia. Turing evitó resolverlas mediante una definición absoluta. Su propuesta consistía en observar hasta qué punto las diferencias entre comportamiento humano y comportamiento artificial podían seguir detectándose en una situación controlada. La inteligencia dejaba así de presentarse únicamente como una esencia oculta y podía estudiarse también como un conjunto de capacidades expresadas mediante acciones observables.
Esta perspectiva no significaba que Turing considerara irrelevante la diferencia entre seres humanos y máquinas. Tampoco afirmaba que imitar una conducta humana demostrara de manera definitiva la existencia de conciencia, experiencia subjetiva o pensamiento idéntico al nuestro. El objetivo era más limitado y, al mismo tiempo, más útil para la investigación: formular una pregunta que pudiera ponerse a prueba. En su artículo examinó diversas objeciones a la posibilidad de máquinas inteligentes —de naturaleza matemática, religiosa, filosófica o relacionada con la creatividad y el aprendizaje— y mostró que muchas de ellas no bastaban para cerrar el problema. Especialmente importante era su interés por máquinas capaces de modificar su comportamiento a través de procesos de aprendizaje, una posibilidad que anticipaba una dirección que décadas después adquiriría enorme relevancia dentro de la inteligencia artificial.
La pregunta planteada por Turing conserva su fuerza precisamente porque permanece abierta a diferentes niveles de interpretación. Hoy sabemos que las máquinas pueden realizar numerosas tareas que en 1950 habrían parecido extraordinarias: reconocer imágenes, traducir idiomas, generar textos o resolver problemas complejos. Pero cada nuevo avance vuelve a plantear la misma cuestión bajo formas distintas: ¿qué demuestra realmente una capacidad observable y qué conclusiones podemos extraer de ella acerca de la inteligencia? Turing no ofreció una definición definitiva del pensamiento mecánico; propuso una manera más fértil de investigar el problema. En lugar de comenzar preguntando qué esencia debe poseer una máquina para ser considerada inteligente, sugirió estudiar qué comportamiento sería capaz de producir. Esa transformación metodológica conduciría directamente al juego de imitación, el experimento conceptual con el que intentó convertir una pregunta filosófica extraordinariamente difícil en una prueba basada en la interacción.
«¿Pueden pensar las máquinas?»
Empezaría con una pregunta:
¿Qué significa realmente “pensar”?
Turing vio un problema: si no sabemos definir perfectamente qué es pensar, es difícil decidir si una máquina piensa o no.
Por eso propuso cambiar la pregunta.
En vez de preguntar:
“¿La máquina piensa?”
planteó algo más observable:
“¿Puede comportarse de forma que no distingamos fácilmente si estamos hablando con una persona o con una máquina?”
Ese giro conceptual es lo importante.
¿Pueden pensar las máquinas? La frontera entre inteligencia humana y artificial. La pregunta planteada por Alan Turing en 1950 no buscaba demostrar que una máquina pensara como una persona, sino encontrar una forma observable de estudiar si su comportamiento podía llegar a parecer inteligente.
La cuestión «¿pueden pensar las máquinas?» parece sencilla, pero encierra un problema profundo: antes de responderla tendríamos que saber con precisión qué significa pensar. ¿Pensar implica razonar, aprender, recordar, comprender, tener conciencia o simplemente producir respuestas adecuadas ante una situación? Turing advirtió que intentar resolver directamente esa pregunta conducía rápidamente a dificultades filosóficas difíciles de comprobar.
Por ello propuso un cambio de perspectiva. En lugar de investigar qué ocurre «dentro» de una máquina, sugirió observar lo que la máquina hace. Si un sistema es capaz de mantener una conversación, resolver problemas o responder de manera que un observador no pueda distinguir fácilmente su comportamiento del de una persona, entonces existe al menos una base objetiva para hablar de conducta inteligente.
Este desplazamiento desde el interior hacia el comportamiento fue una idea decisiva. Permitía estudiar la inteligencia de forma operacional: no era necesario demostrar que una máquina tuviera pensamientos, emociones o conciencia, sino analizar si podía ejecutar tareas asociadas habitualmente con la inteligencia humana.
La imagen de una mano humana aproximándose a una mano robótica simboliza precisamente ese encuentro entre dos formas muy distintas de procesar información. La semejanza exterior no implica identidad. Una persona y una máquina pueden llegar a producir respuestas similares por mecanismos completamente diferentes. El ser humano integra experiencia, memoria, cuerpo, emociones y conciencia; una máquina, en cambio, procesa información conforme a estructuras formales, reglas o modelos aprendidos a partir de datos.
Esta diferencia sigue siendo central en los debates contemporáneos sobre inteligencia artificial. Los sistemas actuales pueden conversar, generar imágenes, traducir idiomas o resolver determinados problemas con enorme eficacia, pero esas capacidades no permiten concluir automáticamente que exista detrás de ellas una experiencia consciente comparable a la humana. La pregunta de Turing conserva así toda su vigencia: ¿debemos definir la inteligencia por lo que un sistema es internamente o por lo que es capaz de hacer?….
Ese interrogante abrió una de las líneas de reflexión más influyentes de la informática moderna y continúa acompañando el desarrollo de la inteligencia artificial hasta nuestros días.
3.4. El juego de imitación y el test de Turing
Para transformar la pregunta abstracta sobre si una máquina puede pensar en un problema observable, Alan Turing propuso en 1950 un experimento intelectual conocido como juego de imitación. La idea consistía en evitar toda discusión directa sobre la naturaleza interna de la mente y concentrarse en la interacción. Un interrogador debía comunicarse mediante mensajes escritos con interlocutores que no podía ver. En la versión reformulada por Turing para pensar el problema de las máquinas, uno de esos interlocutores podía ser un ser humano y el otro una máquina. Si, después de una conversación suficientemente rica, el interrogador no era capaz de distinguir de manera fiable cuál era cuál, la máquina habría mostrado un comportamiento lingüístico difícil de diferenciar del humano. Con ello, Turing no pretendía abrir una ventana al interior de la máquina, sino establecer una prueba basada en lo que esta era capaz de hacer en una situación concreta.
La elección del lenguaje escrito era fundamental. Si el interrogador pudiera ver al participante artificial, escuchar su voz mecánica o examinar su apariencia física, la prueba mediría características irrelevantes para la cuestión que Turing quería explorar. El intercambio textual eliminaba esas diferencias y concentraba la atención en la capacidad para responder preguntas, mantener una conversación, seguir referencias, realizar cálculos, manejar ambigüedades o reaccionar de manera coherente ante situaciones planteadas por el interlocutor. En principio, el interrogador podía preguntar prácticamente cualquier cosa, por lo que la máquina tendría que desenvolverse en un espacio muy amplio de temas y formas de expresión. El desafío no consistía simplemente en almacenar respuestas predeterminadas, sino en sostener una interacción suficientemente flexible como para que su origen artificial no resultara evidente.
Con el tiempo, esta propuesta pasó a conocerse popularmente como test de Turing, aunque esa denominación puede dar la impresión equivocada de que existe una prueba única, perfectamente estandarizada y capaz de otorgar un certificado definitivo de inteligencia. El planteamiento original era ante todo un recurso conceptual para reformular una cuestión difícil. Turing pretendía mostrar que podía estudiarse el comportamiento de una máquina sin resolver previamente todos los problemas filosóficos relacionados con la mente. El test no mide conciencia, emociones, experiencia subjetiva ni una supuesta esencia interior del pensamiento. Evalúa, en un contexto determinado, la capacidad de producir respuestas lingüísticas que un observador humano pueda considerar comparables a las de otra persona. Esta diferencia es importante porque superar una interacción de este tipo y poseer inteligencia en todos los sentidos posibles son afirmaciones muy distintas.
El juego de imitación también introduce una idea profundamente influyente: la inteligencia puede analizarse, al menos parcialmente, a través del desempeño. En lugar de preguntar de qué está hecho un sistema o si sus procesos internos se parecen a los del cerebro, podemos examinar qué tareas es capaz de realizar. Esta perspectiva tuvo una enorme utilidad para la inteligencia artificial porque ofrecía objetivos concretos: utilizar lenguaje, resolver preguntas, mantener coherencia, adaptarse al contexto o proporcionar respuestas apropiadas. Al mismo tiempo, abrió una discusión que continúa vigente. Un sistema podría producir una imitación lingüística muy convincente utilizando mecanismos completamente diferentes de los humanos. ¿Debemos considerar suficiente esa equivalencia conductual o necesitamos además explicar cómo se producen las respuestas? El test no elimina esta cuestión; simplemente muestra que comportamiento y mecanismo interno pueden estudiarse por separado.
La propuesta ha recibido numerosas críticas y reinterpretaciones. Un programa podría intentar engañar al interrogador mediante evasivas, errores deliberados o estrategias destinadas a parecer humano sin demostrar por ello capacidades intelectuales profundas. Del mismo modo, una máquina podría poseer capacidades científicas o matemáticas extraordinarias y fracasar en una conversación cotidiana, lo que plantearía dudas sobre la conveniencia de utilizar una única prueba lingüística como medida general de inteligencia. Tampoco todos los seres humanos responderían de la misma manera ante una entrevista, por lo que la propia referencia humana resulta variable. Estas objeciones no invalidan necesariamente el valor histórico del juego de imitación, pero recuerdan que se trata de un criterio parcial y dependiente del contexto, no de una definición universal de inteligencia.
Los avances recientes en sistemas conversacionales han dado al experimento una actualidad inesperada. Hoy existen máquinas capaces de producir lenguaje fluido, adaptar el tono de una respuesta, resumir información o mantener conversaciones prolongadas, capacidades que en tiempos de Turing parecían muy lejanas. Sin embargo, esta evolución también ha hecho más visibles las limitaciones del criterio puramente conversacional. Un sistema puede expresarse con naturalidad y, al mismo tiempo, cometer errores factuales, inventar información o mostrar inconsistencias. La fluidez lingüística puede generar una fuerte impresión de comprensión, pero esa impresión necesita analizarse separadamente del funcionamiento real del sistema. Cuanto más convincente es la conversación, más importante resulta distinguir entre la apariencia de inteligencia y las capacidades efectivamente demostradas.
El valor duradero del test de Turing reside, por tanto, menos en haber resuelto la pregunta sobre las máquinas inteligentes que en haber cambiado la forma de plantearla. En vez de exigir una definición metafísica de pensamiento, propuso observar una conducta concreta y someterla a comparación. Ese desplazamiento permitió convertir una cuestión filosófica en un problema susceptible de investigación experimental y tecnológica. Al mismo tiempo, dejó abierta una dificultad que acompañará a toda la inteligencia artificial posterior: hasta qué punto un comportamiento inteligente permite inferir pensamiento, comprensión o inteligencia en un sentido más profundo. Esa tensión entre lo que una máquina hace y lo que atribuimos a su funcionamiento conduce directamente al siguiente problema: la relación entre pensamiento, comportamiento e inteligencia.
El significado del test de Turing
La propuesta de Turing no pretendía demostrar que una máquina tuviera conciencia, emociones o una forma de pensamiento idéntica a la humana. El objetivo era mucho más concreto: disponer de un criterio observable para valorar hasta qué punto una máquina podía producir respuestas lingüísticas comparables a las de una persona.
La importancia del juego de imitación reside precisamente en ese cambio de enfoque. En lugar de intentar descubrir qué sucede en el interior de la máquina, algo difícil de determinar incluso cuando hablamos de otros seres humanos, Turing propuso examinar su comportamiento. Si durante una conversación escrita un observador no podía identificar de manera fiable cuál de sus interlocutores era la máquina, esta habría mostrado, al menos en ese contexto, una conducta difícil de distinguir de la humana.
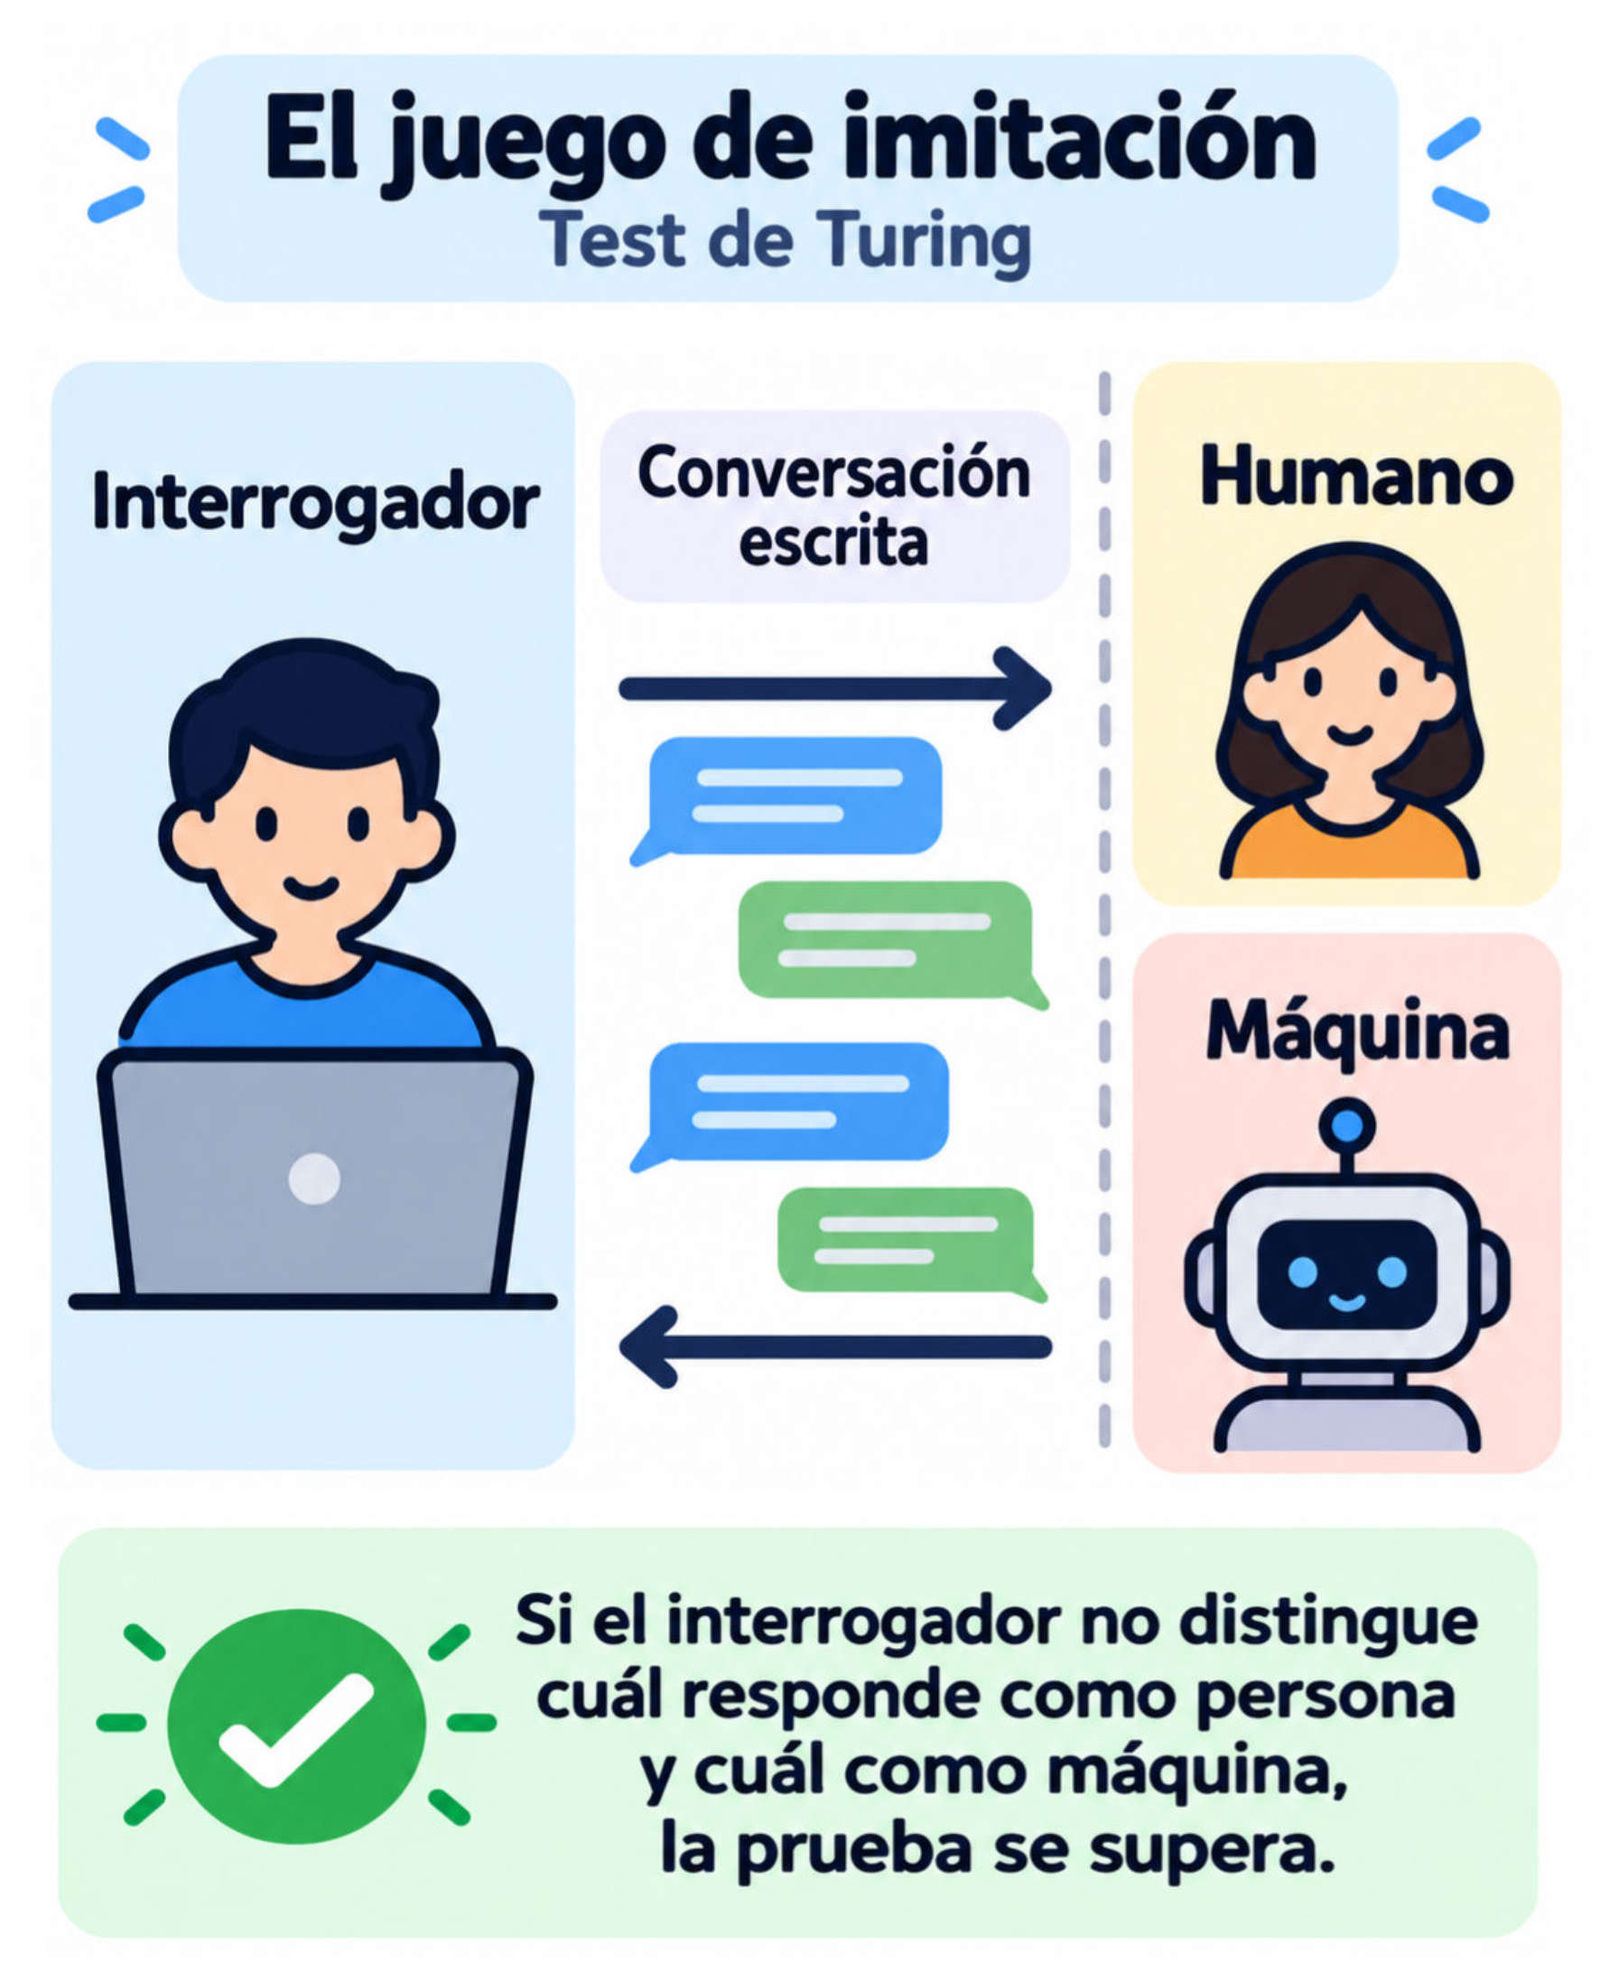
El test no constituye, por tanto, una definición definitiva de inteligencia. Una máquina podría superarlo sin comprender el mundo del mismo modo que una persona, y también podría poseer capacidades extraordinarias que el propio test no midiera. Su verdadero valor histórico está en haber convertido una cuestión filosófica muy abstracta —«¿pueden pensar las máquinas?»— en un problema susceptible de observación, discusión y experimentación.
El problema quedaba así abierto: comportarse inteligentemente y pensar, ¿son necesariamente la misma cosa?
3.5. Pensamiento, comportamiento e inteligencia
El juego de imitación de Turing dejó planteada una cuestión que desborda ampliamente la prueba conversacional: ¿qué relación existe entre comportarse de manera inteligente y poseer realmente inteligencia? El problema aparece porque aquello que podemos observar directamente en otra persona —sus palabras, decisiones, respuestas o acciones— no es idéntico a los procesos internos que suponemos detrás de ese comportamiento. En la vida cotidiana atribuimos pensamiento a los demás porque compartimos una naturaleza biológica semejante, conocemos nuestra propia experiencia mental y reconocemos conductas parecidas a las nuestras. Con una máquina, esa continuidad desaparece. Podemos observar lo que hace, medir su rendimiento e incluso mantener con ella una interacción compleja, pero de ahí no se sigue automáticamente que sus procesos internos sean comparables a los humanos. La inteligencia artificial obliga así a separar tres conceptos que el lenguaje corriente suele mezclar: pensamiento, comportamiento e inteligencia.
El comportamiento es el aspecto más accesible porque puede describirse desde fuera. Una máquina responde correctamente a una pregunta, encuentra una solución, adapta una estrategia o mantiene una conversación; esas acciones pueden comprobarse sin necesidad de afirmar nada sobre una supuesta vida mental interior. Esta perspectiva posee una gran ventaja científica: permite establecer criterios de rendimiento y comparar sistemas mediante tareas concretas. Buena parte de la investigación en inteligencia artificial se desarrollará precisamente de esta manera, evaluando qué problemas puede resolver un programa y con qué eficacia. Pero reducir toda la inteligencia al comportamiento introduce dificultades. Dos sistemas pueden producir una respuesta semejante mediante procedimientos completamente distintos, y una conducta convincente puede ocultar errores, limitaciones o mecanismos muy diferentes de aquellos que imaginamos. El resultado observable es una parte esencial del fenómeno, aunque no necesariamente explique su naturaleza.
El pensamiento plantea un problema distinto porque solemos relacionarlo con procesos internos: formar conceptos, recordar, deliberar, imaginar, comprender significados o relacionar experiencias. En los seres humanos estas actividades están asociadas al funcionamiento del cerebro, al cuerpo, a la percepción y a una biografía individual que se desarrolla dentro de un mundo social. Una máquina puede ejecutar operaciones que producen resultados similares a los obtenidos mediante algunas de esas capacidades sin reproducir el proceso humano que conduce a ellos. Un programa de ajedrez puede seleccionar una jugada extraordinaria mediante métodos que no se parecen a la deliberación de un jugador humano; un sistema lingüístico puede construir una frase adecuada utilizando representaciones y cálculos que no equivalen a la experiencia subjetiva del lenguaje. La semejanza del resultado, por tanto, no demuestra identidad del proceso. Tampoco significa que el procedimiento artificial carezca de valor: simplemente exige distinguir con precisión niveles diferentes de explicación.
La inteligencia resulta todavía más difícil de delimitar porque parece abarcar una familia de capacidades en lugar de una propiedad única. Resolver problemas, aprender de la experiencia, adaptarse, planificar, utilizar lenguaje, reconocer patrones o transferir conocimientos entre situaciones pueden considerarse manifestaciones de inteligencia, pero un mismo sistema no necesita poseerlas todas en igual grado. Esta circunstancia es especialmente visible en las máquinas. Una inteligencia artificial puede sobresalir espectacularmente en una tarea y mostrar enormes limitaciones fuera de ella. El rendimiento elevado en un dominio no autoriza por sí solo a atribuir una inteligencia general comparable a la humana. De manera inversa, exigir que una máquina reproduzca todo el repertorio cognitivo humano antes de reconocer cualquier capacidad inteligente convertiría la comparación en un criterio excesivamente rígido. Resulta más útil describir capacidades concretas y estudiar cómo se relacionan entre sí que intentar decidir mediante una única etiqueta si una máquina es o no «inteligente».
La lámina resume de forma visual una distinción central para entender este problema. El esquema permite ver con claridad que pensamiento, comportamiento e inteligencia son ideas relacionadas, pero no equivalentes. Resulta más útil describir capacidades concretas y estudiar cómo se relacionan entre sí que intentar decidir mediante una única etiqueta si una máquina es o no «inteligente». Se resume visualmente esa distinción.
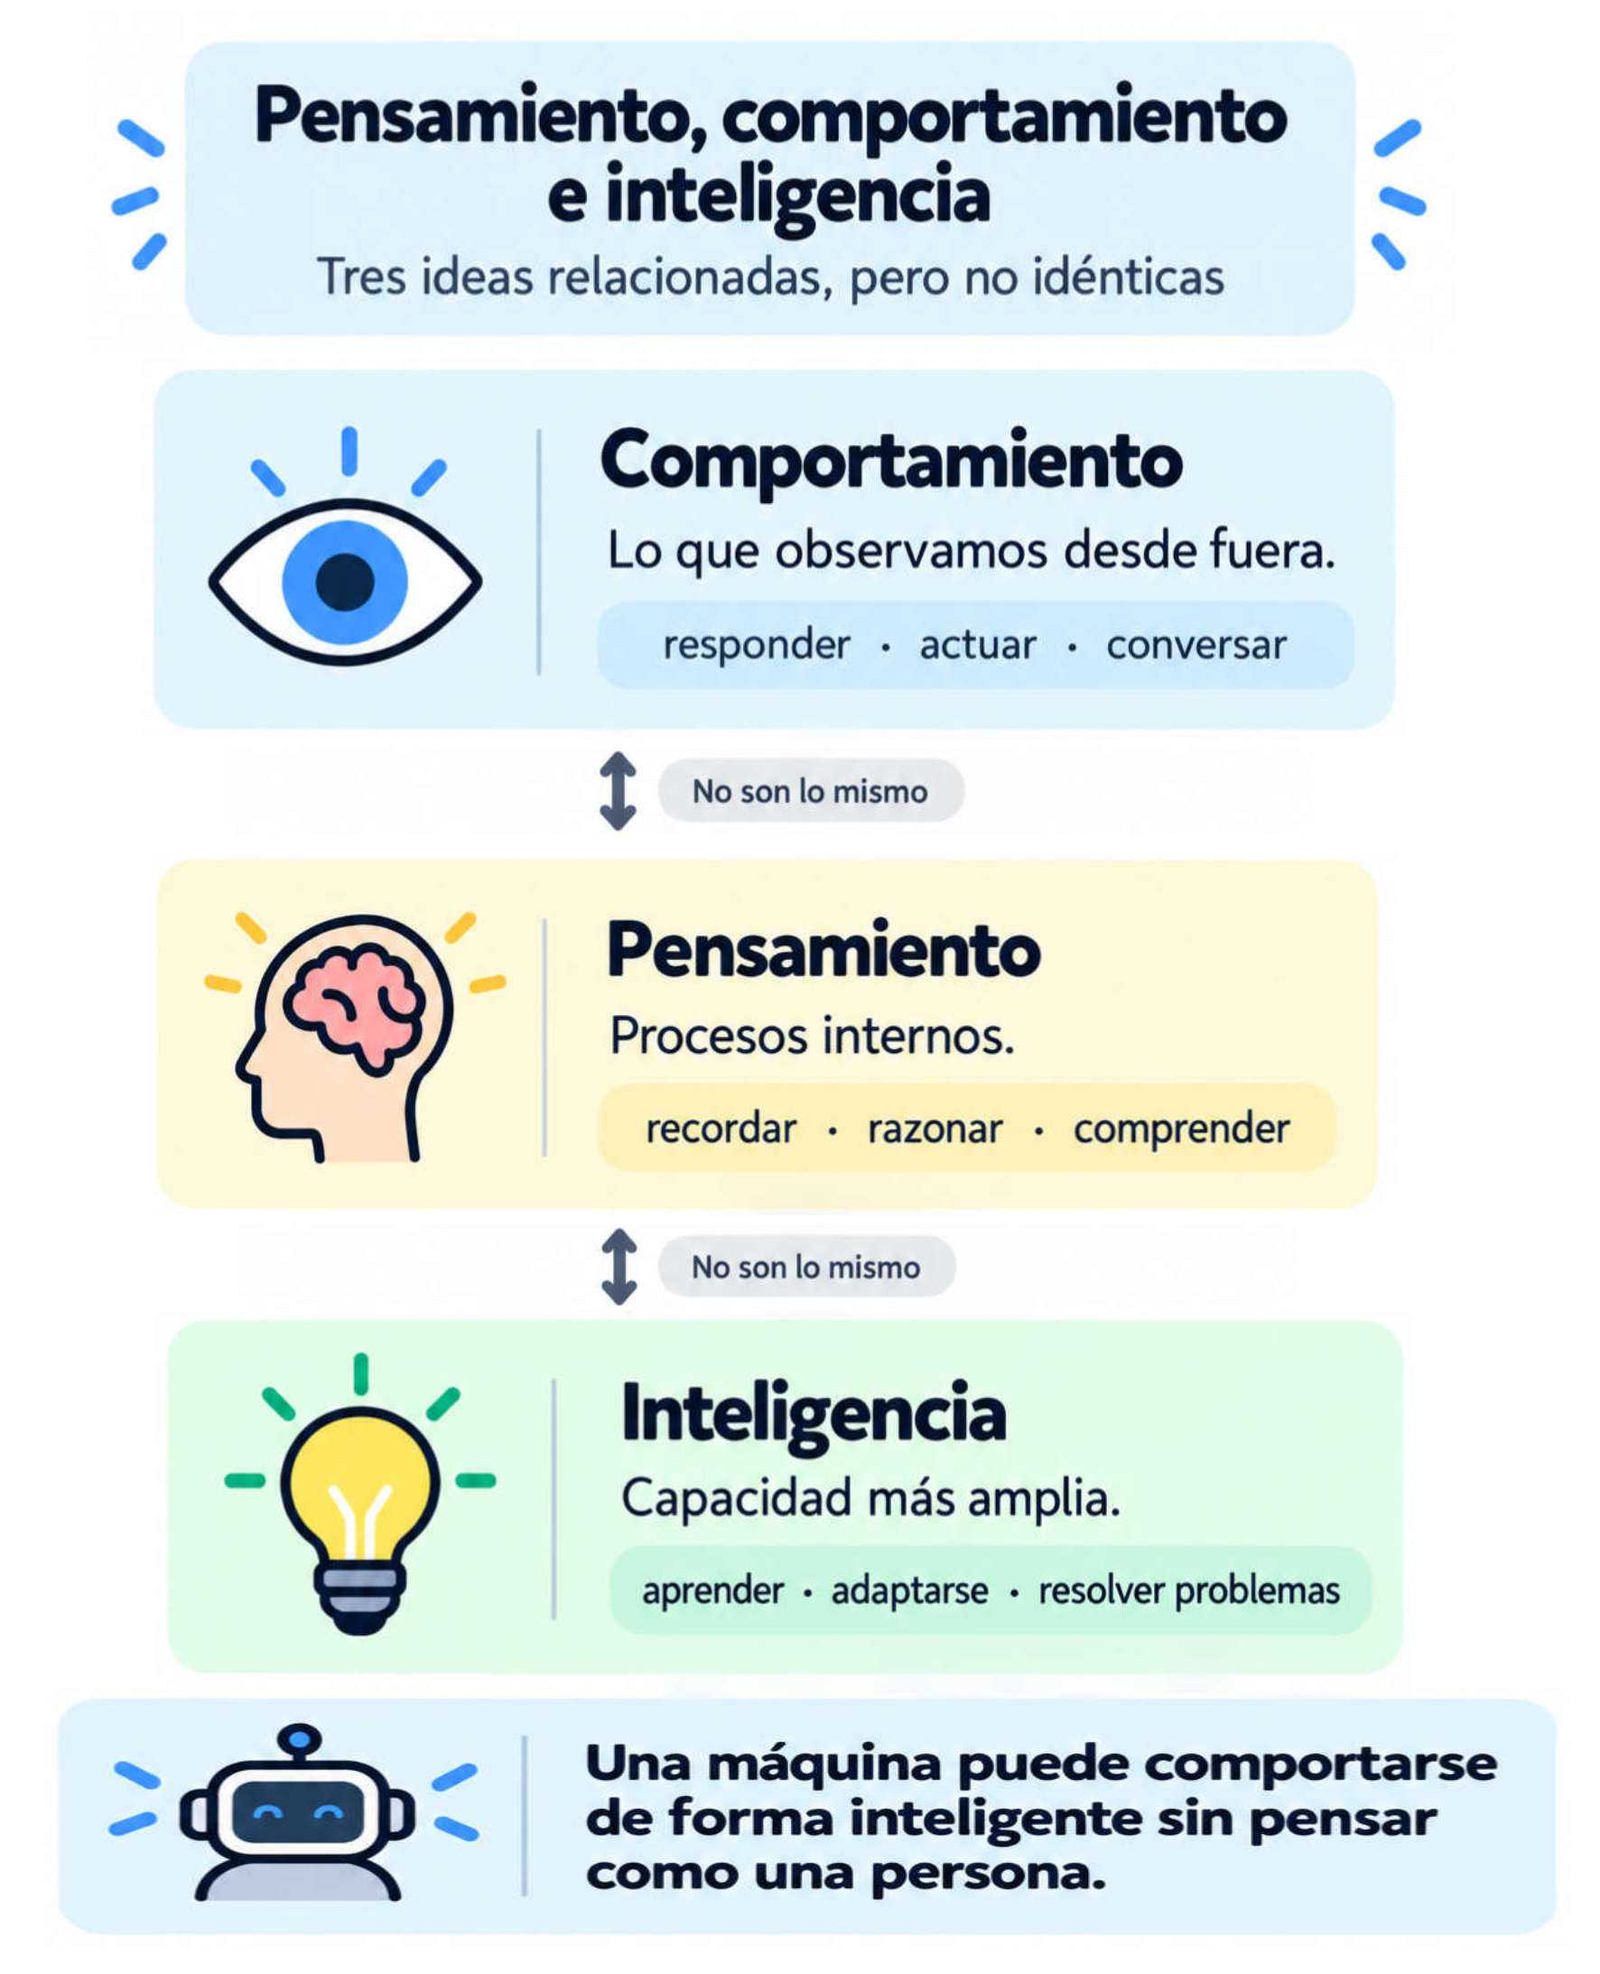
La lámina sintetiza tres niveles que con frecuencia se confunden en el lenguaje corriente. El comportamiento es lo más visible, porque se refiere a lo que puede observarse desde fuera: responder preguntas, conversar, ejecutar acciones o resolver tareas. El pensamiento, en cambio, alude a procesos internos más difíciles de precisar, como recordar, razonar, relacionar ideas o comprender significados. La inteligencia constituye una noción más amplia, ya que engloba capacidades como aprender, adaptarse a situaciones nuevas y resolver problemas con eficacia.
Esta distinción resulta especialmente útil en el terreno de la inteligencia artificial. Un sistema puede ofrecer respuestas convincentes, reconocer patrones o desenvolverse con éxito en una tarea concreta sin reproducir necesariamente los procesos mentales humanos. Por eso, al estudiar la inteligencia de las máquinas, no basta con fijarse solo en el resultado visible: también importa preguntarse qué tipo de procedimiento interviene, qué capacidades reales posee el sistema y hasta qué punto ese rendimiento puede compararse con el de una mente humana. La relevancia de Turing consistió precisamente en hacer tratable esta cuestión, desplazando la atención desde afirmaciones abstractas sobre “pensar” hacia criterios observables y comparables.
Estas distinciones conducen a una cuestión filosófica que acompañará permanentemente a la inteligencia artificial: ¿es suficiente reproducir una función para afirmar que existe el mismo fenómeno que en una mente humana? Algunas perspectivas han concedido gran importancia a la organización funcional y al comportamiento observable; otras han insistido en que comprender, tener intenciones o poseer experiencia consciente no puede reducirse simplemente a producir respuestas adecuadas. La discusión sigue abierta y afecta a conceptos que pertenecen tanto a la filosofía de la mente como a la psicología, la neurociencia y la informática. Para estudiar científicamente los sistemas artificiales, sin embargo, no es necesario resolver de una vez todos esos problemas. Podemos analizar cómo representan información, cómo obtienen respuestas, qué capacidades desarrollan y cuáles son sus límites sin atribuirles automáticamente conciencia, intención o experiencia subjetiva.
Esta cautela resulta especialmente importante porque los seres humanos tendemos a interpretar comportamientos complejos mediante categorías sociales. Una máquina que utiliza correctamente pronombres, expresa cortesía o responde con aparente sensibilidad puede provocar espontáneamente la impresión de que existe un sujeto detrás de sus palabras. Esa reacción dice tanto sobre nuestra forma de interpretar el mundo como sobre la tecnología. La investigación de la inteligencia artificial necesita conservar una diferencia entre descripción e interpretación: afirmar que un sistema genera una respuesta coherente es una observación; afirmar que comprende esa respuesta exige un criterio adicional acerca de qué significa comprender. Turing ayudó a convertir el comportamiento en una cuestión científicamente tratable, pero no eliminó la distancia conceptual entre actuar inteligentemente y poseer todos los atributos que asociamos con una mente.
La importancia de estas preguntas no reside únicamente en la filosofía. Determinan cómo evaluamos los sistemas, qué expectativas depositamos en ellos y qué tipo de problemas consideramos legítimo intentar resolver mediante computación. La inteligencia artificial nacerá como disciplina en un terreno marcado precisamente por esta tensión: construir programas capaces de realizar tareas que requieren inteligencia cuando las ejecutan personas, sin disponer todavía de una definición única y definitiva de inteligencia. El legado de Turing consistió en mostrar que esa incertidumbre no impedía avanzar. Era posible investigar capacidades concretas, construir máquinas, comparar comportamientos y formular hipótesis cada vez más precisas. Esa combinación de rigor matemático y apertura conceptual ejercería una influencia profunda sobre los investigadores que, pocos años después, empezarían a considerar la inteligencia de las máquinas no solo como una pregunta filosófica, sino como un programa científico.
3.6. La influencia de Turing en la inteligencia artificial
La influencia de Alan Turing sobre la inteligencia artificial no puede reducirse a una única idea ni a un descubrimiento aislado. Su aportación fue más profunda porque ayudó a definir el terreno intelectual en el que la disciplina podría llegar a existir. Antes de que la inteligencia artificial tuviera un nombre propio, Turing había contribuido a establecer qué significa computar, había mostrado la potencia de una máquina de propósito general y había planteado de forma explícita la posibilidad de que una máquina manifestara comportamientos asociados con la inteligencia. Su importancia reside, por tanto, en haber conectado fundamentos matemáticos, arquitectura computacional y reflexión sobre la mente dentro de un mismo horizonte. No fundó por sí solo la inteligencia artificial ni diseñó los primeros grandes programas de la disciplina, pero muchas de las preguntas que formularían posteriormente sus investigadores ya estaban presentes, de una forma extraordinariamente anticipada, en sus trabajos.
Uno de sus legados más importantes fue la idea de que una máquina general podía ejecutar procedimientos muy diferentes siempre que estos pudieran expresarse de manera adecuada. Esa concepción proporcionó una base teórica para entender el ordenador como un instrumento flexible, capaz de cambiar de función mediante programas. La inteligencia artificial necesitaba precisamente ese tipo de máquina. Construir un dispositivo específico para cada problema habría limitado enormemente las posibilidades de investigación; disponer de ordenadores programables permitía ensayar estrategias distintas sobre un mismo hardware. Resolver problemas, jugar, utilizar símbolos, analizar lenguaje o aprender patrones podían abordarse como programas diferentes ejecutados en una arquitectura general. Esta versatilidad fue una condición fundamental para que la IA pudiera desarrollarse como campo experimental y no solo como una colección de mecanismos especializados.
Turing también anticipó una cuestión que después se volvería central: la posibilidad de construir máquinas capaces de aprender. En su artículo de 1950 sugirió que quizá fuera más útil intentar crear una especie de “máquina-niño” susceptible de ser educada que intentar programar directamente una mente adulta completa. La idea era notable porque introducía la posibilidad de que parte de la competencia de una máquina surgiera mediante un proceso de entrenamiento y modificación progresiva, no únicamente a través de reglas introducidas de una vez por un programador. El concepto todavía estaba lejos de los métodos actuales de aprendizaje automático, pero apuntaba hacia una dirección decisiva: construir sistemas cuyo comportamiento pudiera desarrollarse mediante experiencia, retroalimentación o selección de respuestas. Décadas más tarde, el aprendizaje se convertiría en uno de los grandes pilares de la inteligencia artificial contemporánea.
Otra herencia profunda procede de su manera de formular problemas. Turing prefería convertir cuestiones vagas en situaciones susceptibles de análisis. La pregunta filosófica sobre si una máquina podía pensar se transformó en un problema relacionado con comportamiento, interacción y evaluación. Esta actitud influyó en una disciplina que, desde sus comienzos, tendría que encontrar formas de medir capacidades difíciles de definir de manera absoluta. En inteligencia artificial no basta con afirmar que un sistema “razona”, “comprende” o “aprende”; es necesario diseñar tareas, pruebas y criterios que permitan observar qué hace realmente. El test asociado a Turing fue solo una de esas propuestas, pero su espíritu metodológico es más amplio: sustituir afirmaciones generales por demostraciones concretas de capacidad y someter los sistemas a situaciones donde su rendimiento pueda ser examinado.
Su influencia alcanzó igualmente la concepción de los límites de la computación. Turing había demostrado que existen problemas que ningún algoritmo general puede resolver, una conclusión esencial para evitar una visión ilimitada del poder de las máquinas. La inteligencia artificial heredaría ese equilibrio entre ambición y restricción. El hecho de que los ordenadores puedan ejecutar procedimientos extraordinariamente complejos no implica que cualquier problema pueda convertirse sin dificultad en una solución computacional. Algunas tareas requieren cantidades prohibitivas de recursos, otras dependen de información incompleta y otras plantean cuestiones cuya formalización resulta difícil. Esta conciencia de los límites ayuda a situar la IA dentro de la ciencia de la computación: sus avances se producen dentro de un marco donde la potencia de los algoritmos convive con restricciones matemáticas, técnicas y prácticas.
La influencia de Alan Turing en la inteligencia artificial
El legado de Turing no procede de una única aportación, sino de la combinación de varias ideas decisivas: la computación de propósito general, la programación, la posibilidad de aprendizaje, la evaluación del comportamiento, los límites de los algoritmos y una forma experimental de estudiar capacidades asociadas con la inteligencia.
La influencia de Turing puede resumirse en varios ejes que conectan los fundamentos de la computación con algunas de las preguntas centrales de la inteligencia artificial.
Los distintos elementos de la lámina no representan una sucesión cronológica estricta, sino las principales líneas de influencia intelectual de Turing. Su trabajo ayudó a establecer qué significa computar y mostró que una máquina general puede ejecutar tareas muy diferentes mediante programas. También anticipó la posibilidad de construir sistemas capaces de modificar su comportamiento mediante aprendizaje, propuso criterios observables para estudiar conductas asociadas con la inteligencia y contribuyó a determinar que existen límites fundamentales a lo que puede resolverse algorítmicamente.
Consideradas en conjunto, estas aportaciones ayudaron a transformar la relación entre máquinas e inteligencia. El ordenador dejó de concebirse únicamente como una herramienta de cálculo para convertirse en un sistema general capaz de ejecutar procedimientos, resolver problemas y ser sometido a experimentación. Sobre ese terreno conceptual se desarrollaría, pocos años después, la inteligencia artificial como disciplina científica.
La figura de Turing influyó además de manera simbólica en generaciones posteriores de investigadores. Su trabajo mostraba que cuestiones que parecían pertenecer exclusivamente a la filosofía podían convertirse en problemas científicos sin perder necesariamente su profundidad. Inteligencia, lenguaje, aprendizaje o resolución de problemas podían estudiarse mediante modelos, programas y experimentos. Esta orientación sería asumida, pocos años después, por quienes comenzaron a construir los primeros programas explícitamente destinados a reproducir capacidades intelectuales. Sin embargo, conviene evitar una lectura demasiado lineal: la inteligencia artificial nació de múltiples tradiciones —lógica, matemáticas, neurociencia, teoría de la información, psicología y computación— y contó con numerosos investigadores decisivos. Turing fue una figura fundamental dentro de ese entramado, no su único origen.
Su legado puede resumirse en una transformación de perspectiva. La máquina dejó de ser vista únicamente como instrumento de cálculo para convertirse en un sistema potencialmente capaz de ejecutar procedimientos complejos, modificar su comportamiento y producir respuestas que podían estudiarse en relación con la inteligencia. Turing ayudó a establecer tanto la potencia como los límites de esa idea. Cuando, pocos años después de su muerte, un grupo de investigadores comenzó a hablar explícitamente de “inteligencia artificial” y a proponer programas capaces de resolver problemas o manipular símbolos, el terreno conceptual ya estaba preparado en gran medida. La pregunta había cambiado de escala: ya no se trataba solo de saber si las máquinas podían calcular, sino de investigar qué formas de actividad intelectual podían llegar a convertirse en procesos computacionales.
A mediados de la década de 1950 comenzó a ocurrir algo decisivo: problemas que hasta entonces habían pertenecido a terrenos separados —la lógica, la computación, el estudio del cerebro, la resolución de problemas y la reflexión sobre la inteligencia— empezaron a reunirse bajo un mismo programa científico. Los ordenadores todavía eran máquinas enormes, costosas y muy limitadas en comparación con cualquier dispositivo actual, pero ya habían demostrado que podían ejecutar procedimientos complejos a una velocidad imposible para el cálculo manual. La cuestión dejó entonces de ser únicamente qué operaciones podían automatizarse y comenzó a formularse de una manera mucho más ambiciosa: si determinadas capacidades asociadas al razonamiento podían describirse con suficiente precisión, quizá también pudieran construirse programas capaces de reproducir algunas de ellas. La inteligencia artificial estaba a punto de dejar de ser una posibilidad dispersa entre varias disciplinas para convertirse en un campo de investigación con objetivos, lenguaje y protagonistas propios.
El momento simbólico de ese nacimiento se sitúa habitualmente en el proyecto de investigación celebrado en Dartmouth College durante el verano de 1956. Su importancia no reside en que allí aparecieran de repente todas las ideas fundamentales de la inteligencia artificial, pues muchas tenían antecedentes claros, sino en que un grupo de investigadores se reunió alrededor de una hipótesis extraordinariamente audaz: que aspectos del aprendizaje y de la inteligencia podían describirse con tal precisión que una máquina llegara a simularlos. Al formular el problema de este modo, se establecía un horizonte común para investigaciones que hasta entonces habían avanzado por caminos parcialmente independientes. La inteligencia dejaba de contemplarse únicamente como objeto de reflexión filosófica o psicológica y comenzaba a tratarse también como un conjunto de capacidades susceptibles de representación y experimentación mediante programas.
En ese contexto apareció además una denominación destinada a perdurar. John McCarthy propuso la expresión «inteligencia artificial», un nombre suficientemente amplio como para reunir enfoques diferentes sin reducir el nuevo campo a la automatización del cálculo ni a la imitación directa del cerebro humano. Alrededor de aquellos primeros años se consolidó también una generación de investigadores cuyas ideas marcarían profundamente la disciplina. Marvin Minsky exploró diversos problemas relacionados con la representación del conocimiento y el funcionamiento de sistemas inteligentes; Herbert Simon y Allen Newell abordaron la resolución computacional de problemas y participaron en la creación de programas capaces de manipular símbolos de manera organizada. Sus trabajos mostraban que un ordenador podía utilizarse no solo para realizar operaciones numéricas, sino también para trabajar con estructuras formales que representaban decisiones, reglas, objetivos y posibles caminos hacia una solución.
Los primeros programas de inteligencia artificial reforzaron esa sensación de estar entrando en un territorio completamente nuevo. Algunos consiguieron demostrar teoremas, resolver rompecabezas o explorar diferentes alternativas hasta encontrar una respuesta adecuada. Vistos desde la actualidad pueden parecer modestos, pero en su momento tenían un significado profundo: mostraban que tareas vinculadas al razonamiento podían convertirse, al menos parcialmente, en procesos ejecutables por una máquina. Para ello era necesario representar el problema, establecer operaciones posibles y desarrollar métodos que permitieran elegir entre distintos caminos. La inteligencia comenzó así a estudiarse desde una perspectiva operativa: no era imprescindible reproducir todos los procesos de una mente humana para investigar una capacidad concreta; bastaba con formular una tarea y construir un sistema capaz de realizarla.
Aquellos éxitos iniciales generaron un optimismo extraordinario. Muchos investigadores confiaban en que problemas mucho más amplios podrían resolverse en un futuro relativamente cercano si aumentaba la capacidad de los ordenadores y se perfeccionaban los programas. Esa confianza tenía una base comprensible. En pocos años se había pasado de considerar a los ordenadores como instrumentos destinados principalmente al cálculo a utilizarlos para demostrar proposiciones, jugar, buscar soluciones y manipular símbolos. Cada resultado parecía sugerir que las dificultades restantes podían superarse mediante mejores métodos y máquinas más potentes. Sin embargo, todavía no se comprendía plenamente la enorme complejidad del conocimiento cotidiano, del lenguaje, de la percepción o de la adaptación a situaciones abiertas. La distancia entre resolver un problema cuidadosamente delimitado y desenvolverse con flexibilidad en el mundo real resultaría mucho mayor de lo que aquellos pioneros podían medir.
El nacimiento formal de la inteligencia artificial estuvo marcado, por tanto, por una combinación excepcional de rigor científico y ambición. Dartmouth proporcionó un punto de encuentro; McCarthy dio nombre al nuevo campo; Minsky, Simon, Newell y otros investigadores comenzaron a explorar distintas formas de convertir capacidades intelectuales en problemas computacionales; y los primeros programas ofrecieron pruebas suficientes para alimentar grandes expectativas. Durante unos años pareció plausible que la inteligencia pudiera ir descomponiéndose progresivamente en operaciones hasta construir sistemas cada vez más generales. Esa confianza impulsó investigaciones fundamentales, aunque también preparó el terreno para futuras decepciones. Antes de llegar a esas crisis será necesario observar con mayor detalle aquel momento inaugural, las personas que lo protagonizaron y los programas que hicieron pensar que una nueva ciencia de las máquinas inteligentes acababa realmente de comenzar.
4.1. La conferencia de Dartmouth de 1956
En el verano de 1956, Dartmouth College, en Hanover, New Hampshire, acogió una reunión que acabaría convirtiéndose en el gran punto de referencia para situar el nacimiento formal de la inteligencia artificial como disciplina. Suele hablarse de la «conferencia de Dartmouth», aunque en realidad se trató de un proyecto de investigación de varias semanas, concebido más como un taller de trabajo que como un congreso científico en el sentido actual. La propuesta había sido preparada el año anterior por John McCarthy, Marvin Minsky, Nathaniel Rochester y Claude Shannon, investigadores procedentes de ámbitos distintos pero unidos por una intuición común: determinadas capacidades asociadas al aprendizaje, al razonamiento y a la inteligencia podían estudiarse mediante máquinas. Aquella reunión no inventó de la nada la idea de las máquinas inteligentes, ni supuso el comienzo absoluto de todas las investigaciones relacionadas con ellas, pero proporcionó algo decisivo: un espacio, un vocabulario y una ambición compartida que ayudaron a reunir trabajos hasta entonces dispersos.
Conviene precisar la cronología. Aunque el encuentro de Dartmouth tuvo lugar en 1956, la expresión «artificial intelligence» ya figuraba en la propuesta redactada en 1955 para organizar el proyecto. John McCarthy empleó allí el término junto con Marvin Minsky, Nathaniel Rochester y Claude Shannon, anticipando el nombre con el que acabaría identificándose el nuevo campo. De este modo, 1955 marca la aparición formal de la denominación, mientras que 1956 representa el momento en que aquella propuesta comenzó a materializarse como programa de investigación colectivo.
La reunión de Dartmouth contribuyó además a consolidar la expresión «inteligencia artificial», introducida por McCarthy en la propuesta de 1955, como nombre del nuevo campo. Aquella propuesta partía de una hipótesis extraordinariamente atrevida para su tiempo. Sus organizadores consideraban que aspectos del aprendizaje y de otras capacidades intelectuales podían describirse con suficiente precisión como para intentar reproducirlos mediante sistemas computacionales. El planteamiento era mucho más amplio que construir calculadoras más rápidas. Incluía cuestiones relacionadas con el uso del lenguaje, la formación de conceptos, la resolución de problemas, la abstracción, el aprendizaje y la mejora del comportamiento de las máquinas. El ordenador comenzaba a imaginarse como un instrumento experimental para investigar funciones que hasta entonces habían pertenecido principalmente a la psicología, la lógica, las matemáticas o la filosofía. Esta convergencia de problemas explica por qué Dartmouth posee tanta importancia histórica: allí empezó a tomar forma la idea de que la inteligencia podía convertirse en objeto de una disciplina computacional propia.
Entre los investigadores vinculados al encuentro se encontraban algunas figuras que después desempeñarían papeles fundamentales en el desarrollo de la inteligencia artificial y de la ciencia de la computación. Además de McCarthy y Minsky, participaron o estuvieron relacionados con las sesiones investigadores como Claude Shannon, Nathaniel Rochester, Ray Solomonoff, Oliver Selfridge, Trenchard More, Herbert Simon y Allen Newell, aunque la asistencia fue variable y no todos coincidieron durante todo el periodo. Esta diversidad reflejaba el carácter todavía abierto del nuevo campo. Algunos estaban interesados en lógica y resolución de problemas; otros, en aprendizaje, teoría de la información, redes inspiradas en el cerebro o reconocimiento de patrones. No existía todavía un método dominante ni una teoría unificada de la inteligencia. Lo que compartían era la convicción de que muchas de estas cuestiones podían abordarse mediante modelos formales y programas de ordenador.
La reunión resultó importante también porque mostró que la inteligencia podía fragmentarse en problemas concretos de investigación. En lugar de intentar construir de una vez una máquina capaz de reproducir toda la mente humana, podían estudiarse tareas específicas: demostrar un teorema, buscar una solución dentro de un conjunto de posibilidades, reconocer determinadas regularidades o utilizar símbolos de acuerdo con ciertas reglas. Este enfoque permitía convertir preguntas muy generales en experimentos abordables con los ordenadores de la época. Poco antes y durante aquellos años comenzaron a aparecer programas que reforzaban esa expectativa. El Logic Theorist, desarrollado por Allen Newell, Herbert Simon y Cliff Shaw, demostró que una máquina podía encontrar demostraciones para ciertos teoremas de lógica simbólica. Resultados semejantes parecían indicar que algunos procesos intelectuales podían analizarse como secuencias de operaciones computacionales.
Dartmouth tuvo además una consecuencia terminológica de enorme alcance: consolidó la expresión «inteligencia artificial» como nombre del nuevo campo. El término diferenciaba esta línea de investigación de otras denominaciones posibles vinculadas a la automatización, la cibernética o la simulación del cerebro. Su amplitud permitía englobar enfoques diversos bajo una misma pregunta general: cómo construir máquinas capaces de realizar tareas que, cuando las realizan seres humanos, asociamos con alguna forma de inteligencia. Esa elección lingüística contribuyó a crear una identidad científica. A partir de entonces sería más sencillo organizar grupos de investigación, formular proyectos, obtener financiación y presentar resultados como parte de una disciplina reconocible, aunque sus fronteras siguieran siendo discutidas y cambiantes.
La importancia de Dartmouth debe entenderse, por tanto, como la de un momento de cristalización más que como la de un nacimiento repentino. Sus participantes heredaban décadas de avances en lógica, computación, neurociencia, teoría de la información y máquinas programables, pero reunieron esas tradiciones bajo un propósito nuevo y explícito. El optimismo era considerable: se esperaba que problemas que parecían profundamente difíciles pudieran avanzar con rapidez si se disponía de mejores programas y mayor capacidad de cálculo. El tiempo demostraría que muchas de aquellas expectativas eran demasiado ambiciosas y que reproducir capacidades humanas exigía enfrentarse a una complejidad mucho mayor de la prevista. Aun así, Dartmouth estableció un punto de partida duradero. Desde aquel verano de 1956, la inteligencia artificial podía reconocerse ya no solo como una colección de ideas dispersas, sino como un programa científico con nombre propio, investigadores identificables y una pregunta central que continuaría impulsando la disciplina durante las décadas siguientes.
Propuesta del Dartmouth Summer Research Project on Artificial Intelligence (1955). Documento redactado por John McCarthy, Marvin Minsky, Nathaniel Rochester y Claude Shannon para organizar el proyecto de investigación que se celebraría en Dartmouth College durante el verano de 1956. En él aparece ya la expresión «artificial intelligence», que acabaría dando nombre al nuevo campo científico. Copia histórica conservada en Stanford, vinculada al archivo de John McCarthy. El documento original, titulado A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence, está fechado el 31 de agosto de 1955.
4.2. John McCarthy y el término «inteligencia artificial»
Dar nombre a una nueva disciplina no es un gesto menor. Un nombre reúne problemas hasta entonces dispersos, delimita un territorio de investigación y proporciona a una comunidad científica una identidad compartida. John McCarthy desempeñó precisamente ese papel cuando, en la propuesta preparada en 1955 para el encuentro de Dartmouth del verano siguiente, utilizó la expresión «artificial intelligence». La elección señalaba una ambición considerable: no se trataba únicamente de automatizar cálculos, diseñar mecanismos de control o estudiar matemáticamente la información, sino de investigar cómo podían construirse máquinas capaces de realizar actividades relacionadas con la inteligencia. Con el tiempo, la fórmula «inteligencia artificial» llegaría a convertirse en una de las expresiones tecnológicas más conocidas del mundo, aunque en aquel momento servía para identificar un programa de investigación apenas naciente y todavía abierto a enfoques muy diferentes.
John McCarthy (1927–2011). Matemático y científico de la computación estadounidense, uno de los principales impulsores de la inteligencia artificial como disciplina. Introdujo la expresión «artificial intelligence» en la propuesta de Dartmouth de 1955 y desarrolló posteriormente importantes trabajos en programación e inteligencia artificial. Original file (2,013 × 2,332 pixels, file size: 4.29 MB). Fotografía tomada en Stanford en 2006. Está bajo licencia CC BY-SA 2.0, así que puede reutilizarse con atribución.

John McCarthy desempeñó un papel central en la consolidación de la inteligencia artificial como campo científico. Además de proponer el término «artificial intelligence», promovió la idea de estudiar formalmente capacidades como el razonamiento, la representación del conocimiento y la resolución de problemas mediante computadoras. También creó el lenguaje de programación LISP, que durante décadas se convirtió en una de las herramientas fundamentales de la investigación en inteligencia artificial.
McCarthy, matemático y científico de la computación estadounidense, había advertido que varias líneas de trabajo comenzaban a converger. Existían investigaciones sobre redes neuronales tempranas, lógica, teoría de la información, resolución automática de problemas y aprendizaje de máquinas, pero no todas se reconocían como partes de un mismo campo. También estaba muy presente la cibernética, desarrollada alrededor de conceptos como control, comunicación y retroalimentación. La nueva denominación permitía establecer un espacio distinto, suficientemente amplio para investigar la inteligencia mediante computación sin comprometerse con una única explicación biológica o con un modelo concreto del cerebro. McCarthy aspiraba a estudiar las capacidades inteligentes como problemas que podían formularse de manera computacional, diseñando representaciones y procedimientos capaces de producir comportamientos útiles.
La expresión contenía además una idea metodológica importante. El adjetivo «artificial» indicaba que el objetivo no tenía por qué ser copiar literalmente los mecanismos mediante los que funciona la mente humana. Del mismo modo que una máquina voladora no necesita batir alas como un pájaro, un sistema artificial podía alcanzar determinados resultados inteligentes utilizando procedimientos diferentes de los biológicos. Esta posibilidad abría una enorme libertad científica. Los investigadores podían preguntarse qué representaciones necesitaba una máquina, cómo debía organizar conocimientos, de qué modo podía buscar soluciones o cómo podía modificar su comportamiento, sin asumir que cada mecanismo tuviera que reproducir un proceso psicológico humano conocido. La inteligencia se convertía así en un problema de construcción además de un objeto de observación.
La contribución de McCarthy fue mucho más allá del nombre. Defendió durante décadas la idea de que el razonamiento podía representarse mediante sistemas formales y que los ordenadores podían utilizar conocimiento explícito para obtener conclusiones y resolver problemas. En 1958 desarrolló LISP, un lenguaje de programación que llegaría a ejercer una influencia enorme en la investigación de inteligencia artificial. Su flexibilidad para trabajar con estructuras simbólicas y expresiones lo convirtió durante muchos años en una de las herramientas características de este campo. McCarthy también impulsó el concepto de tiempo compartido en computación, que permitía a varios usuarios interactuar con un ordenador de manera más directa, y participó activamente en la creación de importantes centros de investigación. Su trayectoria ilustra hasta qué punto el nacimiento de la IA estuvo ligado tanto a nuevas ideas teóricas como a la construcción de herramientas que permitieran experimentarlas.
Uno de sus intereses centrales fue el problema del sentido común. Resolver una demostración matemática dentro de un sistema formal podía resultar difícil, pero el mundo cotidiano presentaba un desafío todavía mayor. Las personas manejan continuamente enormes cantidades de conocimiento implícito: sabemos que los objetos ocupan lugares, que las acciones producen consecuencias, que las situaciones cambian y que determinadas circunstancias hacen razonables unas decisiones y no otras. Traducir ese conocimiento a una máquina resultó extraordinariamente complejo. McCarthy trabajó en formas de representación lógica que permitieran a los sistemas razonar acerca de hechos, acciones y situaciones, convencido de que una inteligencia artificial poderosa necesitaría algo más que procedimientos aislados: debía disponer de representaciones del mundo sobre las que pudiera efectuar inferencias.
La elección del término «inteligencia artificial» tuvo finalmente consecuencias que sus creadores difícilmente podían prever. Proporcionó unidad a una disciplina, pero también generó expectativas enormes, porque la palabra inteligencia evocaba capacidades humanas mucho más amplias que las que aquellos primeros programas podían alcanzar. Desde entonces, el campo conviviría con una tensión permanente entre la precisión técnica de sus investigaciones y la amplitud casi ilimitada sugerida por su nombre. Cada progreso podía interpretarse como un paso hacia una inteligencia comparable a la humana, incluso cuando se trataba de resolver un problema muy específico. Esa ambigüedad ha acompañado a la IA hasta la actualidad y explica parte de la fascinación pública que continúa provocando.
McCarthy ayudó así a proporcionar algo más que una etiqueta conveniente. Contribuyó a definir una visión de la inteligencia artificial como disciplina autónoma, orientada a estudiar mediante computación capacidades relacionadas con el razonamiento, el conocimiento y la resolución de problemas. Dartmouth ofreció el escenario inicial, pero el término permitió que aquel proyecto adquiriera continuidad y pudiera reconocerse como un campo científico diferenciado. A su alrededor crecerían laboratorios, lenguajes de programación, teorías y escuelas rivales. Entre los investigadores que desempeñaron un papel decisivo en esa primera etapa se encontraba Marvin Minsky, cuya obra ampliaría todavía más las preguntas acerca de cómo podía construirse una máquina capaz de realizar actividades inteligentes.
Dartmouth Hall, Dartmouth College, Hanover (New Hampshire). Dartmouth College acogió durante el verano de 1956 el Dartmouth Summer Research Project on Artificial Intelligence, encuentro considerado uno de los momentos fundacionales de la inteligencia artificial como disciplina científica.
4.3. Marvin Minsky
Marvin Minsky fue una de las figuras más influyentes de la primera generación de investigadores que convirtió la inteligencia artificial en un campo de investigación estable. Su importancia no procede de una única teoría ni de un solo programa, sino de una trayectoria que recorrió buena parte de los grandes problemas de la disciplina: aprendizaje, percepción, representación del conocimiento, razonamiento, lenguaje y organización de sistemas complejos. Formado en matemáticas y profundamente interesado por el funcionamiento de la mente, Minsky participó en la reunión de Dartmouth y contribuyó después a crear instituciones desde las que la inteligencia artificial adquiriría una identidad científica propia. Su carrera refleja muy bien el entusiasmo de aquellos años, pero también las dificultades que aparecieron cuando los investigadores comprobaron que reproducir capacidades humanas exigía mucho más que aumentar la velocidad de los ordenadores o escribir reglas más elaboradas.
Uno de sus primeros intereses estuvo relacionado con las redes neuronales artificiales. A comienzos de la década de 1950 trabajó junto con Dean Edmonds en SNARC, una máquina experimental inspirada en principios de aprendizaje y redes de unidades conectadas. Aquellos sistemas estaban todavía muy lejos de las redes neuronales actuales, pero mostraban que existía más de una manera de abordar la inteligencia artificial. Una posibilidad consistía en programar explícitamente reglas y conocimientos; otra trataba de construir estructuras capaces de modificar su comportamiento a partir de conexiones y experiencia. Minsky exploró ambas vías a lo largo de su carrera, aunque con el tiempo se convirtió en una de las figuras centrales del enfoque simbólico, basado en representar de manera explícita conocimientos, objetivos y relaciones para permitir que una máquina pudiera razonar sobre ellos.
En 1959, Minsky y John McCarthy fundaron el Artificial Intelligence Project del Massachusetts Institute of Technology, que más tarde se convertiría en uno de los grandes centros mundiales de investigación en inteligencia artificial. Desde allí se desarrollaron trabajos sobre robótica, visión artificial, comprensión del lenguaje, resolución de problemas y sistemas interactivos. El laboratorio fue también un espacio de experimentación cultural: los investigadores trabajaban con la idea de que los ordenadores podían convertirse en herramientas mucho más flexibles que simples máquinas de cálculo. Esta atmósfera favoreció la aparición de programas capaces de manipular objetos simbólicos, explorar alternativas o interactuar con entornos simplificados. La IA empezaba a ser entendida como un laboratorio donde podían construirse modelos parciales de capacidades humanas para estudiar hasta dónde era posible reproducirlas computacionalmente.
Minsky se interesó especialmente por la manera en que una mente compleja puede surgir de la cooperación entre procesos más simples. Esta intuición alcanzaría una formulación madura décadas después en su obra The Society of Mind, donde propuso pensar la inteligencia no como resultado de una única facultad central, sino como producto de numerosos agentes o procesos especializados que interactúan entre sí. La idea no pretendía describir literalmente una arquitectura informática concreta, sino ofrecer un marco para comprender cómo una gran variedad de capacidades puede surgir de componentes relativamente simples. Resolver un problema, interpretar una situación o elegir una acción no tendría por qué depender de un único mecanismo general, sino de la coordinación dinámica entre múltiples procesos. Este enfoque buscaba explicar por qué la inteligencia humana parece flexible y diversa sin necesidad de suponer un centro único encargado de todas las operaciones mentales.
Su trayectoria también estuvo asociada a uno de los debates más importantes de la inteligencia artificial temprana. En 1969, Minsky y Seymour Papert publicaron Perceptrons, un estudio matemático sobre las capacidades y limitaciones de determinadas redes neuronales simples. El libro mostró con rigor que ciertos tipos de perceptrones poseían restricciones importantes para resolver algunas clases de problemas. Con el tiempo, esta obra ha sido presentada a veces de manera simplificada como responsable directa del abandono de las redes neuronales durante años. La realidad fue más compleja: las limitaciones del hardware, la escasez de datos, las dificultades de entrenamiento y las prioridades de financiación también influyeron considerablemente. Aun así, el episodio ilustra cómo la inteligencia artificial fue desarrollándose mediante debates entre enfoques diferentes y cómo los límites teóricos de una técnica podían alterar la dirección de la investigación.
Minsky mantuvo además una visión ambiciosa de la inteligencia artificial. Consideraba que para construir sistemas realmente flexibles sería necesario abordar cuestiones profundas relacionadas con el conocimiento cotidiano, la percepción y la capacidad de combinar múltiples formas de razonamiento. Los éxitos obtenidos en dominios muy controlados no bastaban para explicar la riqueza del comportamiento humano. Una máquina podía resolver un problema lógico cuidadosamente definido y, sin embargo, fracasar ante situaciones aparentemente simples que cualquier persona interpreta gracias a una enorme cantidad de conocimientos implícitos. Esta dificultad acompañaría durante décadas a la IA simbólica y mostraría que representar el mundo de manera suficientemente rica era un desafío mucho mayor de lo que parecía en los primeros años.
La figura de Marvin Minsky resume así muchas de las aspiraciones y tensiones de la inteligencia artificial inicial. Participó en su nacimiento institucional, exploró modelos neuronales y simbólicos, impulsó uno de sus laboratorios más influyentes y defendió la idea de que la inteligencia debía entenderse como una organización compleja de procesos. Su obra no proporcionó una teoría definitiva de la mente ni una arquitectura universal para construir máquinas inteligentes, pero ayudó a ampliar el campo y a formular preguntas que seguirían siendo relevantes durante décadas. Junto a investigadores como Herbert Simon y Allen Newell, Minsky contribuyó a convertir la inteligencia artificial en una investigación concreta sobre cómo representar problemas, organizar conocimientos y construir programas capaces de realizar tareas que antes parecían inseparables del razonamiento humano.
Marvin Minsky (1927–2016). Matemático y científico de la computación estadounidense, figura central en los primeros desarrollos de la inteligencia artificial y cofundador, junto con John McCarthy, del laboratorio de inteligencia artificial del MIT. Su trabajo abordó cuestiones relacionadas con el razonamiento, la percepción, el aprendizaje y la representación del conocimiento. Año de la foto, 2006, durante una conferencia de inteligencia artificial en Bremen. CC BY-SA 2.0.
4.4. Herbert Simon y Allen Newell
Herbert A. Simon y Allen Newell ocuparon una posición central en los primeros años de la inteligencia artificial porque abordaron una pregunta que iba directamente al corazón de la nueva disciplina: ¿puede describirse la resolución de problemas como una serie de operaciones sobre símbolos y convertir después ese procedimiento en un programa? Ambos procedían de trayectorias diferentes pero complementarias. Simon había trabajado sobre economía, organizaciones, toma de decisiones y los límites de la racionalidad humana; Newell se había formado en matemáticas y estaba profundamente interesado en los nuevos ordenadores digitales y en la posibilidad de utilizarlos para estudiar procesos intelectuales. Su colaboración, desarrollada principalmente en la RAND Corporation y la Carnegie Institute of Technology —posteriormente Carnegie Mellon University—, ayudó a transformar la inteligencia artificial desde una aspiración general acerca de máquinas inteligentes en una investigación concreta sobre cómo representar problemas y construir estrategias computacionales para resolverlos.
Uno de sus trabajos más influyentes fue el Logic Theorist, desarrollado junto con el programador J. C. Shaw a mediados de la década de 1950. El programa estaba diseñado para encontrar demostraciones de teoremas de lógica proposicional incluidos en los Principia Mathematica de Alfred North Whitehead y Bertrand Russell. Su interés histórico no reside simplemente en que una computadora pudiera verificar operaciones lógicas, sino en que el programa intentaba encontrar caminos hacia una demostración explorando alternativas y utilizando estrategias para reducir el número de posibilidades. En lugar de efectuar únicamente cálculos numéricos, la máquina manipulaba expresiones simbólicas que representaban proposiciones y reglas de inferencia. Algunos de sus resultados mostraron que un programa podía encontrar demostraciones correctas e incluso obtener, en determinados casos, soluciones más breves que las presentadas originalmente. Aquello proporcionaba una demostración muy visible de que una actividad asociada con el razonamiento formal podía abordarse mediante computación.
La experiencia condujo a Simon y Newell hacia un objetivo todavía más ambicioso: construir mecanismos de resolución de problemas que no estuvieran vinculados exclusivamente a una tarea concreta. A finales de la década desarrollaron, también con la colaboración de Shaw, el General Problem Solver, conocido como GPS. El nombre reflejaba la aspiración del proyecto: investigar estrategias suficientemente generales como para aplicarse a diferentes problemas siempre que estos pudieran representarse de una forma adecuada. Una de sus ideas características era el análisis de medios y fines. El sistema comparaba una situación actual con un objetivo, identificaba diferencias entre ambos y seleccionaba operaciones destinadas a reducirlas. Si una operación requería condiciones que todavía no se cumplían, esas condiciones podían convertirse a su vez en nuevos subproblemas. La resolución adquiría así una estructura jerárquica en la que un objetivo complejo podía dividirse en pasos más manejables.
Este enfoque tenía una evidente relación con el estudio de la cognición humana. Simon y Newell no querían solamente producir programas eficaces; también consideraban que la computación podía servir como herramienta para formular teorías precisas sobre determinados procesos de pensamiento. Un modelo computacional obligaba a especificar con detalle qué información estaba disponible, qué operaciones podían realizarse y mediante qué procedimiento se elegía entre distintas alternativas. De esta manera, los programas podían funcionar como hipótesis explícitas sobre algunos mecanismos de resolución de problemas. Esta unión entre inteligencia artificial y psicología cognitiva se convertiría en una característica importante de sus investigaciones posteriores. La máquina no era únicamente un instrumento técnico: podía utilizarse también como un laboratorio conceptual para estudiar qué tipo de estructuras y procesos serían necesarios para producir una determinada conducta inteligente.
De sus investigaciones surgió posteriormente una de las formulaciones más influyentes de la inteligencia artificial simbólica: la hipótesis del sistema de símbolos físicos. Newell y Simon defendieron que un sistema físico capaz de manipular estructuras simbólicas mediante reglas reunía las condiciones esenciales para producir acción inteligente general. La propuesta era fuerte y sería objeto de debate, pero expresaba con claridad el programa intelectual que había guiado sus primeros trabajos. Los símbolos podían representar objetos, estados, relaciones u objetivos; los programas podían combinarlos y transformarlos; y el razonamiento podía estudiarse como una secuencia organizada de esas operaciones. Durante varias décadas esta perspectiva dominaría una parte considerable de la investigación en IA y daría lugar a sistemas de planificación, demostración automática, representación del conocimiento y diagnóstico.
Los trabajos de Simon y Newell mostraron también pronto una dificultad que acompañaría a toda la inteligencia artificial clásica. Una estrategia podía funcionar muy bien dentro de un problema cuidadosamente definido y perder eficacia cuando aumentaba el tamaño del espacio de búsqueda o cuando el mundo que debía representar se volvía demasiado rico y ambiguo. Las personas disponen de conocimientos previos, expectativas y experiencias que les permiten descartar rápidamente numerosas alternativas; una máquina necesita algún modo de representar y utilizar ese conocimiento. El desafío no consistía simplemente en hacer que el ordenador probara posibilidades con mayor velocidad, sino en dotarlo de estructuras que orientaran la búsqueda hacia soluciones razonables.
La importancia histórica de Herbert Simon y Allen Newell reside precisamente en haber convertido esas cuestiones en programas que podían ejecutarse, observarse y compararse. Demostraron que la manipulación simbólica podía utilizarse para construir sistemas capaces de resolver determinados problemas y contribuyeron a establecer una tradición que marcaría profundamente las primeras décadas de la inteligencia artificial. Con Logic Theorist y General Problem Solver, la promesa formulada en Dartmouth comenzó a adquirir una forma tangible: las máquinas podían hacer algo más que calcular cantidades; podían explorar alternativas, utilizar reglas y construir secuencias de operaciones orientadas hacia una meta. Sobre esa base aparecerían numerosos programas que alimentarían el extraordinario optimismo de los primeros años de la disciplina.
Herbert Simon y Allen Newell, pioneros de la inteligencia artificial. Herbert A. Simon y Allen Newell durante una partida de ajedrez, hacia 1958. Su colaboración fue fundamental en los primeros años de la inteligencia artificial y dio lugar a programas pioneros destinados a reproducir mediante computadoras algunos procedimientos humanos de razonamiento y resolución de problemas.
Y esta fotografía tiene un pequeño regalo conceptual: el ajedrez acabaría convirtiéndose en uno de los grandes campos de experimentación de la inteligencia artificial. Por eso no es solamente una foto de dos investigadores juntos; visualmente enlaza muy bien con el tipo de problemas que fascinaban a aquellos pioneros.
4.5. Primeros programas capaces de resolver problemas
Los primeros programas de inteligencia artificial adquirieron importancia porque demostraron que una computadora podía utilizarse para algo más que realizar cálculos numéricos rápidos y repetitivos. Desde mediados de la década de 1950, varios grupos comenzaron a diseñar sistemas capaces de enfrentarse a problemas cuya solución requería explorar alternativas, aplicar reglas y seleccionar caminos posibles. El reto consistía en traducir una tarea aparentemente intelectual a una estructura suficientemente precisa para que pudiera ser ejecutada por una máquina. Esto obligaba a representar el estado inicial, definir un objetivo, establecer qué operaciones estaban permitidas y decidir cómo recorrer el espacio de posibilidades. La resolución de problemas se convirtió así en uno de los primeros grandes laboratorios de la inteligencia artificial, porque permitía estudiar de forma concreta cuestiones como búsqueda, planificación, inferencia y toma de decisiones sin necesidad de intentar reproducir de una vez toda la complejidad de la mente humana.
Uno de los ejemplos más célebres fue el Logic Theorist, desarrollado por Allen Newell, Herbert Simon y J. C. Shaw. El programa estaba diseñado para encontrar demostraciones de teoremas de lógica simbólica y mostró que una computadora podía manipular expresiones formales siguiendo reglas de inferencia hasta alcanzar una conclusión. Lo novedoso no era únicamente que la máquina pudiera verificar una cadena de operaciones, sino que exploraba diferentes posibilidades y utilizaba estrategias para orientar la búsqueda. En determinados casos encontró demostraciones correctas y relativamente elegantes. Esto tuvo un enorme impacto porque parecía ofrecer una prueba tangible de que una actividad tradicionalmente asociada al razonamiento podía descomponerse en operaciones computacionales. El programa no comprendía la lógica como lo haría un matemático humano, pero sí podía trabajar con estructuras simbólicas, transformar unas expresiones en otras y evaluar qué pasos acercaban la búsqueda hacia un objetivo.
Logic Theorist Program, 1955–1956. Material gráfico perteneciente a los Herbert A. Simon Papers, RAND Corporation. Carnegie Mellon University Archives. Uso no comercial permitido. Fuente original: Carnegie Mellon University Digital Collections
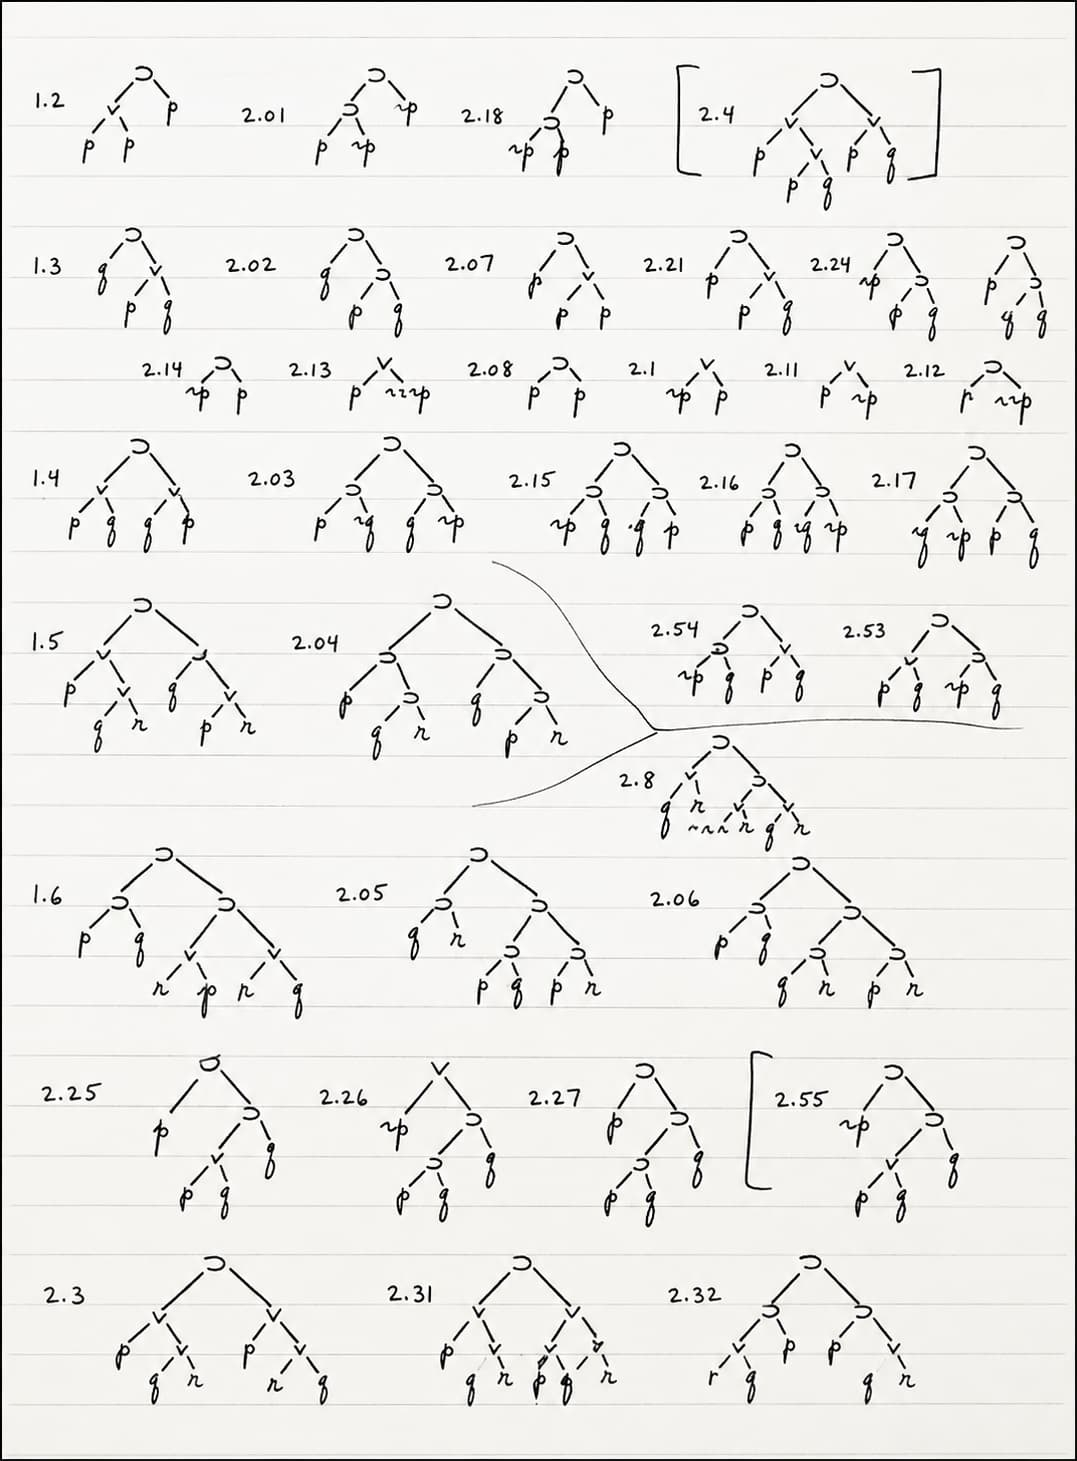
The Logic Theory Machine: A Complex Information Processing System. Allen Newell y Herbert A. Simon, 15 de junio de 1956. El propio documento describe un sistema capaz de descubrir demostraciones de teoremas de lógica simbólica mediante procedimientos heurísticos. Abrir el PDF original de The Logic Theory Machine.
A partir de estos primeros éxitos surgieron intentos de construir sistemas menos ligados a una única tarea. El General Problem Solver, desarrollado por Newell, Simon y Shaw, buscaba aplicar estrategias generales de resolución a distintos problemas formalizados. Su funcionamiento se apoyaba en comparar la situación actual con la meta deseada y seleccionar operaciones capaces de reducir la diferencia entre ambas. Este procedimiento, conocido como análisis de medios y fines, permitía dividir un problema complejo en subproblemas más pequeños. Si para ejecutar una operación era necesario cumplir una condición previa, esa condición se convertía temporalmente en un nuevo objetivo. La idea era poderosa porque introducía una forma de planificación jerárquica: avanzar hacia una solución no mediante una secuencia rígida, sino construyendo pasos intermedios según las necesidades que fueran apareciendo. Ver ficha bibliográfica:_ Report on a General Problem-Solving Program (1959). Allen Newell, J. C. Shaw y Herbert A. Simon. Documento conservado en Carnegie Mellon University Archives, dentro de los fondos de la Tepper School of Business. Fuente: Carnegie Mellon University Archives. Este enlace es un working paper de febrero de 1959, de Allen Newell, J. C. Shaw y Herbert A. Simon, y describe el General Problem Solver I (GPS). El propio documento explica que el programa pretendía estudiar procesos complejos de resolución de problemas y comportamiento inteligente.
Otros programas tempranos exploraron dominios distintos y ayudaron a ampliar la imagen de lo que una máquina podía hacer. En juegos como las damas o el ajedrez, por ejemplo, los investigadores utilizaron técnicas de búsqueda para examinar posibles movimientos futuros y valorar posiciones. Arthur Samuel desarrolló durante los años cincuenta un programa de damas que incorporaba mecanismos de aprendizaje y podía mejorar su rendimiento mediante la experiencia acumulada. El caso era especialmente interesante porque mostraba que un sistema no tenía por qué depender exclusivamente de estrategias fijadas de antemano; podía ajustar ciertos criterios a partir de partidas anteriores. En paralelo, otros proyectos estudiaron rompecabezas, demostración automática, planificación o manipulación de objetos en entornos simplificados. Cada uno de estos experimentos convertía una actividad compleja en una combinación de estados, reglas, objetivos y procedimientos de evaluación.
La búsqueda era uno de los problemas comunes a casi todos estos sistemas. Muchos desafíos pueden describirse como un conjunto de estados conectados por acciones posibles, pero el número de alternativas crece con enorme rapidez. Examinar todas las opciones puede resultar inviable incluso en problemas relativamente pequeños. Por ello, los investigadores desarrollaron heurísticas, reglas prácticas destinadas a dirigir la búsqueda hacia caminos que parecían más prometedores. Estas estrategias no garantizaban siempre la mejor solución, pero permitían reducir drásticamente el número de posibilidades examinadas. La inteligencia artificial temprana comenzó así a distinguir entre la capacidad bruta de cálculo y la utilización inteligente de los recursos disponibles. Una máquina no necesitaba probarlo todo si podía incorporar conocimiento o criterios que le permitieran descartar opciones poco útiles y concentrarse en aquellas con mayor probabilidad de conducir al objetivo.
Los primeros programas capaces de resolver problemas fueron modestos si se comparan con los sistemas actuales, pero su importancia histórica fue enorme. Mostraron que algunas formas de razonamiento podían representarse como operaciones sobre símbolos, que la búsqueda podía organizarse mediante estrategias y que una máquina podía avanzar hacia un objetivo sin disponer de una respuesta completamente preparada de antemano. Al mismo tiempo, dejaron al descubierto una dificultad que se volvería cada vez más evidente: los éxitos obtenidos en dominios pequeños y bien estructurados no se trasladaban fácilmente al mundo real. Cuanto más abierto era un problema, mayor cantidad de conocimiento, contexto y capacidad de adaptación parecía necesaria. En aquellos primeros años, sin embargo, predominaba otra sensación: si ya era posible demostrar teoremas, jugar, aprender parcialmente y resolver problemas formales, parecía razonable pensar que capacidades mucho más generales estaban a poca distancia. Esa impresión alimentaría el extraordinario optimismo con el que la inteligencia artificial entró en su primera gran etapa de expansión.
4.6. El optimismo de los años iniciales
Los primeros éxitos de la inteligencia artificial produjeron una sensación de avance mucho más rápida de lo que después demostraría la realidad. A finales de la década de 1950 y comienzos de la de 1960, varios programas eran ya capaces de resolver problemas lógicos, jugar, demostrar ciertos teoremas o manipular símbolos siguiendo estrategias relativamente complejas. Para una generación que había visto nacer los primeros ordenadores electrónicos, estos resultados parecían confirmar que muchas actividades intelectuales podían transformarse en procedimientos computacionales. El salto conceptual era enorme: si una máquina podía resolver un problema formal o encontrar una estrategia dentro de un espacio de posibilidades, ¿por qué no podría avanzar hacia tareas cada vez más generales? La propia juventud de la disciplina favorecía esta confianza. Todavía no se habían explorado suficientemente los límites de los métodos disponibles, y cada nuevo éxito parecía abrir una puerta más amplia que la anterior.
El entusiasmo se alimentaba también del contexto tecnológico. Los ordenadores aumentaban progresivamente su capacidad de cálculo y almacenamiento, mientras los lenguajes de programación permitían desarrollar sistemas cada vez más complejos. Era razonable pensar que muchas dificultades desaparecerían simplemente con máquinas más rápidas y mejores programas. En los laboratorios de inteligencia artificial se trabajaba sobre resolución de problemas, lenguaje, juegos, percepción y aprendizaje con una sensación de frontera científica abierta. Algunas afirmaciones de la época reflejan expectativas extraordinariamente elevadas sobre la rapidez con la que podrían alcanzarse capacidades mucho más generales. No todos los investigadores compartían exactamente el mismo grado de optimismo, pero existía una convicción extendida de que los principales obstáculos podían ser superados en un horizonte relativamente corto si continuaban mejorando los métodos y la potencia de los ordenadores.
IBM 704 en un centro de computación, 1956. Los grandes ordenadores científicos de mediados de la década de 1950 requerían salas especializadas, numerosos dispositivos periféricos y equipos humanos encargados de su operación. Este ambiente de investigación acompañó el creciente convencimiento de que las computadoras podían utilizarse no solo para realizar cálculos, sino también para abordar problemas cada vez más complejos, una expectativa que alimentó el optimismo de los primeros años de la inteligencia artificial.
IBM 704 computer, 1956. Lawrence Livermore National Laboratory (LLNL). Imagen restaurada y mejorada digitalmente para esta publicación. Fuente original: Lawrence Livermore National Laboratory — A look back: Robert Hughes and the development of FORTRAN. (Licencia CC BY-NC-SA 4.0: atribución, uso no comercial y compartir las modificaciones bajo la misma licencia). Política de copyright y reutilización de LLNL.
Ese optimismo tenía, además, una base intelectual concreta. Los primeros sistemas habían mostrado que actividades consideradas complejas podían descomponerse en símbolos, reglas y procedimientos de búsqueda. Este resultado sugería que otras capacidades quizá pudieran analizarse del mismo modo. Si demostrar un teorema exigía representar premisas, aplicar reglas y explorar alternativas, tal vez comprender una frase, planificar una acción o reconocer un objeto pudieran resolverse mediante estructuras equivalentes, aunque fueran más elaboradas. La inteligencia tendía así a imaginarse como un conjunto de problemas que podrían abordarse uno tras otro hasta formar sistemas cada vez más completos. La dificultad estaba en que muchos de los primeros experimentos se desarrollaban en entornos simplificados, donde las reglas estaban bien definidas y la cantidad de información relevante era limitada. Dentro de esos pequeños mundos, el progreso parecía mucho más rápido que en situaciones abiertas.
El mundo real, sin embargo, introducía una complejidad que todavía no se apreciaba plenamente. Las personas utilizan de manera continua conocimientos que rara vez expresan de forma explícita: entienden relaciones espaciales, reconocen intenciones, interpretan ambigüedades y utilizan experiencias previas para descartar posibilidades absurdas. Una tarea sencilla para un ser humano puede requerir una cantidad enorme de información implícita. Los primeros programas funcionaban especialmente bien cuando el problema estaba perfectamente delimitado, pero su rendimiento podía degradarse con rapidez al aumentar el número de opciones o introducir situaciones inesperadas. El conocido crecimiento combinatorio convertía algunos espacios de búsqueda en inmanejables, mientras que representar de manera formal el conocimiento cotidiano resultaba mucho más difícil de lo esperado. Estas limitaciones todavía no habían producido una crisis general, pero comenzaban a mostrar que ampliar una demostración de laboratorio hasta una inteligencia flexible era un salto considerable.
La financiación pública y militar contribuyó igualmente al clima de confianza. En Estados Unidos y otros países, la computación había adquirido un gran valor estratégico, y la posibilidad de construir máquinas capaces de traducir idiomas, analizar información, planificar o resolver problemas complejos despertaba un interés evidente. Los laboratorios recibieron recursos que permitieron contratar investigadores, adquirir equipos y mantener proyectos ambiciosos. Este apoyo fue esencial para consolidar la inteligencia artificial como disciplina, aunque también favoreció expectativas concretas sobre los resultados que debían obtenerse. Cuando una tecnología se presenta como capaz de resolver problemas difíciles en plazos relativamente breves, la distancia entre promesa y rendimiento comienza a adquirir una importancia creciente. La investigación necesita tiempo, pero los financiadores suelen esperar avances medibles; esa tensión terminaría teniendo consecuencias cuando algunos proyectos no cumplieron los objetivos anunciados.
El optimismo inicial de la inteligencia artificial no debe interpretarse simplemente como ingenuidad. Aquellos investigadores estaban trabajando con una tecnología nueva cuyas posibilidades reales todavía eran desconocidas, y muchos de sus descubrimientos establecieron fundamentos duraderos. El error principal estuvo en subestimar la diferencia entre resolver tareas formalizadas y construir sistemas capaces de desenvolverse en entornos complejos, ambiguos y cambiantes. Durante algunos años, los éxitos parecieron indicar que la inteligencia general podía alcanzarse mediante una ampliación gradual de los métodos existentes. Con el tiempo se haría evidente que cada avance abría nuevas dificultades: representar conocimiento, controlar espacios enormes de búsqueda, interpretar lenguaje o percibir el mundo exigían soluciones mucho más profundas. Esa distancia entre las grandes expectativas y los resultados obtenidos prepararía el escenario para una etapa muy distinta, en la que la inteligencia artificial tendría que enfrentarse por primera vez a sus propias limitaciones.
Durante las primeras décadas de la inteligencia artificial, una de las ideas más influyentes fue que una máquina podía comportarse de manera inteligente si era capaz de representar conocimientos y operar sobre ellos mediante reglas. Este enfoque, conocido como inteligencia artificial simbólica, partía de una intuición poderosa: buena parte del razonamiento humano parece apoyarse en conceptos, relaciones, categorías y decisiones que pueden expresarse mediante símbolos. Si esos elementos podían traducirse a una forma comprensible para un ordenador, quizá también sería posible reproducir ciertas operaciones intelectuales. La máquina no necesitaría imitar físicamente al cerebro, sino disponer de representaciones adecuadas del problema y de mecanismos capaces de transformarlas. Durante años, esta perspectiva definió gran parte de la investigación en IA y produjo algunos de sus primeros resultados convincentes.
El razonamiento simbólico se apoyaba en una estructura relativamente transparente. Un sistema podía contener hechos, reglas y relaciones, y utilizarlos para obtener nuevas conclusiones. Si conocía, por ejemplo, determinadas propiedades de un objeto y disponía de reglas aplicables a esas propiedades, podía inferir información que no aparecía explícitamente almacenada. Esta forma de operar resultaba especialmente atractiva porque permitía examinar paso a paso cómo se había alcanzado una conclusión. Frente a una máquina cuyo funcionamiento interno fuera difícil de interpretar, un sistema simbólico podía mostrar qué reglas había utilizado y qué cadena de inferencias había seguido. La inteligencia comenzaba así a representarse como una actividad organizada sobre estructuras formales, donde pensar equivalía, en determinados problemas, a transformar símbolos de acuerdo con procedimientos definidos.
Pero para razonar no basta con tener reglas: es necesario disponer de conocimiento. Representar el mundo dentro de una máquina se convirtió por ello en uno de los grandes desafíos de la disciplina. Había que decidir qué debía almacenarse, cómo expresar objetos y relaciones, de qué manera representar situaciones cambiantes y cómo distinguir información relevante de datos secundarios. Esta tarea parecía abordable en dominios muy concretos, pero aumentaba rápidamente de dificultad cuando se intentaba describir escenarios más amplios. Una persona utiliza constantemente conocimientos que nunca formula de manera explícita; sabe cómo suelen comportarse los objetos, qué acciones son plausibles o qué información puede darse por supuesta. Convertir ese enorme fondo de experiencia cotidiana en símbolos y reglas revelaría pronto una complejidad inesperada.
La inteligencia artificial simbólica desarrolló también métodos para buscar soluciones dentro de espacios de posibilidades. Un problema podía representarse mediante estados, objetivos y operaciones permitidas, y el programa debía encontrar una secuencia capaz de conducir desde la situación inicial hasta una solución. Cuando el número de alternativas era demasiado grande, entraban en juego estrategias destinadas a orientar la búsqueda y reducir caminos innecesarios. Esta combinación de representación, reglas y búsqueda permitió construir sistemas capaces de resolver problemas formales, planificar acciones o tomar decisiones dentro de entornos bien definidos. La idea central era que la inteligencia no dependía únicamente de calcular más deprisa, sino de utilizar conocimiento estructurado para decidir qué operaciones tenían sentido en cada momento.
Uno de los frutos más importantes de este enfoque fueron los sistemas expertos, desarrollados especialmente desde las décadas de 1960 y 1970 y extendidos posteriormente a numerosos ámbitos profesionales. Estos programas intentaban capturar parte del conocimiento especializado de médicos, químicos, ingenieros u otros profesionales mediante conjuntos de reglas y estructuras de decisión. En dominios cuidadosamente delimitados podían ofrecer resultados valiosos, recomendar hipótesis o ayudar a interpretar información compleja. La inteligencia artificial comenzaba así a salir del laboratorio y a demostrar utilidad en aplicaciones científicas y profesionales concretas. El éxito de algunos de estos sistemas reforzó durante un tiempo la idea de que acumular conocimiento explícito y construir mejores mecanismos de inferencia podía conducir progresivamente hacia máquinas cada vez más competentes.
Sin embargo, los propios avances de la inteligencia artificial simbólica dejaron al descubierto sus límites. El mundo real contiene ambigüedades, excepciones, incertidumbre y situaciones imposibles de anticipar mediante una lista completa de reglas. Cuanto más amplio era el dominio, más difícil resultaba introducir manualmente todo el conocimiento necesario y mantener coherentes enormes redes de relaciones. La experiencia cotidiana parecía resistirse a una representación exhaustiva, y pequeños cambios de contexto podían exigir interpretaciones que una persona realiza casi sin esfuerzo. Este epígrafe recorrerá precisamente ese itinerario: desde la confianza en reglas y símbolos hasta los sistemas expertos y sus aplicaciones, para terminar examinando la dificultad fundamental de representar explícitamente un mundo demasiado rico para ser convertido por completo en instrucciones. Esa tensión entre la claridad del conocimiento formal y la complejidad de la realidad marcaría los límites de una de las grandes tradiciones de la inteligencia artificial.
5.1. El razonamiento mediante reglas y símbolos
La inteligencia artificial simbólica partió de una idea tan sencilla como ambiciosa: si una parte del razonamiento puede expresarse mediante símbolos y reglas, una máquina podría operar sobre esos símbolos y obtener conclusiones de manera automática. En este enfoque, los conocimientos se representan explícitamente y el razonamiento consiste en aplicar procedimientos formales a esas representaciones. Un símbolo puede designar un objeto, una propiedad, una relación o una situación, mientras que una regla establece qué consecuencia debe derivarse cuando se cumplen determinadas condiciones. La máquina no necesita experimentar el significado de esos elementos como lo haría una persona; necesita reconocer su estructura y transformarlos de acuerdo con instrucciones precisas. Esta concepción convirtió la inteligencia en algo parcialmente manipulable: pensar, al menos en ciertos dominios, podía modelarse como una secuencia de operaciones sobre representaciones.
Uno de los mecanismos más característicos fue el uso de reglas del tipo «si… entonces…». Una regla podía expresar, por ejemplo, que si se cumplen determinadas condiciones debe aceptarse una conclusión o ejecutarse una acción. El interés no estaba en la forma lingüística de la regla, sino en su papel dentro de un sistema de inferencia. Cuando numerosas reglas se conectaban entre sí, una conclusión obtenida en un paso podía convertirse en premisa para otro, formando cadenas de razonamiento. De este modo, el programa podía producir información que no estaba almacenada literalmente como un resultado final. La máquina aplicaba reglas, actualizaba el conjunto de hechos disponibles y continuaba avanzando hasta alcanzar una conclusión, un objetivo o una situación en la que ya no pudiera realizar nuevas inferencias.
Este tipo de razonamiento podía organizarse de distintas maneras. En algunos sistemas se partía de los hechos disponibles y se aplicaban reglas para descubrir qué consecuencias podían derivarse, un procedimiento conocido como encadenamiento hacia adelante. En otros casos se comenzaba con una hipótesis o un objetivo y se buscaban las condiciones que permitirían justificarlo, avanzando hacia atrás hasta comprobar si existían hechos suficientes para sostenerlo. Ambas estrategias muestran que razonar no consiste únicamente en poseer información, sino también en decidir cómo utilizarla. Un sistema simbólico necesita controlar qué reglas aplicar, en qué orden hacerlo y cuándo detener la búsqueda. A medida que aumenta el número de reglas, esta selección puede convertirse en un problema importante, porque muchas de ellas pueden ser potencialmente relevantes al mismo tiempo.
La gran ventaja del enfoque simbólico era su claridad. En principio, podía reconstruirse el camino seguido por el sistema y explicar por qué había alcanzado una determinada conclusión. Si una máquina recomendaba una acción, era posible examinar los hechos considerados y las reglas aplicadas. Esta trazabilidad resultaba especialmente valiosa en ámbitos donde no basta con obtener una respuesta, sino que también interesa conocer el razonamiento que la sustenta. Además, las reglas permitían incorporar directamente conocimientos proporcionados por especialistas. Un experto podía describir relaciones que después se transformaban en estructuras procesables por el ordenador. La inteligencia artificial se convertía así en una forma de ingeniería del conocimiento: parte de la competencia de una persona podía intentar traducirse a representaciones formales y procedimientos de inferencia.
Sin embargo, el razonamiento mediante reglas funciona mejor cuando el dominio puede describirse con suficiente precisión. Las reglas formales tienden a ser rígidas: necesitan condiciones identificables y consecuencias relativamente claras. El mundo cotidiano, en cambio, está lleno de excepciones, gradaciones y situaciones en las que la información es incompleta. Una persona puede aceptar una regla general y abandonarla inmediatamente cuando aparece una circunstancia extraordinaria; un sistema necesita algún mecanismo explícito para gestionar esa excepción. También puede ocurrir que varias reglas conduzcan a conclusiones incompatibles o que una inferencia dependa de conocimientos que nunca fueron introducidos en el sistema. Cuanto más amplio es el problema, más difícil resulta construir un conjunto de reglas que sea al mismo tiempo completo, coherente y manejable.
A pesar de estas dificultades, la inteligencia artificial simbólica estableció una manera poderosa de pensar la relación entre conocimiento y computación. Mostró que una máquina podía manipular representaciones abstractas, combinar información y derivar conclusiones sin limitarse a ejecutar cálculos numéricos. Durante décadas, esta idea proporcionó la base de programas de resolución de problemas, sistemas de planificación y herramientas de apoyo a decisiones. También dejó clara una cuestión que resultaría cada vez más importante: la calidad del razonamiento depende de aquello que el sistema es capaz de representar. Una máquina puede disponer de mecanismos de inferencia muy sofisticados y seguir fracasando si su descripción del problema es insuficiente. Por eso, una vez establecido cómo operar mediante reglas y símbolos, la siguiente dificultad fue inevitable: decidir cómo representar dentro de una máquina el conocimiento necesario para que esas reglas pudieran aplicarse de manera útil.
Representar el mundo mediante información. Uno de los grandes objetivos de la inteligencia artificial ha sido convertir aspectos del mundo —objetos, conceptos, relaciones o situaciones— en representaciones que una máquina pueda almacenar, comparar y utilizar para razonar. La IA simbólica abordó este problema mediante reglas, símbolos y estructuras explícitas de conocimiento. Imagen: © GoldenDayz / Envato Elements.
Durante décadas, una de las principales estrategias de la inteligencia artificial consistió en expresar problemas, hechos y reglas de manera formal. Los programas podían buscar soluciones, aplicar inferencias y manipular representaciones simbólicas del conocimiento, aunque esta aproximación encontraba dificultades cuando el mundo real se volvía demasiado complejo.
5.2. Representación del conocimiento
Para que una máquina pueda razonar sobre un problema, primero necesita disponer de alguna forma de representar aquello de lo que está hablando. Esta necesidad convirtió la representación del conocimiento en uno de los problemas centrales de la inteligencia artificial simbólica. No basta con almacenar datos aislados: es necesario organizar objetos, propiedades, relaciones, acontecimientos, categorías y reglas de manera que un programa pueda utilizarlos de forma coherente. Una persona distingue con naturalidad entre un objeto y sus atributos, comprende que ciertos hechos cambian con el tiempo y reconoce relaciones jerárquicas o causales sin tener que formularlas explícitamente. Para una máquina, en cambio, todo eso debe traducirse a estructuras manipulables. La dificultad consiste en construir una representación suficientemente precisa para permitir inferencias útiles y, al mismo tiempo, suficientemente flexible para describir situaciones variadas.
Uno de los primeros recursos fueron las estructuras lógicas, donde los hechos podían expresarse mediante proposiciones y relaciones formales. La lógica ofrecía una ventaja evidente: permitía representar conocimiento de forma rigurosa y aplicar reglas de inferencia bien definidas. También aparecieron redes semánticas, en las que los conceptos se organizaban como nodos conectados mediante relaciones, y marcos o frames, destinados a describir objetos o situaciones mediante conjuntos de atributos asociados. Estas formas de representación intentaban capturar distintos aspectos del conocimiento. Una red podía mostrar que un canario pertenece a la categoría de las aves y que las aves poseen determinadas propiedades; un marco podía representar una habitación mediante elementos esperables como puertas, ventanas o muebles. Cada técnica aportaba una forma distinta de estructurar información para que el sistema pudiera localizarla, combinarla y utilizarla durante el razonamiento.
La organización jerárquica resultó especialmente útil porque permitía heredar propiedades. Si una categoría general posee determinadas características, sus subcategorías pueden recibirlas automáticamente salvo que exista una excepción. Esta idea reduce la necesidad de repetir información y permite construir representaciones más compactas. Sin embargo, también introduce problemas. El mundo real está lleno de casos que no encajan limpiamente en jerarquías rígidas. Un ave suele volar, pero un pingüino no lo hace; una regla válida en muchas circunstancias puede dejar de serlo cuando cambia el contexto. Los investigadores tuvieron que diseñar mecanismos capaces de manejar excepciones, información incompleta y conocimiento por defecto. La representación del conocimiento comenzaba así a mostrar que describir la realidad no consiste únicamente en acumular hechos, sino en organizar relaciones que pueden ser válidas solo bajo determinadas condiciones.
Otro desafío era representar el cambio. Muchos sistemas necesitan razonar no solo sobre cómo es una situación, sino sobre qué ocurre cuando se ejecuta una acción. Si una máquina mueve un objeto, abre una puerta o realiza una operación, algunas propiedades cambian mientras otras permanecen iguales. Expresar explícitamente todo lo que no cambia después de cada acción resultaba impráctico. Este tipo de dificultad dio lugar al llamado problema del marco, relacionado con la necesidad de distinguir de manera eficiente qué aspectos del mundo se modifican y cuáles permanecen estables. La cuestión parece técnica, pero revela un problema profundo: las personas manejan enormes cantidades de supuestos implícitos sobre continuidad, causalidad y contexto, mientras que una máquina necesita representaciones suficientemente claras para saber qué consecuencias debe actualizar y cuáles puede conservar.
La representación del conocimiento también exigía decidir qué nivel de detalle era necesario. Una descripción demasiado pobre impedía resolver el problema; una representación excesivamente completa podía resultar inmanejable. En un sistema médico, por ejemplo, no tendría sentido incluir todo lo que se conoce sobre el cuerpo humano si la tarea consiste únicamente en apoyar una decisión muy concreta. Pero si la representación omite una relación importante, el sistema puede alcanzar una conclusión errónea. Esta tensión entre riqueza y manejabilidad se convirtió en uno de los grandes desafíos de la IA simbólica. El conocimiento debía seleccionarse y estructurarse en función del objetivo, lo que implicaba que muchos sistemas funcionaran especialmente bien en dominios estrechos y cuidadosamente controlados.
La importancia de la representación del conocimiento reside en que determina qué mundo puede “ver” realmente una inteligencia artificial simbólica. Un sistema solo puede razonar sobre aquello que ha sido representado de alguna forma dentro de su arquitectura. Si una relación, una excepción o una condición contextual no aparece en esa representación, la máquina no puede utilizarla espontáneamente como lo haría una persona apoyándose en experiencia previa. Esta limitación explica tanto la potencia como la fragilidad de muchos sistemas clásicos. Cuando el dominio está bien estructurado, una buena representación permite realizar inferencias complejas y transparentes; cuando el entorno es ambiguo, cambiante o demasiado amplio, la representación puede convertirse en el principal obstáculo. A partir de aquí, la IA simbólica tuvo que enfrentarse a otro problema estrechamente relacionado: cómo buscar entre múltiples posibilidades y elegir, dentro de esa representación, el camino más adecuado hacia una solución.
5.3. Búsqueda y resolución de problemas
Uno de los grandes retos de la inteligencia artificial simbólica consiste en elegir entre muchas posibilidades. Representar un problema mediante símbolos y reglas es solo el primer paso; después hay que decidir qué hacer con esa representación. En numerosos casos, una máquina parte de una situación inicial, dispone de varias acciones posibles y debe encontrar una secuencia que conduzca hasta un objetivo. Esa estructura puede parecer sencilla, pero el número de alternativas crece con enorme rapidez. Un juego, una planificación logística, un rompecabezas o una demostración lógica pueden generar miles, millones o incluso cantidades mucho mayores de estados posibles. Resolver el problema significa recorrer ese espacio de forma inteligente, evitando en lo posible caminos inútiles y concentrando los recursos en las opciones que tienen más posibilidades de conducir a una solución.
La búsqueda puede entenderse como la exploración sistemática de ese espacio de estados. Cada estado representa una situación posible y cada acción permite pasar de uno a otro. Si el programa examina todas las alternativas sin ningún criterio, puede encontrar una solución, pero a un coste prohibitivo. Algunos métodos recorren primero las opciones más cercanas al punto de partida; otros profundizan en un camino antes de retroceder y probar otro. Estas estrategias básicas son importantes porque muestran que la resolución de problemas depende tanto de cómo se representa el dominio como de cómo se explora. No existe un único procedimiento universalmente superior: cada método ofrece ventajas y limitaciones según el tamaño del problema, la profundidad de la solución o la cantidad de memoria disponible.
Para hacer la búsqueda más eficiente, la inteligencia artificial desarrolló heurísticas, es decir, criterios prácticos que permiten estimar qué opciones parecen más prometedoras. Una heurística no necesita garantizar siempre la mejor decisión; su función es reducir el número de alternativas que deben examinarse. En un problema de rutas, por ejemplo, puede utilizarse una estimación de la distancia restante para priorizar ciertos caminos. En un juego, una función de evaluación puede asignar valores aproximados a distintas posiciones. La gran ventaja de estas técnicas es que introducen conocimiento del problema dentro del proceso de búsqueda. En lugar de recorrer ciegamente todas las posibilidades, el sistema utiliza información para orientar sus decisiones. Esta combinación de reglas generales y conocimiento específico fue una de las claves del éxito de muchos programas simbólicos.
La planificación utiliza ideas semejantes, pero añade una dimensión temporal y causal. El sistema no busca simplemente una respuesta, sino una secuencia ordenada de acciones cuyos efectos conduzcan a una meta. Para ello debe representar qué condiciones son necesarias antes de ejecutar cada acción y qué cambios produce después. Un plan puede incluir objetivos intermedios, dependencias y posibles alternativas. La dificultad aumenta cuando varias acciones interfieren entre sí o cuando el entorno puede cambiar. En dominios bien definidos, sin embargo, estas técnicas permitieron construir programas capaces de resolver tareas que requerían coordinación y anticipación. La planificación mostró que una máquina podía organizar una cadena de operaciones no como una lista fija introducida previamente, sino como una solución generada a partir de un objetivo y de las reglas disponibles.
Árbol de búsqueda y resolución de problemas. Representación simplificada de un proceso de búsqueda: a partir de un problema inicial, el sistema explora distintas alternativas, descarta caminos que no conducen a la meta y avanza hacia una solución.
En la inteligencia artificial simbólica, muchos problemas pueden describirse como un espacio de posibilidades. Resolverlos consiste en recorrer ese espacio de manera ordenada, evaluando opciones intermedias y seleccionando los caminos más prometedores. El árbol de búsqueda permite visualizar este proceso con claridad: desde un punto de partida se generan varias ramas, algunas se abandonan por no ofrecer una salida válida y otras acercan progresivamente al objetivo final. Este enfoque fue fundamental en los primeros programas de IA, porque mostró que tareas aparentemente complejas podían abordarse mediante estrategias formales de exploración y selección.
Los juegos ofrecieron un terreno especialmente fértil para estudiar estas ideas. Ajedrez, damas y otros problemas competitivos pueden representarse como árboles de decisiones en los que cada movimiento abre nuevas posibilidades. Como explorar el árbol completo suele ser imposible, los programas deben evaluar posiciones y limitar la profundidad de la búsqueda. Técnicas como minimax permitieron modelar decisiones en escenarios donde un adversario también intenta alcanzar su propio objetivo, mientras que la poda de ramas evitaba analizar opciones que no podían mejorar el resultado. Estos métodos demostraron que una gran parte de la aparente inteligencia de un programa podía surgir de una combinación de representación adecuada, búsqueda eficiente y evaluación estratégica, sin necesidad de reproducir directamente los procesos mentales de un jugador humano.
La búsqueda y la resolución de problemas revelaron, al mismo tiempo, uno de los límites fundamentales de la inteligencia artificial simbólica. El crecimiento combinatorio podía convertir una tarea manejable en otra prácticamente imposible cuando aumentaba ligeramente su escala. Añadir nuevas variables, acciones o estados multiplicaba las posibilidades y hacía insuficiente la mera fuerza de cálculo. Esto obligó a desarrollar mejores heurísticas y a incorporar cada vez más conocimiento del dominio, pero también mostró que la inteligencia no podía reducirse simplemente a explorar alternativas. Resolver problemas con eficacia exigía saber qué merece la pena considerar, qué puede descartarse y qué información es realmente relevante. Esa necesidad de conocimiento especializado conduciría directamente al desarrollo de los sistemas expertos, diseñados para aplicar reglas y experiencia acumulada dentro de ámbitos profesionales muy concretos.
5.4. Sistemas expertos
Los sistemas expertos representaron uno de los intentos más ambiciosos de la inteligencia artificial simbólica por trasladar conocimiento especializado a una máquina. Su objetivo era reproducir, dentro de un dominio concreto, parte del razonamiento de un profesional experimentado. En lugar de intentar construir una inteligencia general capaz de desenvolverse en cualquier situación, estos sistemas se concentraban en ámbitos bien delimitados: diagnóstico médico, análisis químico, configuración de equipos, interpretación de datos técnicos o apoyo a determinadas decisiones profesionales. La idea era sencilla en apariencia: si el conocimiento de un experto podía expresarse mediante reglas, relaciones y criterios explícitos, un programa podría aplicar ese conocimiento de forma sistemática y ofrecer recomendaciones o conclusiones útiles.
Estructura básica de un sistema experto. Los sistemas expertos fueron programas diseñados para reproducir, en ámbitos concretos, el razonamiento de un especialista humano. Su funcionamiento se apoyaba en dos elementos principales: una base de conocimientos, donde se almacenaban hechos y reglas, y un motor de inferencia, encargado de aplicar esas reglas a los datos introducidos por el usuario para producir una respuesta o recomendación.
Los sistemas expertos constituyeron una de las aplicaciones más características de la inteligencia artificial simbólica. Su idea central consistía en reunir conocimientos especializados sobre un dominio concreto —por ejemplo, medicina, química, geología o diagnóstico técnico— y organizarlos en forma de reglas explícitas. De este modo, el sistema podía actuar como si consultara el saber acumulado de un especialista.
La base de conocimientos contenía hechos, criterios y relaciones formuladas de manera estructurada, mientras que el motor de inferencia utilizaba esas reglas para analizar la información recibida y extraer conclusiones. Cuando un usuario planteaba un problema o introducía determinados datos, el sistema no “pensaba” como una persona en sentido estricto, pero sí era capaz de recorrer reglas lógicas, comparar condiciones y ofrecer una respuesta razonada.
Este modelo permitió construir herramientas muy valiosas en contextos profesionales y científicos, especialmente allí donde el conocimiento podía expresarse con claridad mediante reglas. Sin embargo, también mostró límites importantes: dependía de que ese saber pudiera formalizarse de forma explícita y resultaba menos eficaz en situaciones ambiguas, cambiantes o difíciles de traducir a reglas fijas.
La arquitectura de muchos sistemas expertos se organizaba alrededor de dos componentes fundamentales. Por un lado estaba la base de conocimiento, donde se almacenaban hechos, reglas y relaciones relevantes para el problema. Por otro, el motor de inferencia se encargaba de aplicar esas reglas a la información disponible para obtener nuevas conclusiones. Esta separación permitía actualizar el conocimiento sin necesidad de reconstruir completamente el programa y facilitaba que el sistema pudiera explicar, al menos parcialmente, cómo había llegado a una determinada respuesta. En algunos casos, la interacción se realizaba mediante preguntas sucesivas al usuario, de manera que el programa iba reuniendo información y descartando alternativas hasta alcanzar una conclusión razonada.
Uno de los ejemplos históricos más conocidos fue DENDRAL, desarrollado desde la década de 1960 para ayudar a interpretar estructuras moleculares a partir de datos químicos. Otro caso célebre fue MYCIN, creado en la década de 1970 para apoyar el diagnóstico de determinadas infecciones bacterianas y sugerir tratamientos antibióticos. Estos programas mostraron que, dentro de dominios restringidos, una máquina podía manejar conocimiento especializado con resultados notables. Su importancia no residía únicamente en acertar una respuesta, sino en demostrar que parte del saber profesional podía formalizarse, almacenarse y utilizarse mediante procedimientos automáticos. Para muchos investigadores, aquello parecía confirmar que la inteligencia artificial podía avanzar construyendo sistemas cada vez más ricos en conocimiento.
El desarrollo de estos programas exigió una actividad que llegó a conocerse como ingeniería del conocimiento. El problema ya no era solo programar reglas, sino extraer de los especialistas aquello que realmente sabían y convertirlo en una forma que la máquina pudiera utilizar. Esta tarea resultó mucho más difícil de lo esperado. Los expertos no siempre pueden explicar con precisión cómo toman decisiones, porque parte de su conocimiento procede de años de experiencia, reconocimiento de patrones y juicios intuitivos difíciles de verbalizar. Además, incluso cuando una regla parece clara, puede depender de excepciones, contextos o supuestos que el profesional da por evidentes. Convertir ese conocimiento tácito en reglas explícitas requería largas entrevistas, revisiones y ajustes.
Los sistemas expertos tuvieron un considerable impacto durante las décadas de 1970 y 1980 y llegaron a utilizarse en entornos científicos, industriales y empresariales. Su atractivo era evidente: permitían conservar conocimiento especializado, aplicarlo de forma consistente y ofrecer apoyo en situaciones donde no siempre había un experto disponible. También podían servir como herramienta de formación o como segunda opinión dentro de procesos complejos. Sin embargo, su eficacia dependía profundamente de la calidad y del alcance de la base de conocimiento. Un sistema podía funcionar muy bien dentro de los límites para los que había sido diseñado y fallar de manera brusca cuando aparecía una situación nueva, ambigua o no contemplada previamente.
Estas dificultades mostraron tanto la potencia como la fragilidad del enfoque simbólico. Los sistemas expertos demostraron que el conocimiento explícito podía convertirse en una herramienta computacional muy útil, pero también revelaron el enorme coste de representar manualmente dominios complejos y mantener actualizadas grandes colecciones de reglas. A medida que el entorno cambiaba o aparecían nuevas excepciones, la base de conocimiento podía volverse difícil de gestionar. El éxito de estos programas confirmó que la inteligencia artificial podía ofrecer aplicaciones prácticas de gran valor, pero también dejó clara una cuestión fundamental: cuanto más amplio y cambiante es el mundo que intentamos representar, más difícil resulta capturarlo mediante reglas escritas de antemano. Esa limitación marcaría buena parte de la evolución posterior de la inteligencia artificial simbólica.
Los sistemas expertos constituyeron una de las aplicaciones más representativas de la inteligencia artificial simbólica.
5.5. Aplicaciones científicas y profesionales
La inteligencia artificial simbólica encontró una parte importante de su legitimidad cuando comenzó a demostrar que podía ser útil fuera de los laboratorios de informática. Durante las décadas de 1970 y 1980, numerosos proyectos intentaron aplicar reglas, bases de conocimiento y mecanismos de inferencia a problemas científicos y profesionales concretos. El objetivo ya no era únicamente investigar cómo podía razonar una máquina, sino comprobar si ese razonamiento formalizado podía ayudar a médicos, químicos, ingenieros, geólogos, técnicos o analistas en tareas reales. Este cambio fue decisivo porque obligó a someter los sistemas a conocimientos especializados, datos incompletos y situaciones donde una conclusión debía tener utilidad práctica. La inteligencia artificial dejaba de ser solo una promesa teórica y empezaba a convertirse en una herramienta de apoyo a la decisión.
En química, algunos sistemas demostraron que era posible utilizar conocimiento experto para interpretar información compleja y reducir el número de hipótesis posibles. DENDRAL, por ejemplo, ayudaba a proponer estructuras moleculares compatibles con determinados datos experimentales, combinando reglas químicas con procedimientos de búsqueda. El valor del sistema no estaba en sustituir al investigador, sino en organizar un espacio de posibilidades demasiado amplio para explorarlo manualmente con la misma rapidez. Este tipo de aplicación mostraba una ventaja característica de la IA simbólica: cuando el dominio dispone de reglas relativamente claras y conocimiento bien estructurado, una máquina puede utilizarlos para descartar opciones, ordenar hipótesis y orientar el trabajo científico. El ordenador actuaba así como un instrumento intelectual capaz de ampliar la capacidad analítica del especialista.
La medicina fue otro de los ámbitos donde se exploró con especial intensidad esta posibilidad. Sistemas como MYCIN intentaron utilizar reglas clínicas para apoyar el diagnóstico de ciertas infecciones y sugerir tratamientos adecuados dentro de condiciones muy concretas. Otros proyectos abordaron interpretación de síntomas, apoyo diagnóstico o selección de procedimientos. La relevancia histórica de estas experiencias no reside en imaginar que una máquina pudiera reemplazar el juicio médico, sino en demostrar que una parte del conocimiento clínico podía representarse formalmente y utilizarse para construir sistemas de apoyo. También aparecieron inmediatamente las dificultades: los datos podían ser incompletos, las reglas contener excepciones y las consecuencias de un error ser importantes. Por ello, estas aplicaciones ayudaron a mostrar que en ámbitos sensibles la inteligencia artificial debía entenderse como una herramienta subordinada al criterio profesional y no como una autoridad independiente.
En ingeniería e industria, los sistemas basados en conocimiento se aplicaron a diagnóstico de averías, configuración de equipos, mantenimiento, planificación y control de procesos. Un caso especialmente conocido fue XCON, desarrollado para ayudar a configurar determinados sistemas informáticos de Digital Equipment Corporation. El problema era complejo porque una configuración podía depender de numerosas compatibilidades, componentes y restricciones. Codificar parte de ese conocimiento en reglas permitió reducir errores y agilizar tareas que requerían especialistas experimentados. Aplicaciones semejantes aparecieron en fabricación, telecomunicaciones, energía y mantenimiento técnico. En estos ámbitos, la IA simbólica resultaba especialmente útil cuando existía una gran cantidad de conocimiento procedimental que podía formularse de manera explícita y cuando el valor de una decisión dependía de considerar numerosas condiciones de forma sistemática.
También se desarrollaron aplicaciones en geología, exploración de recursos, finanzas, administración y otros campos profesionales. Los sistemas podían clasificar situaciones, evaluar riesgos, interpretar señales o recomendar acciones según criterios previamente incorporados. En muchos casos, la ventaja principal no era alcanzar una inteligencia comparable a la humana, sino ofrecer consistencia, rapidez y capacidad para manejar un conjunto amplio de reglas sin olvidar ninguna de ellas. Un profesional podía beneficiarse de una herramienta capaz de revisar numerosas condiciones en segundos y ofrecer una explicación de la conclusión alcanzada. Esta capacidad de justificar una recomendación era especialmente valiosa en la IA simbólica, porque el sistema podía mostrar qué reglas había activado y qué hechos había considerado, algo importante en entornos donde la transparencia de la decisión tenía valor técnico o administrativo.
Estas aplicaciones hicieron visible una lección que marcaría toda la historia posterior de la inteligencia artificial: la utilidad práctica no depende necesariamente de construir una inteligencia general. Un sistema estrechamente especializado puede resultar extremadamente valioso si resuelve bien un problema importante, está integrado en un proceso profesional y sus límites son conocidos. Al mismo tiempo, la experiencia mostró que el éxito dependía de mantener actualizadas las bases de conocimiento, revisar las reglas y adaptar el sistema cuando cambiaban las condiciones del dominio. Allí donde el conocimiento podía formalizarse con claridad, la IA simbólica ofrecía herramientas potentes; donde la realidad era demasiado abierta, ambigua o cambiante, sus dificultades aumentaban rápidamente. Precisamente en esa frontera entre eficacia especializada y rigidez estructural aparecería uno de los grandes límites del enfoque simbólico: la imposibilidad práctica de representar de forma explícita toda la complejidad del mundo.
5.6. Los límites de representar explícitamente el mundo
La inteligencia artificial simbólica mostró durante décadas que una máquina podía utilizar reglas, categorías y relaciones para resolver problemas complejos, pero también reveló una dificultad fundamental: el mundo real es mucho más rico que cualquier representación explícita que intentemos construir de él. Una base de conocimiento puede contener miles de hechos y reglas, y aun así dejar fuera circunstancias que una persona comprende de manera casi automática. La vida cotidiana está llena de excepciones, matices, ambigüedades y conocimientos tácitos que raramente formulamos de manera consciente. Sabemos que una taza puede romperse si cae, que una puerta cerrada impide pasar o que una frase puede ser irónica según el contexto, pero normalmente no necesitamos convertir cada una de esas intuiciones en una regla formal. Una máquina simbólica, en cambio, solo puede utilizar aquello que ha sido representado de alguna manera dentro de su sistema.
Este problema aparece con claridad cuando intentamos describir situaciones abiertas. En un entorno reducido, como un juego con reglas precisas o una tarea técnica bien delimitada, resulta posible especificar estados, acciones y condiciones con relativa eficacia. Pero en la realidad cotidiana cada situación depende de numerosos factores que pueden cambiar de forma inesperada. Un mismo hecho puede tener consecuencias distintas según el lugar, el momento, la intención o la información previa. Para representar todo ello sería necesario introducir cantidades enormes de conocimiento y, además, explicar cómo se relacionan entre sí los distintos elementos. La dificultad no reside solo en almacenar información, sino en decidir qué información es relevante en cada momento. Las personas descartan de forma intuitiva innumerables posibilidades absurdas; un sistema simbólico necesita mecanismos explícitos para hacer algo semejante.
A esta dificultad se suma el llamado conocimiento de sentido común. Gran parte de nuestra capacidad para comprender el mundo se apoya en supuestos que casi nunca verbalizamos: los objetos ocupan espacio, las personas tienen objetivos, las acciones producen efectos y muchos acontecimientos siguen patrones razonables. Estos conocimientos no forman una lista sencilla de reglas, sino una red flexible de expectativas adquiridas mediante experiencia. Durante décadas, la inteligencia artificial intentó construir grandes bases de conocimiento capaces de recoger parte de ese sentido común, pero el problema resultó extraordinariamente difícil. Cada regla añadida podía requerir nuevas excepciones, y cada excepción podía introducir conflictos con otras partes del sistema. La representación explícita empezaba a crecer hasta convertirse en un problema de mantenimiento tan complejo como el propio dominio que pretendía describir.
Los límites de la inteligencia artificial simbólica. Las reglas explícitas funcionan bien en entornos definidos, pero encuentran dificultades cuando deben representar situaciones ambiguas, cambiantes o llenas de excepciones. La IA simbólica permitió organizar conocimientos mediante reglas, categorías y relaciones explícitas. Sin embargo, el mundo real rara vez se comporta de forma completamente ordenada. La ambigüedad, la información incompleta y los cambios de contexto mostraron los límites de este enfoque y favorecieron, con el tiempo, el desarrollo de métodos capaces de aprender a partir de datos y experiencia.
La incertidumbre constituye otro límite importante. Las reglas simbólicas clásicas funcionan especialmente bien cuando los hechos son claros y las relaciones pueden expresarse de manera precisa, pero muchas situaciones reales no ofrecen información completa. Un síntoma puede tener varias causas, una observación puede ser dudosa y una decisión puede depender de probabilidades. Para enfrentarse a estos problemas fue necesario incorporar métodos capaces de manejar grados de confianza, información incompleta y excepciones. Aun así, representar todas las combinaciones posibles seguía siendo difícil. El mundo no se comporta como un conjunto perfectamente ordenado de proposiciones verdaderas o falsas, y una inteligencia artificial que aspire a desenvolverse fuera de entornos controlados necesita tolerar ambigüedad, revisar hipótesis y adaptarse a información nueva.
También existe un problema de escala. Aunque fuera posible formalizar una gran cantidad de conocimiento, utilizarlo de manera eficiente no resulta trivial. Una base de reglas muy extensa puede generar numerosas inferencias posibles y hacer que el sistema deba explorar una cantidad enorme de combinaciones. Cuanto más rica es la representación, más difícil puede volverse el razonamiento. Este fenómeno muestra que aumentar el conocimiento no garantiza automáticamente una mejora proporcional del comportamiento. La inteligencia necesita también mecanismos eficaces para seleccionar qué información utilizar y cuándo utilizarla. En la práctica, muchos sistemas simbólicos alcanzaron buenos resultados precisamente porque restringían cuidadosamente su ámbito de actuación. Esa especialización era una fortaleza, pero al mismo tiempo mostraba hasta qué punto resultaba difícil extender los mismos métodos a problemas más generales.
Los límites de la representación explícita no significaron el fracaso de la inteligencia artificial simbólica. Sus técnicas continúan siendo valiosas allí donde las reglas son claras, la explicabilidad importa y el conocimiento puede estructurarse de manera relativamente estable. Sin embargo, la experiencia acumulada mostró que una inteligencia flexible no podía depender únicamente de escribir de antemano todo lo que una máquina debía saber. El mundo contiene demasiadas variaciones y excepciones para quedar completamente encerrado en una colección de reglas. Esta constatación empujó a muchos investigadores hacia otros enfoques capaces de extraer regularidades directamente de los datos y adaptar el comportamiento a partir de ejemplos. La transición no fue inmediata ni sustituyó por completo al razonamiento simbólico, pero preparó uno de los grandes cambios de la disciplina: pasar de sistemas que dependían principalmente del conocimiento introducido por programadores a máquinas capaces de aprender parte de ese conocimiento a partir de la experiencia.
La historia de la inteligencia artificial no avanzó como una línea ascendente de descubrimientos cada vez más espectaculares. Hubo periodos de entusiasmo, inversión y confianza casi ilimitada, seguidos por etapas de decepción en las que muchos proyectos quedaron paralizados, desaparecieron equipos de investigación y se redujo drásticamente la financiación. Estas crisis, conocidas como los «inviernos de la inteligencia artificial», no fueron simples interrupciones accidentales, sino momentos decisivos para entender cómo madura una disciplina científica. Cada invierno apareció cuando las promesas habían crecido más rápido que las capacidades reales de la tecnología y obligó a revisar métodos, expectativas y objetivos.
Parte del problema estaba en la distancia entre los éxitos obtenidos en entornos controlados y la dificultad de trasladarlos a situaciones abiertas. Los primeros programas podían demostrar teoremas, resolver rompecabezas o tomar decisiones dentro de dominios muy estructurados, pero esas mismas técnicas perdían eficacia al enfrentarse a problemas más ambiguos, variables o extensos. La percepción, el lenguaje cotidiano y el sentido común exigían cantidades de conocimiento difíciles de formalizar, mientras que los espacios de búsqueda crecían hasta volverse inmanejables. Lo que en una demostración parecía una capacidad general podía revelar, al aumentar la escala, una dependencia profunda de simplificaciones cuidadosamente elegidas.
Las limitaciones del hardware agravaban estas dificultades. Los ordenadores de las décadas de 1960 y 1970 disponían de una capacidad de memoria y procesamiento extraordinariamente pequeña en comparación con la tecnología posterior. Muchos algoritmos eran conceptualmente interesantes, pero necesitaban recursos que las máquinas disponibles no podían proporcionar. Procesar grandes cantidades de datos, explorar millones de alternativas o trabajar con representaciones complejas resultaba lento y costoso. En otros casos, el problema no podía resolverse simplemente aumentando la velocidad del ordenador: los propios métodos escalaban mal y exigían cantidades crecientes de recursos. La frontera entre una buena idea teórica y un sistema realmente operativo se hizo entonces mucho más visible.
El entusiasmo inicial había generado además expectativas económicas y políticas considerables. Gobiernos, organismos militares, universidades y empresas habían financiado proyectos con la esperanza de obtener traducción automática, reconocimiento del lenguaje, robots flexibles o sistemas capaces de resolver problemas complejos en plazos relativamente breves. Cuando esos objetivos no se alcanzaron, la reacción fue severa. Informes críticos cuestionaron determinados programas, algunas líneas de financiación se redujeron y la inteligencia artificial empezó a adquirir una reputación de disciplina que prometía más de lo que podía ofrecer. El primer invierno se desarrolló principalmente durante la década de 1970; años después, la expansión de los sistemas expertos volvería a despertar el entusiasmo antes de desembocar en una segunda crisis hacia finales de los años ochenta y comienzos de los noventa.
El segundo invierno mostró que el problema no afectaba únicamente a los primeros experimentos académicos. Los sistemas expertos habían demostrado utilidad real, pero también resultaban caros de construir, difíciles de mantener y poco flexibles cuando cambiaban las condiciones para las que habían sido diseñados. Al mismo tiempo, algunas iniciativas industriales no lograron cumplir las expectativas comerciales que habían despertado. Cuando tecnologías rivales ofrecieron soluciones más simples o económicas, numerosos proyectos perdieron apoyo. La expresión «inteligencia artificial» llegó incluso a evitarse en algunos contextos, mientras investigaciones relacionadas continuaban bajo nombres más específicos. La disciplina no desapareció; cambió de escala, de lenguaje y de prioridades.
Los inviernos de la IA fueron, por ello, tanto crisis como procesos de aprendizaje. Mostraron que la inteligencia es más difícil de reproducir de lo que sugerían los primeros éxitos, que el progreso depende tanto de buenos métodos como de datos y capacidad de cálculo, y que las promesas tecnológicas deben mantener una relación razonable con los resultados comprobables. También favorecieron la diversificación del campo: mientras algunas líneas simbólicas continuaban desarrollándose, crecían enfoques probabilísticos, estadísticos y basados en aprendizaje. La recuperación posterior no consistiría simplemente en retomar las mismas ideas con ordenadores más rápidos, sino en transformar progresivamente la manera de construir sistemas inteligentes. Comprender estos ciclos de entusiasmo y desencanto permite ver la inteligencia artificial no como una sucesión de milagros técnicos, sino como una ciencia que también avanzó gracias a sus fracasos.
6.1. Expectativas excesivas y resultados insuficientes
El rápido entusiasmo que acompañó a los primeros años de la inteligencia artificial produjo un problema que terminaría repitiéndose varias veces a lo largo de su historia: las expectativas crecieron con más rapidez que los resultados. Los primeros programas habían demostrado que una máquina podía resolver determinados problemas, manipular símbolos, jugar o encontrar demostraciones lógicas, y muchos investigadores interpretaron esos éxitos como indicios de que capacidades mucho más generales estaban relativamente cerca. La dificultad real de la inteligencia humana todavía no se comprendía bien desde el punto de vista computacional, y era fácil imaginar que bastaría con añadir más reglas, mejores algoritmos y ordenadores más potentes para avanzar desde tareas simples hacia sistemas verdaderamente flexibles. El tiempo demostraría que esa extrapolación era demasiado optimista.
Una de las causas principales fue que muchos de los primeros éxitos se obtenían en entornos cuidadosamente preparados. Los problemas estaban bien definidos, las reglas eran conocidas, el número de variables era limitado y los objetivos podían expresarse con claridad. En esas condiciones, los programas podían ofrecer resultados sorprendentes. Pero cuando se intentaba ampliar el mismo método a situaciones más abiertas, aparecían dificultades mucho mayores. El lenguaje natural contenía ambigüedades, la percepción exigía interpretar señales ruidosas, el conocimiento cotidiano estaba lleno de excepciones y la planificación real dependía de circunstancias cambiantes. La inteligencia humana parecía apoyarse en enormes cantidades de experiencia implícita que no podían traducirse fácilmente a una colección manejable de reglas. Lo que funcionaba en un pequeño mundo formalizado no se trasladaba automáticamente a la complejidad del entorno real.
También se subestimó el crecimiento explosivo de las posibilidades. Muchos problemas podían formularse como búsquedas entre diferentes alternativas, pero el número de combinaciones aumentaba con tal rapidez que una máquina podía quedar atrapada examinando opciones durante tiempos impracticables. Este fenómeno, conocido en muchos contextos como explosión combinatoria, reveló que disponer de un procedimiento correcto no era suficiente. Un algoritmo podía resolver un problema en teoría y seguir siendo inútil en la práctica si requería demasiados pasos. Aumentar la velocidad del ordenador ayudaba, pero no eliminaba siempre la dificultad, porque un crecimiento exponencial termina superando con rapidez cualquier mejora razonable del hardware. Los investigadores tuvieron que descubrir que el verdadero reto no consistía únicamente en hacer que una máquina buscara, sino en proporcionarle criterios que permitieran ignorar gran parte de aquello que no merecía ser explorado.
Las promesas más ambiciosas agravaron la situación. Durante los años iniciales se hicieron previsiones muy optimistas sobre traducción automática, comprensión del lenguaje, reconocimiento visual, robótica y resolución general de problemas. Algunas de esas metas acabarían alcanzándose muchas décadas después mediante técnicas muy diferentes y con recursos computacionales incomparablemente mayores, pero en aquel momento los métodos disponibles estaban lejos de poder cumplirlas. Cuando un campo científico obtiene financiación asociada a objetivos concretos, la diferencia entre una demostración experimental y una aplicación fiable adquiere una importancia decisiva. Un prototipo puede funcionar bajo condiciones controladas y, sin embargo, fallar cuando debe enfrentarse a la variedad, el ruido y las excepciones del mundo real. Esa brecha comenzó a hacerse demasiado visible para ser ignorada.
La inteligencia artificial tuvo que enfrentarse entonces a una paradoja incómoda. Sus primeros resultados eran auténticos y científicamente valiosos, pero habían sido interpretados como pruebas de un progreso más general del que realmente representaban. La disciplina no había fracasado en sentido absoluto; había descubierto que los problemas eran mucho más difíciles de lo previsto. Esta diferencia es importante. Resolver una parte limitada de una tarea no significa que la solución pueda ampliarse sin obstáculos, y una máquina muy competente dentro de un dominio específico puede seguir siendo incapaz de desenvolverse fuera de él. La investigación empezó a comprender que la inteligencia no era una capacidad única que pudiera añadirse gradualmente a los programas, sino un conjunto de procesos relacionados con percepción, conocimiento, memoria, aprendizaje, contexto y adaptación.
La distancia entre promesas y resultados terminaría teniendo consecuencias científicas, económicas e institucionales. A medida que algunos proyectos incumplían los objetivos anunciados, aumentaban las críticas y se hacía más difícil justificar nuevas inversiones. El problema no estaba únicamente en la tecnología disponible, sino también en la forma en que se había presentado su potencial. La inteligencia artificial entraba así en una etapa de revisión obligada: debía distinguir con más cuidado entre lo que era posible demostrar en condiciones experimentales y lo que podía convertirse en una tecnología robusta. Esa experiencia dejaría una enseñanza duradera para toda la disciplina. El progreso real no depende solo de resultados espectaculares, sino de comprender sus límites, medir hasta dónde pueden generalizarse y evitar que el entusiasmo convierta una posibilidad científica en una promesa tecnológica prematura.
6.2. Las limitaciones de los primeros ordenadores
Las primeras investigaciones en inteligencia artificial tuvieron que desarrollarse sobre máquinas cuya capacidad resultaría hoy extraordinariamente limitada. Los ordenadores de las décadas de 1950 y 1960 eran equipos costosos, voluminosos y escasos, instalados principalmente en universidades, organismos públicos, grandes empresas y centros militares. La memoria disponible podía medirse en cantidades que actualmente resultarían insignificantes, el almacenamiento era reducido y el procesamiento de una tarea compleja podía consumir un tiempo considerable. Estas restricciones no impidieron realizar experimentos fundamentales, pero condicionaron profundamente el tipo de inteligencia artificial que podía intentarse. Un investigador debía plantear problemas pequeños, utilizar representaciones muy compactas y aprovechar cuidadosamente cada operación, porque no existía una reserva abundante de capacidad computacional capaz de compensar algoritmos poco eficientes o modelos excesivamente grandes.
La memoria constituía una limitación especialmente importante. Un sistema inteligente necesita trabajar con información: estados posibles de un problema, reglas, vocabularios, posiciones de un juego, relaciones entre conceptos o datos procedentes del entorno. Cuanto más rica es esa representación, mayor espacio requiere almacenarla y manipularla. Los primeros ordenadores podían mantener cantidades muy modestas de información accesible durante la ejecución, lo que obligaba a simplificar drásticamente los dominios estudiados. Esta circunstancia favoreció los llamados micromundos: entornos artificiales pequeños y perfectamente definidos en los que un programa podía desenvolverse con un repertorio limitado de objetos y reglas. Dentro de ellos se obtenían resultados convincentes, pero ampliar el sistema a contextos reales implicaba multiplicar el conocimiento necesario y superar rápidamente los recursos disponibles. La frontera tecnológica terminaba convirtiéndose también en una frontera experimental.
La velocidad de cálculo planteaba un problema semejante. Muchas técnicas tempranas de inteligencia artificial dependían de explorar numerosas posibilidades antes de seleccionar una solución. En un juego, por ejemplo, cada movimiento puede abrir varias alternativas, que a su vez generan otras nuevas; en planificación ocurre algo parecido cuando cada acción conduce a diferentes estados futuros. El número de combinaciones puede crecer con enorme rapidez. Un ordenador lento podía examinar algunos niveles de ese árbol de posibilidades, pero resultaba incapaz de profundizar mucho más sin dedicar un tiempo desproporcionado. Las heurísticas permitían reducir la búsqueda, aunque no eliminaban el problema. La potencia computacional disponible imponía así un límite práctico a estrategias que podían ser correctas desde el punto de vista teórico pero demasiado costosas para convertirse en sistemas realmente eficaces.
También existían dificultades en el almacenamiento, la introducción de datos y la interacción con las máquinas. Durante buena parte de esta etapa, trabajar con un ordenador estaba muy lejos de la experiencia inmediata que hoy asociamos con escribir una instrucción y obtener una respuesta casi instantánea. Tarjetas perforadas, cintas magnéticas, terminales limitados y procesos de ejecución por lotes podían hacer que probar, corregir y volver a ejecutar un programa fuera una operación lenta. El acceso al equipo se compartía entre numerosos usuarios y el tiempo de máquina representaba un recurso valioso. El desarrollo del tiempo compartido y de terminales interactivos mejoró progresivamente esta situación, permitiendo una relación mucho más directa entre investigador y programa, pero durante años la infraestructura tecnológica condicionó el ritmo con el que podían diseñarse, probarse y modificar sistemas experimentales.
Había además una limitación menos visible pero igualmente decisiva: todavía no existía el inmenso entorno digital del que dispondrá la inteligencia artificial posterior. Los documentos, fotografías, grabaciones y bases de datos no se encontraban digitalizados a gran escala, las redes informáticas estaban en sus primeras etapas y recopilar información para un programa era una tarea costosa. Muchos sistemas debían depender de conocimientos introducidos manualmente por investigadores y especialistas. Esto afectaba especialmente a cualquier intento de abordar lenguaje, percepción o conocimiento general. No bastaba con disponer de mejores algoritmos; era necesario convertir el mundo en información procesable y almacenar esa información en máquinas capaces de manejarla. Décadas más tarde, la combinación de grandes conjuntos de datos, redes de comunicación y almacenamiento barato transformaría profundamente esta situación.
Sería incorrecto, sin embargo, explicar las dificultades iniciales de la inteligencia artificial únicamente por la debilidad del hardware. Ordenadores más potentes no habrían resuelto por sí solos los problemas de representación, sentido común, percepción o comprensión del lenguaje que empezaban a descubrirse. Las limitaciones técnicas y las conceptuales actuaban conjuntamente: algunos métodos necesitaban más recursos de los disponibles, mientras que otros requerían ideas nuevas aunque la capacidad de cálculo aumentara. Precisamente esta combinación hizo especialmente difícil valorar cuánto progreso podía esperarse simplemente esperando una nueva generación de máquinas. Durante los primeros años resultaba tentador suponer que una mayor potencia eliminaría muchos obstáculos; con el tiempo quedó claro que la IA necesitaba simultáneamente mejores ordenadores, mejores algoritmos y nuevas formas de utilizar la información. Cuando los resultados comenzaron a quedar por debajo de las expectativas, esta distancia entre recursos, métodos y promesas tendría una consecuencia inmediata: quienes financiaban la investigación empezaron a preguntarse si las inversiones realizadas estaban produciendo realmente aquello que se había anunciado.
© GoldenDayz / Envato Elements
Expectativas, límites y crisis de la inteligencia artificial. El desarrollo de la inteligencia artificial ha atravesado periodos de entusiasmo seguidos por etapas de decepción y reducción de inversiones.Las primeras décadas de la inteligencia artificial estuvieron acompañadas por expectativas muy elevadas. Cuando las capacidades reales de los sistemas no alcanzaron las previsiones, la financiación y el interés disminuyeron. Estos periodos, conocidos como «inviernos de la inteligencia artificial», marcaron profundamente la evolución de la disciplina.
6.3. Problemas de financiación
La inteligencia artificial dependió desde sus primeros años de una relación muy estrecha con la financiación pública, universitaria y militar. Los ordenadores eran costosos, los equipos de investigación necesitaban infraestructuras especializadas y muchos proyectos solo podían mantenerse gracias al apoyo de organismos capaces de asumir inversiones a largo plazo. Durante las décadas de 1950 y 1960, el entusiasmo por la computación y por sus posibles aplicaciones estratégicas favoreció ese respaldo. La traducción automática, la planificación, el reconocimiento de patrones o la resolución de problemas parecían tecnologías con un enorme potencial científico y político. Sin embargo, esa misma financiación generó expectativas concretas. Cuando los resultados empezaron a avanzar más lentamente de lo previsto, los organismos financiadores comenzaron a exigir pruebas más claras de utilidad y a cuestionar si las promesas iniciales justificaban el volumen de recursos empleados.
Uno de los primeros ejemplos importantes apareció en el ámbito de la traducción automática. Durante años se había confiado en que los ordenadores podrían traducir textos entre idiomas con relativa rapidez si se disponía de suficientes reglas lingüísticas y diccionarios. La realidad resultó mucho más difícil. El lenguaje contiene ambigüedad, contexto, expresiones idiomáticas y conocimientos implícitos que no se resuelven simplemente sustituyendo palabras. En 1966, el informe del comité ALPAC en Estados Unidos fue muy crítico con los progresos de la traducción automática y concluyó que las expectativas no se habían cumplido. Como consecuencia, el apoyo económico a varios proyectos se redujo considerablemente. El episodio tuvo un efecto simbólico importante porque mostraba que una línea de investigación muy prometedora podía perder financiación cuando la distancia entre lo anunciado y lo obtenido se hacía demasiado evidente.
En el Reino Unido ocurrió algo parecido algunos años después. En 1973, el llamado informe Lighthill evaluó de forma crítica el estado de la inteligencia artificial académica y señaló, entre otras cuestiones, las dificultades que aparecían al ampliar sistemas que funcionaban en problemas pequeños hacia situaciones más complejas. La evaluación tuvo consecuencias importantes para la financiación británica de la disciplina, que se concentró en un número reducido de centros y proyectos. El informe reflejaba una preocupación creciente: muchas demostraciones eran técnicamente interesantes, pero no siempre mostraban una trayectoria clara hacia aplicaciones robustas. Para los investigadores, esta exigencia podía resultar frustrante, porque la investigación fundamental necesita tiempo y no produce necesariamente beneficios inmediatos; para los financiadores, en cambio, los retrasos acumulados alimentaban la impresión de que el campo había prometido demasiado.
En Estados Unidos, los cambios en las prioridades de organismos como la agencia DARPA también afectaron a la inteligencia artificial. Durante una etapa inicial se había financiado investigación muy exploratoria, con objetivos amplios y plazos relativamente flexibles. Con el tiempo, aumentó la presión para orientar los proyectos hacia aplicaciones concretas y resultados verificables. Algunas líneas siguieron recibiendo apoyo, pero otras tuvieron que adaptarse, reducir su alcance o desaparecer. La financiación se volvió menos tolerante con programas que necesitaban muchos años para demostrar su utilidad. Este cambio modificó el propio ecosistema científico: cuando disminuyen los recursos, no solo se cancelan proyectos, sino que se reducen contrataciones, se dispersan equipos y se ralentiza la formación de nuevos investigadores.
Los problemas económicos también pusieron de manifiesto la relación entre reputación científica y financiación. La expresión «inteligencia artificial» había generado una gran atención precisamente porque sugería objetivos extraordinarios, pero esa visibilidad se volvió en contra del campo cuando algunas metas no se alcanzaron. Los proyectos comenzaron a evaluarse no solo por sus avances parciales, sino por comparación con expectativas muy ambiciosas. Un programa capaz de resolver un problema limitado podía ser científicamente valioso y, al mismo tiempo, parecer decepcionante si se había presentado como paso cercano hacia una inteligencia mucho más general. Esta diferencia entre progreso real y percepción externa condicionó profundamente la disciplina y enseñó a muchos investigadores a formular objetivos más concretos, medibles y prudentes.
La reducción de financiación no significó el abandono completo de la inteligencia artificial, pero sí cambió su ritmo y su forma de presentarse. Algunas investigaciones continuaron bajo denominaciones más específicas, otras se integraron en campos como reconocimiento de patrones, estadística, robótica o procesamiento del lenguaje, y varias líneas sobrevivieron gracias a aplicaciones claramente delimitadas. La disciplina aprendió así que su desarrollo dependía no solo de ideas y máquinas, sino también de instituciones dispuestas a sostener proyectos durante periodos de incertidumbre. Cuando esa confianza disminuye, el avance científico puede enfriarse con rapidez. Este deterioro del apoyo económico, unido a las limitaciones técnicas y a la frustración acumulada por resultados insuficientes, preparó el terreno para lo que después sería conocido como el primer invierno de la inteligencia artificial.
6.4. El primer invierno de la IA
El llamado primer invierno de la inteligencia artificial no fue un acontecimiento único ni una fecha exacta, sino un periodo de enfriamiento progresivo que se hizo especialmente visible durante la década de 1970. Después de años de promesas ambiciosas, varios proyectos comenzaron a mostrar una distancia preocupante entre lo que se esperaba de ellos y lo que realmente podían ofrecer. La expresión «invierno» resume bien esa situación: disminuyó el entusiasmo, se redujo la financiación, algunos laboratorios perdieron recursos y determinadas líneas de investigación quedaron marginadas. La inteligencia artificial no desapareció, pero dejó de percibirse como una tecnología destinada a producir avances espectaculares de forma casi inmediata. Para muchos investigadores, el cambio fue brusco porque venían de una etapa en la que parecía plausible que la comprensión del lenguaje, la visión artificial o la resolución general de problemas estuvieran relativamente cerca.
Las causas del enfriamiento eran múltiples y se reforzaban entre sí. Los programas tempranos funcionaban de manera convincente en entornos muy delimitados, pero tenían enormes dificultades para ampliar su rendimiento fuera de esos marcos. La búsqueda podía volverse inabordable cuando aumentaban las posibilidades, la representación del conocimiento exigía enormes cantidades de información y el lenguaje natural resistía las simplificaciones excesivas. A esto se añadían las limitaciones de los ordenadores disponibles, todavía insuficientes para ejecutar muchos métodos a gran escala. Lo que en una demostración experimental parecía prometedor podía convertirse en un sistema lento, frágil o incapaz de enfrentarse a situaciones nuevas. La inteligencia artificial había demostrado que ciertas tareas podían formalizarse, pero todavía no sabía cómo convertir esa capacidad parcial en una inteligencia flexible y general.
La reducción del apoyo económico agravó el problema. El informe ALPAC sobre traducción automática en Estados Unidos y el informe Lighthill en el Reino Unido contribuyeron a cuestionar la eficacia de algunas líneas de investigación y a limitar nuevas inversiones. Al mismo tiempo, varios organismos financiadores comenzaron a exigir resultados más concretos y aplicaciones claramente justificadas. Esta presión modificó el panorama académico. Los proyectos más exploratorios perdieron atractivo institucional y algunos investigadores tuvieron que redefinir sus objetivos para seguir obteniendo recursos. El efecto fue acumulativo: menos financiación significaba menos equipos, menos personal y menos capacidad para experimentar, lo que a su vez reducía la posibilidad de obtener avances capaces de recuperar la confianza perdida.
El primer invierno también tuvo una dimensión intelectual. La disciplina se vio obligada a reconocer que muchas de sus hipótesis iniciales eran demasiado optimistas. No bastaba con representar un problema mediante símbolos y aplicar reglas de búsqueda para obtener automáticamente comportamientos inteligentes. Las personas utilizan conocimientos implícitos, sentido común, experiencia, contexto y capacidades perceptivas que no eran fáciles de traducir a estructuras formales. La dificultad no estaba únicamente en construir mejores algoritmos, sino en comprender qué tipo de información necesita realmente un sistema para actuar de manera competente. Este reconocimiento fue doloroso para una disciplina joven, pero resultó científicamente valioso porque permitió abandonar algunas simplificaciones y formular problemas de forma más realista.
A pesar de la imagen de crisis, la investigación no se detuvo por completo. Algunos grupos continuaron trabajando en razonamiento simbólico, planificación, robótica, visión, reconocimiento de patrones y otras áreas relacionadas. Parte de la actividad se desplazó hacia problemas más específicos, donde los objetivos podían definirse mejor y los resultados evaluarse con criterios más concretos. También se mantuvieron avances en hardware y software que, aunque no llevaran necesariamente la etiqueta de inteligencia artificial, acabarían siendo fundamentales para su recuperación. El invierno fue, por tanto, una contracción del campo y de sus expectativas más que una desaparición. La disciplina aprendió a sobrevivir reduciendo promesas y concentrándose en tareas donde podía demostrar utilidad.
La principal consecuencia del primer invierno fue introducir una nueva cautela en la relación entre investigación, tecnología y expectativas públicas. La inteligencia artificial había descubierto que una demostración convincente no garantiza una aplicación general y que un progreso parcial puede interpretarse erróneamente como señal de una solución cercana. Ese aprendizaje no impediría que décadas después se repitiera un ciclo parecido, pero sí obligó a la disciplina a revisar sus métodos y a valorar con más atención las limitaciones de cada enfoque. Tras el enfriamiento de los años setenta, nuevos avances y aplicaciones volverían a despertar el entusiasmo, especialmente con el auge de los sistemas expertos. Sin embargo, esa recuperación también traería sus propias promesas y, con ellas, las condiciones para un segundo invierno de la inteligencia artificial.
6.5. El segundo invierno de la IA
El segundo invierno de la inteligencia artificial llegó después de una recuperación que había despertado grandes expectativas durante la década de 1980. El auge de los sistemas expertos, la creación de nuevas empresas especializadas y el interés creciente de gobiernos e industrias parecían indicar que la disciplina había encontrado por fin una vía sólida hacia aplicaciones rentables. En numerosos sectores se desarrollaron programas capaces de apoyar diagnósticos, configurar equipos, interpretar datos o asesorar en decisiones técnicas. La IA volvía a presentarse como una tecnología con un futuro inmediato y amplio. Sin embargo, aquel crecimiento contenía una fragilidad importante: muchas de esas aplicaciones dependían de bases de conocimiento muy costosas de construir y mantener, funcionaban bien solo dentro de dominios estrechos y requerían una infraestructura tecnológica específica. Cuando las expectativas comerciales aumentaron más rápido que la fiabilidad y la flexibilidad de los sistemas, comenzaron a aparecer señales de agotamiento.
Uno de los problemas principales fue precisamente el mantenimiento de los sistemas expertos. Incorporar conocimiento especializado mediante reglas exigía un trabajo continuo de actualización, revisión y corrección. Los dominios profesionales cambian, aparecen nuevas excepciones y las reglas antiguas pueden entrar en conflicto con otras más recientes. Lo que inicialmente parecía una ventaja —hacer explícito el conocimiento— podía convertirse en una carga cuando el número de reglas crecía hasta resultar difícil de administrar. Además, muchos sistemas no se adaptaban bien a situaciones inesperadas. Funcionaban con solvencia dentro del entorno previsto, pero perdían eficacia cuando aparecían casos que no habían sido contemplados durante su diseño. La promesa de inteligencia flexible chocaba de nuevo con la realidad de herramientas muy especializadas.
También influyeron factores económicos y tecnológicos. Durante los años ochenta surgió un mercado alrededor de estaciones de trabajo y hardware especializado para inteligencia artificial, especialmente ligado al lenguaje LISP y a entornos de desarrollo concebidos para sistemas simbólicos. Durante un tiempo, estas plataformas parecieron representar una infraestructura necesaria para la nueva generación de aplicaciones inteligentes. Sin embargo, el rápido abaratamiento y aumento de potencia de los ordenadores convencionales redujo progresivamente esa ventaja. Soluciones más baratas y generales comenzaron a competir con equipos especializados mucho más costosos. Algunas empresas del sector perdieron mercado y numerosas inversiones dejaron de parecer justificadas. El problema ya no era únicamente científico: la propia economía de la industria de la IA empezaba a deteriorarse.
El contexto internacional también contribuyó a elevar y después frustrar expectativas. Japón impulsó en 1982 el proyecto Fifth Generation Computer Systems, una iniciativa ambiciosa destinada a desarrollar nuevas arquitecturas y formas avanzadas de computación basadas, entre otros objetivos, en procesamiento lógico y sistemas inteligentes. Estados Unidos y Europa respondieron con programas propios, temiendo perder liderazgo tecnológico. Durante varios años, estas iniciativas reforzaron la impresión de que se aproximaba una nueva generación de máquinas radicalmente más capaces. Sin embargo, muchos de los objetivos originales resultaron difíciles de alcanzar y algunas de las tecnologías elegidas no terminaron imponiéndose frente a otros enfoques. La distancia entre las grandes declaraciones iniciales y los resultados prácticos contribuyó de nuevo a enfriar el entusiasmo.
Hacia finales de los años ochenta y comienzos de los noventa, la combinación de dificultades técnicas, decepciones comerciales y cambios en las prioridades de financiación provocó una nueva contracción. Varias empresas desaparecieron, determinados proyectos fueron cancelados y la expresión «inteligencia artificial» volvió a adquirir connotaciones incómodas en algunos entornos profesionales. Muchos investigadores continuaron trabajando en problemas claramente vinculados a la IA, pero preferían identificarlos mediante nombres más específicos: aprendizaje automático, reconocimiento de patrones, visión artificial, sistemas probabilísticos, procesamiento del lenguaje o robótica. La disciplina no dejó de existir; se fragmentó parcialmente en comunidades especializadas que podían avanzar sin depender de las grandes promesas asociadas a una inteligencia artificial general.
El segundo invierno fue especialmente importante porque confirmó que el ciclo de entusiasmo y decepción no había sido una anomalía de los primeros años. La inteligencia artificial podía producir tecnologías útiles y, aun así, sufrir una crisis cuando sus capacidades se exageraban o sus costes reales se subestimaban. La lección empezaba a ser más profunda: el progreso no dependía de encontrar una única técnica capaz de resolver todos los problemas, sino de combinar métodos adecuados, mejores datos, mayor potencia de cálculo y objetivos cuidadosamente delimitados. Durante la década de 1990, muchas de esas condiciones comenzarían a cambiar. Los ordenadores serían más rápidos y baratos, crecerían las bases de datos digitales y nuevos enfoques estadísticos y probabilísticos ganarían protagonismo. La recuperación de la IA no llegaría mediante el simple regreso a las ideas anteriores, sino a través de una transformación progresiva del modo de construir sistemas inteligentes.
6.6. Crisis, aprendizaje y recuperación de la disciplina
Los inviernos de la inteligencia artificial dejaron una consecuencia paradójica: debilitaron temporalmente el campo, pero también lo obligaron a madurar. Después de dos grandes ciclos de entusiasmo y decepción, ya resultaba difícil sostener que una única técnica conduciría rápidamente hacia máquinas capaces de reproducir todas las facultades humanas. Las crisis habían mostrado que resolver problemas formales, construir sistemas expertos o demostrar resultados brillantes en dominios restringidos no equivalía a disponer de una inteligencia flexible y general. La disciplina comenzó a asumir con mayor claridad que percepción, lenguaje, aprendizaje, razonamiento y conocimiento cotidiano planteaban dificultades diferentes y podían requerir métodos distintos. Esta pérdida de ingenuidad no significó abandonar la ambición científica, sino sustituir algunas promesas generales por problemas más concretos, evaluables y susceptibles de mejoras progresivas.
Una de las principales lecciones fue la necesidad de medir los resultados con mayor rigor. Los sistemas comenzaron a valorarse menos por demostraciones espectaculares aisladas y más por su comportamiento ante conjuntos amplios de casos, su capacidad para funcionar fuera de condiciones cuidadosamente preparadas y la posibilidad de compararlos con métodos alternativos. La investigación se hizo progresivamente más experimental. En lugar de preguntar solamente si un programa podía realizar una tarea, cobraba importancia saber con qué precisión lo hacía, cuánto tiempo necesitaba, qué recursos consumía y en qué situaciones fallaba. Esta cultura de evaluación permitió distinguir mejor entre una idea prometedora y una tecnología realmente robusta, al tiempo que favoreció avances acumulativos que quizá resultaban menos llamativos que las grandes predicciones iniciales, pero ofrecían una base científica más sólida.
La recuperación estuvo también ligada a una diversificación metodológica. La inteligencia artificial simbólica no desapareció y continuó siendo útil en numerosos problemas, pero dejó de monopolizar el horizonte de la disciplina. Creció el interés por métodos estadísticos, probabilísticos y sistemas capaces de extraer regularidades a partir de datos. Esta transformación fue especialmente importante porque ofrecía otra manera de enfrentarse a problemas donde resultaba difícil escribir manualmente todas las reglas necesarias. En lugar de describir de antemano cada posible situación, podía intentarse que el sistema estimara relaciones a partir de ejemplos. Al mismo tiempo, técnicas procedentes de campos como la estadística, la teoría de decisiones, el reconocimiento de patrones y la optimización comenzaron a integrarse cada vez más estrechamente con la investigación en inteligencia artificial.
Las condiciones tecnológicas estaban cambiando en la misma dirección. Durante las décadas de 1990 y 2000, los ordenadores aumentaron enormemente su velocidad, la memoria y el almacenamiento se abarataron y la expansión de Internet produjo cantidades crecientes de información digital. Problemas que anteriormente habían estado limitados por la escasez de datos o por el coste computacional podían abordarse ahora a una escala mucho mayor. La digitalización de textos, imágenes, sonidos y registros de todo tipo proporcionó material para desarrollar y evaluar nuevos sistemas. Al mismo tiempo, procesadores cada vez más potentes hicieron posible utilizar métodos que décadas antes habían resultado demasiado costosos. La recuperación de la inteligencia artificial no se debió, por tanto, a un único descubrimiento, sino a la convergencia gradual entre mejores algoritmos, mayor capacidad de cálculo y una disponibilidad de datos sin precedentes.
Los avances comenzaron a hacerse visibles en tareas concretas. Sistemas de reconocimiento de voz mejoraron progresivamente, los motores de búsqueda aprendieron a ordenar cantidades enormes de información, la visión artificial avanzó en clasificación y reconocimiento, y los programas especializados alcanzaron resultados impresionantes en juegos y problemas de optimización. En 1997, la victoria de Deep Blue de IBM sobre el campeón mundial de ajedrez Garry Kasparov se convirtió en uno de los acontecimientos más conocidos de esta nueva etapa, aunque aquel sistema estaba muy especializado y no representaba una inteligencia general. Su importancia simbólica residía en mostrar que la combinación de algoritmos, conocimiento del dominio y gran capacidad de cálculo podía alcanzar resultados extraordinarios en tareas complejas. Cada vez era más evidente que la IA podía ofrecer aplicaciones útiles sin necesidad de resolver previamente el problema completo de la inteligencia humana.
La recuperación definitiva de la disciplina surgió así de una actitud más pragmática y plural. La inteligencia artificial aprendió a convivir con sus límites, a combinar enfoques diferentes y a avanzar mediante resultados medibles en lugar de depender únicamente de grandes promesas. Los inviernos no habían demostrado que las máquinas inteligentes fueran una idea equivocada; habían mostrado que el camino era mucho más largo y complejo de lo esperado. Cuando el campo volvió a crecer, lo hizo sobre fundamentos distintos: más datos, mejores ordenadores, métodos probabilísticos, evaluación sistemática y una atención creciente a sistemas capaces de modificar su comportamiento a partir de ejemplos. Esta transformación preparó el terreno para el siguiente gran cambio de la historia de la inteligencia artificial: el paso desde programas definidos principalmente por reglas explícitas hacia máquinas capaces de aprender regularidades directamente de los datos.
La inteligencia artificial cambió profundamente cuando dejó de depender únicamente de reglas escritas de antemano y comenzó a extraer regularidades a partir de ejemplos. El paso no fue inmediato ni supuso abandonar por completo los métodos anteriores, pero introdujo una manera distinta de construir sistemas inteligentes. En lugar de intentar describir todas las condiciones posibles mediante instrucciones explícitas, podía proporcionarse a la máquina un conjunto de datos y un procedimiento capaz de ajustar su comportamiento según los patrones encontrados. La pregunta fundamental cambiaba: ya no era solo «¿qué reglas debemos programar?», sino también «¿qué puede aprender el sistema observando suficientes ejemplos?». Esta transformación abrió el camino al aprendizaje automático y terminó convirtiéndose en uno de los ejes centrales de la inteligencia artificial contemporánea.
Aprender, en este contexto, no significa que una máquina adquiera experiencia del mismo modo que una persona. Significa que un modelo modifica determinados parámetros internos para mejorar su rendimiento en una tarea. Los datos se convierten así en una parte esencial del proceso. Fotografías, textos, registros numéricos, sonidos o mediciones pueden funcionar como ejemplos a partir de los cuales el sistema intenta descubrir relaciones útiles. La calidad del aprendizaje depende tanto del método utilizado como de la información disponible: unos datos incompletos, poco representativos o mal preparados pueden conducir a modelos deficientes, aunque el algoritmo sea técnicamente sofisticado. Entrenar una máquina implica, por tanto, construir una relación cuidadosa entre ejemplos, objetivos y procedimientos de ajuste.
Existen además distintas formas de aprender, según la clase de información que reciba el sistema. En algunos casos, los ejemplos vienen acompañados de una respuesta conocida y la máquina intenta aprender la relación entre entrada y resultado; en otros, debe encontrar por sí misma agrupaciones, estructuras o regularidades sin disponer de etiquetas previamente establecidas. También es posible aprender mediante interacción, recibiendo recompensas o penalizaciones según las consecuencias de las acciones realizadas. Estas estrategias —aprendizaje supervisado, no supervisado y por refuerzo— responden a problemas diferentes y no constituyen niveles sucesivos de inteligencia. Cada una proporciona una manera específica de convertir experiencia computacional en cambios de comportamiento, y muchas aplicaciones actuales combinan elementos de varias de ellas.
El aprendizaje automático introduce además una cuestión metodológica fundamental: un sistema no debe evaluarse únicamente por lo bien que reproduce aquello que ya ha visto. El verdadero interés aparece cuando puede responder adecuadamente ante ejemplos nuevos. Para comprobarlo, los datos suelen dividirse en conjuntos destinados al entrenamiento, a la validación de decisiones durante el desarrollo y a la prueba final del modelo. Esta separación intenta evitar una ilusión peligrosa: confundir memoria con aprendizaje. Un sistema puede obtener resultados excelentes si simplemente se adapta demasiado a los ejemplos utilizados durante su entrenamiento y, sin embargo, fracasar cuando las condiciones cambian ligeramente. La capacidad de generalizar se convierte así en una medida esencial de la calidad del modelo.
De esta diferencia surge uno de los problemas más importantes del aprendizaje automático: el sobreajuste. Un modelo demasiado adaptado a los datos disponibles puede aprender detalles accidentales, ruido o excepciones que no representan realmente el fenómeno que se intenta capturar. En el extremo contrario, un modelo demasiado simple puede ser incapaz de reconocer relaciones importantes. Encontrar un equilibrio entre ambos extremos exige controlar el error, comparar resultados y ajustar cuidadosamente la complejidad del sistema. Esta tarea muestra que el aprendizaje automático no consiste en introducir grandes cantidades de información y esperar que aparezca automáticamente una solución. Requiere diseño experimental, selección de datos, evaluación continua y decisiones sobre qué significa realmente «funcionar bien» en el problema concreto.
El paso del programa que obedece a la máquina que aprende transformó así la relación entre conocimiento y computación. Una parte de aquello que antes debía ser formulado explícitamente por programadores pudo empezar a obtenerse mediante ejemplos, estadísticas y procesos de optimización. Este epígrafe recorrerá esa transformación desde los fundamentos del aprendizaje automático hasta las principales formas de entrenamiento y los criterios utilizados para comprobar si un modelo ha aprendido algo realmente útil. Datos, supervisión, exploración de estructuras, recompensas, validación, error y generalización formarán parte de una misma cuestión: cómo conseguir que una máquina no se limite a repetir instrucciones, sino que construya regularidades capaces de aplicarse más allá de los casos que ya conoce. Sobre esta base se desarrollarán después las redes neuronales y el aprendizaje profundo, que ampliarán enormemente la escala y complejidad de este nuevo paradigma.
7.1. Qué es el aprendizaje automático
El aprendizaje automático, o machine learning, es una rama de la inteligencia artificial que busca construir sistemas capaces de mejorar su comportamiento a partir de datos y experiencia computacional. La diferencia fundamental respecto a la programación tradicional está en la forma de obtener las reglas que guían la tarea. En un programa convencional, el desarrollador define de manera explícita qué debe hacer la máquina ante cada situación prevista; en aprendizaje automático, en cambio, se diseña un procedimiento capaz de ajustar un modelo utilizando ejemplos. El objetivo no es enumerar manualmente todas las respuestas posibles, sino permitir que el sistema descubra relaciones útiles dentro de los datos. Esta idea resulta especialmente valiosa cuando el problema contiene demasiadas variaciones para describirlas una por una, como ocurre al reconocer imágenes, detectar mensajes no deseados, estimar riesgos o clasificar documentos.
Un modelo de aprendizaje automático puede entenderse como una representación matemática ajustable. Antes del entrenamiento, sus parámetros no contienen todavía la información necesaria para resolver correctamente la tarea. A medida que recibe ejemplos, el sistema compara sus resultados con algún criterio de rendimiento y modifica esos parámetros para reducir el error o mejorar una determinada medida. Aprender significa precisamente realizar esos ajustes de forma sistemática. El proceso puede adoptar formas muy distintas según el tipo de modelo y de problema, pero la lógica general permanece: existe una entrada, una transformación interna y una salida que debe evaluarse. El modelo no adquiere conocimiento en el sentido humano del término; construye una estructura numérica capaz de capturar regularidades que resulten útiles para realizar predicciones o tomar decisiones.
El aprendizaje automático comenzó a ganar importancia porque numerosos problemas resultaban difíciles de resolver mediante reglas escritas explícitamente. Pensemos en la tarea de reconocer un gato en una fotografía. Una persona podría intentar describir patas, orejas, ojos, proporciones o texturas, pero convertir todas las variaciones posibles de iluminación, postura, raza, fondo y perspectiva en un conjunto de reglas exactas sería extremadamente complicado. Un enfoque basado en aprendizaje permite mostrar al sistema muchos ejemplos y utilizar métodos capaces de detectar patrones relevantes. El cambio es profundo: en lugar de definir qué características deben buscarse en cada caso, se permite que el modelo construya internamente representaciones que le ayuden a distinguir unas imágenes de otras. La misma lógica puede aplicarse a sonidos, textos, señales biomédicas o datos económicos.
No todos los algoritmos aprenden del mismo modo ni persiguen el mismo objetivo. Algunos están diseñados para clasificar casos dentro de categorías; otros estiman valores numéricos, detectan agrupaciones, reducen la complejidad de los datos o seleccionan acciones dentro de un entorno. Existen modelos muy simples y otros extraordinariamente complejos. Una regresión puede captar una relación relativamente directa entre variables, mientras que una red neuronal profunda puede contener millones o miles de millones de parámetros. Ambos pertenecen al aprendizaje automático porque comparten un principio esencial: el comportamiento del sistema se ajusta utilizando datos en lugar de quedar completamente determinado por reglas codificadas manualmente.
El éxito de un modelo depende además de algo más que del algoritmo elegido. La calidad, diversidad y representatividad de los datos son fundamentales. Un sistema entrenado con ejemplos sesgados, incompletos o poco variados puede aprender regularidades que funcionen bien dentro del conjunto utilizado y fracasen cuando se enfrente a situaciones reales diferentes. También importa cómo se mide el rendimiento, qué objetivo se optimiza y qué errores se consideran más relevantes. En algunos problemas, una pequeña mejora estadística puede tener poco valor práctico; en otros, distinguir correctamente casos raros puede ser mucho más importante que obtener una alta precisión media. El aprendizaje automático exige, por tanto, combinar matemáticas, informática, conocimiento del dominio y evaluación experimental.
La gran aportación del aprendizaje automático consiste en haber cambiado la manera de pensar la construcción de sistemas inteligentes. En lugar de exigir que el programador describa de antemano todas las reglas necesarias, permite que parte de la estructura funcional surja mediante entrenamiento. Esto no elimina el diseño humano: alguien debe escoger los datos, el modelo, la función de evaluación, los procedimientos de ajuste y las condiciones de uso. Pero sí transforma profundamente la relación entre programación y comportamiento. La máquina deja de limitarse a ejecutar una secuencia fija y pasa a ajustar su actuación a partir de ejemplos. Comprender este cambio obliga ahora a examinar el elemento que lo hace posible: los datos utilizados durante el entrenamiento y la manera en que esos ejemplos se convierten en experiencia para el modelo.
7.2. Datos, ejemplos y entrenamiento
En el aprendizaje automático, los datos cumplen una función semejante a la experiencia: proporcionan al sistema los ejemplos a partir de los cuales intentará descubrir regularidades útiles. Una imagen, una frase, una medición, un registro de ventas, una señal de audio o una secuencia de movimientos pueden convertirse en datos si se representan de una manera procesable por el modelo. Pero disponer de grandes cantidades de información no basta por sí solo. Los datos deben contener algún tipo de estructura relevante para la tarea y representar con suficiente fidelidad las situaciones que el sistema encontrará después. Si un modelo aprende únicamente a partir de casos muy parecidos entre sí, su capacidad para responder ante ejemplos diferentes será limitada. Por eso, una de las decisiones más importantes de cualquier proyecto de aprendizaje automático consiste en determinar qué información se utiliza, cómo se recoge y hasta qué punto refleja el problema real.
Los ejemplos pueden incluir únicamente las entradas o estar acompañados de información adicional sobre la respuesta deseada. En un sistema destinado a reconocer imágenes, por ejemplo, cada fotografía puede incluir una etiqueta que indique qué objeto aparece en ella. En otros casos, el sistema recibe grandes cantidades de datos sin etiquetas y debe encontrar por sí mismo regularidades internas. La naturaleza del ejemplo determina en gran medida qué tipo de aprendizaje puede realizarse. También importa la forma en que la información se representa. Una imagen puede convertirse en una matriz de valores numéricos, un sonido en una secuencia de muestras y un texto en unidades codificadas matemáticamente. La máquina no trabaja directamente con «fotografías», «palabras» o «melodías» tal como las percibimos nosotros, sino con representaciones numéricas que conservan determinadas relaciones útiles para la tarea.
El entrenamiento es el proceso mediante el cual el modelo ajusta sus parámetros utilizando esos ejemplos. De manera simplificada, el sistema recibe una entrada, produce una respuesta y evalúa en qué medida esa respuesta se ajusta al objetivo establecido. A partir del error observado, un procedimiento de optimización modifica los parámetros internos para mejorar el comportamiento futuro. Este ciclo se repite muchas veces sobre numerosos ejemplos. En algunos modelos, el ajuste puede ser relativamente sencillo; en otros, especialmente en las redes neuronales, puede implicar millones de parámetros modificados de forma gradual. El entrenamiento no consiste en almacenar una respuesta completa para cada caso, sino en construir una configuración interna capaz de capturar relaciones que puedan resultar útiles ante datos que el sistema no ha visto exactamente antes.
La calidad de los datos influye de manera decisiva en aquello que el modelo puede aprender. Un conjunto lleno de errores, duplicados, ejemplos mal etiquetados o casos poco representativos puede transmitir regularidades equivocadas. También pueden aparecer sesgos cuando ciertos grupos, situaciones o condiciones están sobrerrepresentados y otros apenas aparecen. El modelo no sabe por sí mismo qué parte de los datos es accidental, injusta o irrelevante; aprende las relaciones que el procedimiento de entrenamiento considera útiles para reducir el error. Por ello, preparar un conjunto de datos suele requerir tareas de limpieza, selección, revisión y equilibrio. En muchos proyectos, una parte sustancial del trabajo no se dedica al algoritmo, sino precisamente a construir una base de ejemplos suficientemente fiable como para que el entrenamiento tenga sentido.
La cantidad de datos también importa, aunque su efecto depende del problema y del modelo. Algunos métodos pueden funcionar bien con conjuntos relativamente pequeños si la tarea está bien definida y las variables son informativas. Los modelos más complejos suelen necesitar cantidades mayores de ejemplos para ajustar numerosos parámetros sin limitarse a memorizar detalles accidentales. Sin embargo, más datos no significan automáticamente mejor aprendizaje. Si la información es repetitiva, pobre o sesgada, aumentar su volumen puede reforzar los mismos problemas. Lo importante es la combinación entre cantidad, diversidad y calidad. Un conjunto amplio de ejemplos variados permite que el sistema observe distintas situaciones y tenga más oportunidades de distinguir qué patrones son generales y cuáles dependen de circunstancias particulares.
El entrenamiento convierte así los datos en una forma de experiencia computacional, pero esa experiencia está siempre condicionada por las decisiones humanas que rodean el proceso. Alguien selecciona qué ejemplos se recogen, cómo se representan, qué objetivo debe optimizarse y qué criterio se utiliza para medir el resultado. El modelo aprende dentro de ese marco, no fuera de él. Comprender esta relación es esencial porque evita imaginar el aprendizaje automático como un proceso autónomo en el que la máquina descubre por sí sola una verdad contenida en los datos. Lo que realmente ocurre es una interacción entre información, arquitectura, procedimiento de entrenamiento y objetivo. Según cómo se construya esa interacción, el sistema podrá aprender de formas muy diferentes. La primera de ellas, y una de las más utilizadas, consiste en entrenar con ejemplos cuya respuesta correcta ya es conocida: el aprendizaje supervisado.
Del programa rígido al aprendizaje automático. El desarrollo del machine learning cambió la relación entre personas y máquinas: en lugar de especificar cada regla de comportamiento, los sistemas comenzaron a aprender patrones a partir de ejemplos, datos y experiencia. © Stockasso / Envato Elements.
7.3. Aprendizaje supervisado
El aprendizaje supervisado es una de las formas más extendidas de aprendizaje automático y se basa en una idea intuitiva: aprender a partir de ejemplos cuya respuesta correcta ya conocemos. Durante el entrenamiento, el sistema recibe pares formados por una entrada y una etiqueta o valor asociado. Puede tratarse de una fotografía acompañada de la indicación «gato», de un correo marcado como deseado o no deseado, de un registro médico vinculado a un diagnóstico conocido o de una vivienda asociada a su precio de venta. El modelo intenta descubrir qué relaciones conectan esas entradas con sus resultados y ajustar sus parámetros para producir respuestas cada vez más cercanas a las esperadas. La «supervisión» no significa que una persona esté corrigiendo continuamente a la máquina, sino que los ejemplos proporcionan una referencia conocida con la que comparar sus predicciones.
Dentro de este enfoque suelen distinguirse dos grandes tipos de tareas. En la clasificación, el objetivo consiste en asignar cada ejemplo a una categoría. Un sistema puede aprender a distinguir diferentes especies de plantas, identificar si una transacción parece fraudulenta o reconocer qué tipo de objeto aparece en una imagen. En la regresión, en cambio, la salida es un valor numérico continuo: estimar una temperatura, prever una demanda o calcular aproximadamente el precio de un inmueble. Aunque estas tareas parecen distintas, comparten la misma lógica fundamental. El modelo observa ejemplos anteriores, identifica regularidades y construye una función capaz de relacionar entradas y resultados. Lo importante no es que memorice cada caso, sino que encuentre patrones suficientemente generales como para aplicarlos posteriormente a datos que no son idénticos a los utilizados durante el entrenamiento.
El proceso puede entenderse como una sucesión de predicciones y correcciones. Al principio, el modelo produce resultados poco precisos porque sus parámetros todavía no reflejan adecuadamente la estructura del problema. Cada vez que compara una predicción con la respuesta conocida, obtiene una medida del error. Un algoritmo de optimización utiliza esa información para modificar gradualmente los parámetros en la dirección que reduce ese error. Repetido sobre numerosos ejemplos, este procedimiento va moldeando el comportamiento del sistema. En algunos modelos, las relaciones aprendidas pueden ser relativamente fáciles de interpretar; en otros, como las redes neuronales profundas, la representación interna llega a ser mucho más compleja. En todos los casos, sin embargo, el aprendizaje se produce porque existe una señal que indica hasta qué punto la respuesta generada coincide con la que se considera correcta.
La calidad de las etiquetas es por ello tan importante como la calidad de los datos de entrada. Si las respuestas conocidas contienen errores, criterios inconsistentes o clasificaciones ambiguas, el modelo aprenderá sobre una base defectuosa. Crear conjuntos supervisados puede exigir una gran cantidad de trabajo humano: revisar imágenes, transcribir grabaciones, clasificar documentos o validar casos especializados. En ámbitos científicos y profesionales, además, no siempre basta con que cualquier persona asigne una etiqueta; puede ser necesario recurrir a especialistas capaces de interpretar correctamente la información. Esta dependencia explica una de las principales limitaciones del aprendizaje supervisado: disponer de muchos datos no garantiza disponer de muchos ejemplos correctamente etiquetados, y en algunos campos obtener esas etiquetas puede resultar costoso, lento o incluso difícil de definir con absoluta claridad.
El aprendizaje supervisado también refleja los criterios incorporados en los ejemplos. Si ciertas situaciones aparecen con mucha frecuencia y otras apenas están representadas, el modelo puede desarrollar un rendimiento desigual. Un sistema entrenado con imágenes tomadas bajo determinadas condiciones puede funcionar peor con iluminación, dispositivos o contextos diferentes; un clasificador puede aprender asociaciones presentes en los datos históricos aunque esas asociaciones no sean deseables ni universales. Esto obliga a examinar cuidadosamente qué representan realmente las etiquetas y qué información está utilizando el modelo para producir sus resultados. Una precisión elevada dentro del conjunto de entrenamiento no demuestra por sí sola que el sistema haya captado la estructura profunda del problema. Puede haber aprendido atajos estadísticos que funcionan en los ejemplos disponibles pero que se debilitan cuando cambian las circunstancias.
A pesar de estas dificultades, el aprendizaje supervisado ha demostrado una enorme eficacia porque permite convertir grandes colecciones de ejemplos resueltos en modelos capaces de realizar nuevas predicciones automáticamente. Su potencia reside en combinar una referencia clara —la respuesta conocida— con procedimientos capaces de ajustar progresivamente el comportamiento del sistema. Allí donde existen buenos datos etiquetados, puede utilizarse para abordar tareas de clasificación y estimación con resultados muy precisos. Pero no todos los problemas ofrecen respuestas previamente conocidas ni resulta siempre viable construir enormes colecciones etiquetadas. En muchas situaciones disponemos simplemente de datos y queremos descubrir qué estructura existe dentro de ellos. Esa necesidad conduce a una estrategia diferente: el aprendizaje no supervisado, donde la máquina debe buscar regularidades sin recibir de antemano una solución correcta para cada ejemplo.
7.4. Aprendizaje no supervisado
El aprendizaje no supervisado parte de una situación distinta: el sistema recibe datos, pero no dispone de una respuesta correcta asociada a cada ejemplo. No hay etiquetas que indiquen qué categoría corresponde a una imagen, qué resultado debería producirse o qué valor debe predecirse. La tarea consiste en descubrir regularidades internas, semejanzas, estructuras o patrones presentes en la información. Esta diferencia modifica profundamente la naturaleza del problema. En lugar de aprender una relación entre entradas y respuestas conocidas, el modelo intenta organizar los datos según propiedades que emergen de ellos mismos. El objetivo puede ser identificar grupos naturales, detectar configuraciones frecuentes, reducir la complejidad de la información o encontrar representaciones más compactas que permitan comprender mejor un conjunto de datos.
Una de las aplicaciones más conocidas es la agrupación o clustering. En este caso, el sistema intenta reunir ejemplos que presentan características similares sin que nadie haya definido previamente qué grupos deben existir. Un conjunto de clientes, por ejemplo, puede organizarse según comportamientos de compra; un catálogo de documentos puede separarse en grupos temáticos; determinadas observaciones científicas pueden revelar patrones que no eran evidentes al examinar los datos individualmente. El modelo no descubre necesariamente categorías «verdaderas» en un sentido absoluto, sino agrupaciones que dependen de cómo se representan los datos y del criterio de similitud empleado. Por eso, los resultados deben interpretarse con cuidado: encontrar una estructura matemática no significa automáticamente haber identificado una división significativa desde el punto de vista humano.
Otra tarea importante consiste en reducir la dimensionalidad. Muchos conjuntos de datos contienen gran cantidad de variables, algunas redundantes o estrechamente relacionadas entre sí. Trabajar directamente con todas ellas puede resultar costoso y dificultar la interpretación. Los métodos no supervisados pueden intentar representar esa información mediante un número menor de dimensiones conservando, en la medida de lo posible, las relaciones más relevantes. Esta reducción puede facilitar la visualización, disminuir el ruido o preparar los datos para otros algoritmos. En lugar de examinar cientos o miles de características por separado, se busca una estructura más compacta que capture parte de la organización subyacente. La capacidad de construir representaciones útiles sin etiquetas será especialmente importante en etapas posteriores del desarrollo de la inteligencia artificial.
El aprendizaje no supervisado también puede utilizarse para detectar anomalías o comportamientos poco frecuentes. Si un sistema aprende cuál es la estructura habitual de un conjunto de datos, puede señalar casos que se apartan significativamente de ella. Esta estrategia resulta útil en ámbitos como mantenimiento industrial, análisis de redes, control de calidad o investigación científica. Sin embargo, una anomalía estadística no equivale necesariamente a un error, un fraude o un acontecimiento importante. Puede tratarse simplemente de un caso poco común. El algoritmo identifica una diferencia respecto al patrón general, mientras que la interpretación de esa diferencia requiere conocimiento del contexto. Esta distinción es esencial porque muestra que descubrir regularidades y comprender su significado son tareas relacionadas, pero no idénticas.
La ausencia de etiquetas ofrece una ventaja evidente: permite trabajar con enormes cantidades de información que nunca han sido clasificadas manualmente. Etiquetar datos puede ser lento y costoso, mientras que fotografías, textos, registros o señales se generan continuamente sin ninguna anotación. Pero esa libertad introduce una dificultad fundamental: evaluar qué ha aprendido el sistema puede resultar menos directo. En aprendizaje supervisado existe una respuesta conocida con la que comparar el resultado; aquí no siempre hay una referencia externa equivalente. Los investigadores deben analizar si las estructuras encontradas son estables, útiles para una tarea posterior o coherentes con el fenómeno estudiado. Además, distintos algoritmos pueden descubrir organizaciones diferentes dentro de los mismos datos, porque cada método introduce sus propias suposiciones acerca de qué relaciones son importantes.
El aprendizaje no supervisado amplió así la idea de que una máquina puede aprender sin recibir una solución explícita para cada ejemplo. Su interés reside en explorar información, encontrar patrones y construir representaciones que pueden servir después para tareas más concretas. En la práctica contemporánea, las fronteras entre aprendizaje supervisado y no supervisado no siempre son rígidas, y existen enfoques intermedios o relacionados que aprovechan grandes cantidades de datos con distintos grados de señal de entrenamiento. Pero la distinción sigue siendo útil para comprender dos maneras fundamentales de aprender: una guiada por respuestas conocidas y otra orientada a descubrir estructura dentro de los propios datos. Existe todavía una tercera estrategia clásica, diferente de ambas: permitir que un sistema aprenda actuando en un entorno y recibiendo consecuencias por sus decisiones. Ese será el terreno del aprendizaje por refuerzo.
7.5. Aprendizaje por refuerzo
El aprendizaje por refuerzo introduce una situación diferente a las anteriores: el sistema no recibe simplemente ejemplos ya resueltos ni se limita a buscar estructuras dentro de un conjunto de datos, sino que aprende actuando en un entorno. Un agente observa una situación, elige una acción y recibe alguna consecuencia que puede expresarse mediante una recompensa positiva, una penalización o una señal equivalente. A partir de esa experiencia intenta descubrir qué decisiones aumentan la recompensa acumulada a lo largo del tiempo. La idea recuerda, de manera limitada, ciertos procesos de ensayo y error: una conducta que conduce a buenos resultados tiende a reforzarse, mientras que otra que produce consecuencias desfavorables pierde atractivo. Sin embargo, se trata de un procedimiento matemático y computacional, no de una reproducción completa del aprendizaje animal o humano.
La dificultad principal aparece porque una decisión no siempre puede evaluarse inmediatamente. En muchos problemas, una acción que parece poco beneficiosa en el momento puede resultar necesaria para alcanzar un resultado mejor más adelante. En una partida de ajedrez, por ejemplo, sacrificar una pieza puede formar parte de una estrategia ganadora; en navegación, un desvío inicial puede conducir después a una ruta más eficiente; en control robótico, una secuencia de movimientos debe valorarse por su resultado conjunto. El agente necesita aprender, por tanto, no solo qué acciones producen recompensas inmediatas, sino cuáles contribuyen a objetivos futuros. Esta dimensión temporal convierte el aprendizaje por refuerzo en un problema de decisión secuencial, donde cada elección modifica las situaciones que podrán encontrarse posteriormente.
Otro desafío fundamental es el equilibrio entre exploración y explotación. Si el agente utiliza siempre la acción que hasta ese momento parece mejor, puede dejar de descubrir alternativas más eficaces. Pero si explora constantemente opciones nuevas, puede desaprovechar lo que ya ha aprendido y obtener resultados pobres. El sistema debe combinar ambas conductas: aprovechar estrategias conocidas cuando parecen adecuadas y, al mismo tiempo, reservar cierta capacidad para probar posibilidades distintas. Este dilema aparece en numerosas situaciones donde las consecuencias de una decisión solo pueden conocerse actuando. La exploración permite reunir nueva información sobre el entorno; la explotación utiliza la experiencia acumulada. Encontrar un equilibrio adecuado entre ambas es una de las cuestiones centrales del aprendizaje por refuerzo.
Para aprender, el agente puede construir estimaciones sobre el valor de determinados estados, acciones o secuencias de comportamiento. De manera simplificada, intenta responder a preguntas como: «si me encuentro en esta situación, ¿qué acción parece conducirme a mejores resultados a largo plazo?». La respuesta se actualiza a medida que acumula experiencia. Algunos métodos aprenden directamente el valor asociado a distintas decisiones; otros desarrollan una política, es decir, una estrategia que indica cómo actuar en cada situación. Existen también enfoques capaces de aprender modelos del entorno o de combinar varias de estas ideas. La diversidad técnica es grande, pero todos comparten una característica esencial: el conocimiento útil surge de la interacción repetida entre agente, acciones, consecuencias y objetivos.
El aprendizaje por refuerzo ha resultado especialmente atractivo en juegos, robótica, control automático y otros problemas donde es posible definir con claridad una meta y permitir muchas interacciones. Los éxitos obtenidos en juegos como ajedrez, Go o videojuegos mostraron hasta qué punto un sistema puede desarrollar estrategias complejas cuando dispone de suficientes oportunidades para experimentar y de una señal de recompensa adecuada. Pero estos resultados no significan que el método pueda trasladarse sin dificultad a cualquier situación real. Entrenar mediante interacción puede resultar costoso, lento o incluso peligroso cuando los errores tienen consecuencias físicas. Además, definir una recompensa correcta es difícil: si el objetivo está mal formulado, el agente puede encontrar estrategias que maximizan la señal matemática sin cumplir realmente la intención humana que había detrás.
El aprendizaje por refuerzo revela con especial claridad que enseñar a una máquina significa diseñar cuidadosamente la relación entre experiencia y objetivo. El agente no sabe por sí mismo qué conducta es «buena» en un sentido general; aprende aquello que el sistema de recompensas y el entorno favorecen. Esta dependencia obliga a considerar cómo se evalúan las acciones, qué experiencias se permiten y hasta qué punto el comportamiento aprendido funciona fuera de las situaciones utilizadas durante el entrenamiento. Las tres grandes familias descritas —supervisado, no supervisado y por refuerzo— muestran distintas formas de extraer regularidades de la experiencia, pero todas necesitan comprobar que el aprendizaje obtenido es válido. Para ello será necesario separar cuidadosamente las fases y los datos empleados en el desarrollo del modelo: entrenamiento, validación y prueba.
7.6. Entrenamiento, validación y prueba
Construir un modelo de aprendizaje automático no termina cuando el sistema obtiene buenos resultados con los datos que ha utilizado para aprender. Precisamente ahí comienza una de las cuestiones más delicadas: comprobar si ese rendimiento refleja una capacidad realmente útil o simplemente una adaptación excesiva a los ejemplos conocidos. Para evitar esta confusión, el desarrollo de un modelo suele organizarse en varias etapas diferenciadas. Una parte de los datos se utiliza para entrenar, otra permite tomar decisiones durante el desarrollo y una última se reserva para evaluar el resultado final. Esta separación entre entrenamiento, validación y prueba constituye una de las bases metodológicas del aprendizaje automático, porque impide evaluar al sistema únicamente sobre la misma información que ha servido para construirlo.
El conjunto de entrenamiento es el material con el que el modelo modifica sus parámetros. Durante esta fase, el sistema procesa repetidamente los ejemplos y ajusta su comportamiento según el procedimiento de aprendizaje elegido. Cuantos más ciclos realiza, mayor oportunidad tiene de encontrar regularidades que reduzcan el error sobre esos datos. Pero ese progreso puede resultar engañoso. Un modelo suficientemente flexible puede llegar a adaptarse extraordinariamente bien al conjunto de entrenamiento sin haber descubierto relaciones que funcionen fuera de él. Por esa razón, observar únicamente cómo disminuye el error durante esta fase no permite saber todavía si el aprendizaje ha sido satisfactorio. La cuestión importante no es cuánto ha aprendido el modelo de los ejemplos disponibles, sino qué parte de ese aprendizaje podrá trasladar a situaciones nuevas.
La validación introduce una primera comprobación independiente. Se utiliza un conjunto de ejemplos que no participa directamente en el ajuste ordinario de los parámetros y que permite comparar diferentes decisiones tomadas durante la construcción del sistema. Puede servir, por ejemplo, para escoger entre modelos con distinta complejidad, decidir determinados valores de configuración o determinar cuándo conviene detener el entrenamiento. Estas decisiones afectan profundamente al resultado y, aunque no modifiquen necesariamente cada parámetro interno del modelo de forma directa, forman parte del proceso mediante el cual los investigadores seleccionan la versión que consideran más eficaz. La validación funciona así como una especie de banco de pruebas durante el desarrollo: permite experimentar sin recurrir continuamente a los datos que deberían reservarse para la evaluación final.
El conjunto de prueba desempeña precisamente esa última función. Debe permanecer apartado mientras se construye y ajusta el modelo, de modo que pueda ofrecer una estimación más imparcial de cómo responderá ante información desconocida. Si se consulta repetidamente el resultado de prueba y se modifican decisiones en función de él, ese conjunto deja de ser verdaderamente independiente: aunque sus ejemplos no hayan intervenido directamente en el entrenamiento, el proceso de desarrollo empieza a adaptarse indirectamente a ellos. Por eso, una evaluación rigurosa intenta preservar la prueba como una comprobación final. El principio es sencillo pero fundamental: no es posible medir honestamente la capacidad de enfrentarse a situaciones nuevas si esas mismas situaciones han influido una y otra vez en la construcción del sistema.
Esta división tampoco debe aplicarse de forma mecánica. Los tres conjuntos necesitan representar adecuadamente el fenómeno que se estudia y mantenerse separados de manera que no se produzcan filtraciones de información. Si fotografías casi idénticas aparecen en entrenamiento y prueba, si registros de una misma persona se distribuyen sin cuidado entre ambos conjuntos o si información futura se utiliza accidentalmente para predecir acontecimientos anteriores, el rendimiento puede parecer mucho mejor de lo que realmente es. En conjuntos pequeños pueden emplearse procedimientos como la validación cruzada, que repite el entrenamiento utilizando diferentes particiones de los datos para obtener estimaciones más estables. Lo esencial no es una proporción universal entre conjuntos, sino conservar la independencia necesaria para que cada fase responda a una pregunta distinta.
Entrenamiento, validación y prueba convierten así el aprendizaje automático en un proceso experimental y no simplemente en una operación de ajuste matemático. El entrenamiento pregunta si el modelo puede aprender de los ejemplos; la validación ayuda a decidir cómo construirlo; la prueba intenta determinar qué ocurre cuando se enfrenta finalmente a datos que no han condicionado esas decisiones. Esta disciplina metodológica permite descubrir una diferencia esencial entre aprender y memorizar, y prepara el terreno para evaluar uno de los objetivos fundamentales de cualquier modelo: la generalización. Un sistema verdaderamente útil no debe limitarse a reproducir correctamente aquello que ya conoce, sino conservar un rendimiento razonable cuando aparece lo inesperado. Esa capacidad, y los errores que pueden impedirla, conducen directamente al problema de la generalización y el sobreajuste.
7.7. Generalización, error y sobreajuste
El objetivo profundo de un sistema de aprendizaje automático no es reproducir correctamente los ejemplos que ya conoce, sino responder de manera adecuada ante situaciones nuevas. A esta capacidad se la denomina generalización. Un modelo puede haber observado miles de fotografías durante su entrenamiento, pero su utilidad depende de que sea capaz de clasificar correctamente otra fotografía tomada después, con una iluminación distinta, desde otro ángulo o con características que no coincidan exactamente con las anteriores. Aprender significa, en este sentido, extraer regularidades suficientemente estables como para utilizarlas más allá de los datos originales. La diferencia parece sencilla, pero constituye una de las cuestiones centrales de toda la disciplina: un modelo puede alcanzar resultados excelentes durante el entrenamiento y, sin embargo, haber aprendido algo demasiado ligado a ese conjunto particular de ejemplos.
El error permite medir hasta qué punto las predicciones del modelo se alejan del resultado deseado, aunque su significado depende de la tarea. En una clasificación puede observarse cuántos casos se asignan a una categoría incorrecta; en una estimación numérica puede medirse la distancia entre el valor predicho y el real. Lo importante es comparar el comportamiento sobre datos utilizados durante el aprendizaje con el obtenido sobre ejemplos independientes. Un error bajo en entrenamiento acompañado de un error considerablemente mayor fuera de ese conjunto indica que el modelo no está trasladando bien lo aprendido. La evaluación deja entonces de ser una simple cuestión de contar aciertos: sirve para investigar qué clase de regularidades ha capturado el sistema y si esas regularidades representan realmente el fenómeno que se pretendía aprender.
El sobreajuste, u overfitting, aparece cuando el modelo se adapta demasiado estrechamente a los datos de entrenamiento. En lugar de captar únicamente patrones generales, aprende también peculiaridades, ruido estadístico o coincidencias accidentales presentes en esos ejemplos. Imaginemos un clasificador de animales que, debido a la composición de su conjunto de entrenamiento, encuentra casi todos los caballos fotografiados sobre praderas y casi todas las vacas junto a determinadas construcciones. Un sistema suficientemente flexible podría utilizar elementos del fondo como atajos para distinguir las categorías. Mientras los datos futuros mantengan esas coincidencias, el modelo parecerá eficaz; cuando desaparezcan, sus errores aumentarán. Ha aprendido una asociación real dentro de sus datos, pero no necesariamente la relación que esperábamos que aprendiera.
Existe también el problema contrario: el subajuste. Un modelo puede ser demasiado simple para captar la estructura relevante de los datos y producir errores elevados incluso sobre los ejemplos utilizados para entrenarlo. Entre ambos extremos existe una tensión fundamental. Aumentar la flexibilidad permite representar relaciones más complejas, pero también facilita que el sistema se adapte a detalles accidentales; restringirla demasiado puede impedirle descubrir patrones auténticos. La solución no consiste simplemente en construir siempre el modelo más grande o el más preciso sobre el conjunto de entrenamiento. Se busca una complejidad adecuada al problema y a la cantidad de información disponible. Esta relación entre capacidad del modelo, calidad de los datos y rendimiento sobre casos desconocidos explica por qué mejorar una cifra durante el entrenamiento no equivale necesariamente a mejorar el sistema.
Existen numerosas estrategias para limitar el sobreajuste. Disponer de más ejemplos variados puede dificultar que el modelo dependa de coincidencias particulares, mientras que técnicas de regularización penalizan determinadas formas de complejidad y favorecen soluciones más contenidas. También puede detenerse el entrenamiento cuando el rendimiento sobre los datos de validación comienza a empeorar, o introducir variaciones razonables en los ejemplos para ampliar artificialmente su diversidad. Ninguna de estas técnicas garantiza por sí sola una buena generalización. Si los datos de entrenamiento representan mal el contexto donde se utilizará el sistema, incluso un modelo cuidadosamente regularizado puede fracasar. La pregunta decisiva sigue siendo si la experiencia empleada para aprender contiene suficiente información acerca del mundo al que después deberá enfrentarse.
Generalización, error y sobreajuste muestran así que aprender no consiste únicamente en reducir una función matemática hasta obtener una cifra pequeña. Lo verdaderamente difícil es separar las regularidades duraderas de las particularidades accidentales y construir un modelo que conserve su utilidad cuando cambian los ejemplos. Esta exigencia atraviesa prácticamente todo el aprendizaje automático y explica por qué los datos, el entrenamiento y la evaluación forman un único proceso. También prepara el siguiente gran capítulo de esta historia. A medida que los investigadores desarrollaron modelos con capacidades cada vez mayores, reapareció una antigua idea: construir sistemas inspirados de manera muy simplificada en redes de unidades conectadas capaces de ajustar sus relaciones mediante experiencia. Las redes neuronales llevarían los problemas de entrenamiento y generalización a una escala mucho mayor y acabarían abriendo el camino al aprendizaje profundo.
El aprendizaje automático abrió la posibilidad de construir sistemas cuyo comportamiento no quedara completamente fijado por reglas escritas de antemano. Las redes neuronales llevaron esa idea mucho más lejos al proponer arquitecturas formadas por numerosas unidades simples conectadas entre sí, capaces de transformar la información de manera gradual. Su inspiración histórica procede, de forma muy simplificada, del funcionamiento de las neuronas biológicas, pero una red neuronal artificial no es una reproducción del cerebro. Es una construcción matemática diseñada para recibir datos, combinar señales y ajustar sus conexiones durante el aprendizaje. Lo extraordinario no reside en cada unidad por separado, que realiza operaciones relativamente sencillas, sino en lo que puede surgir cuando miles, millones o incluso más parámetros actúan conjuntamente dentro de una estructura entrenable.
La unidad elemental de este enfoque es la neurona artificial. Recibe varios valores, concede distinta importancia a cada uno mediante pesos ajustables, combina esa información y produce una salida que puede transmitirse a otras unidades. Cuando estas neuronas se organizan en capas, la información atraviesa sucesivas transformaciones. Las primeras capas pueden responder a relaciones relativamente elementales, mientras que otras posteriores construyen representaciones progresivamente más complejas. En una tarea visual, por ejemplo, distintos niveles pueden terminar siendo sensibles a bordes, formas, texturas o configuraciones más elaboradas, aunque esas categorías no tengan que haber sido programadas explícitamente una por una. La capacidad de distribuir una representación entre muchas conexiones constituye una de las características decisivas de estas redes.
Pero disponer de una red no significa que esta sepa resolver una tarea. Sus numerosos parámetros deben ajustarse mediante entrenamiento. Una entrada atraviesa la red, produce un resultado y ese resultado se compara con algún objetivo o criterio de error. A partir de esa diferencia se calcula cómo conviene modificar las conexiones para mejorar la respuesta. Repetido innumerables veces sobre numerosos ejemplos, el proceso va configurando una estructura interna capaz de capturar regularidades difíciles de describir mediante reglas explícitas. Esta forma de aprendizaje plantea, sin embargo, nuevos desafíos: encontrar buenos parámetros en espacios enormes, evitar que el modelo se adapte excesivamente a los datos de entrenamiento y conseguir que las señales necesarias para aprender puedan transmitirse eficazmente a través de muchas capas.
Durante décadas, las redes neuronales alternaron periodos de entusiasmo y relativo abandono. Algunas ideas fundamentales aparecieron muy pronto, pero durante mucho tiempo su alcance estuvo limitado por algoritmos imperfectos, escasez de datos y capacidad de cálculo insuficiente. La situación comenzó a cambiar a medida que mejoraron los métodos de entrenamiento y fue posible construir redes con un número creciente de capas. De ahí surgió el aprendizaje profundo o deep learning, expresión utilizada para describir arquitecturas capaces de aprender representaciones jerárquicas mediante múltiples niveles de transformación. Su expansión no fue consecuencia de un único descubrimiento repentino, sino de la convergencia de décadas de investigación con unas condiciones tecnológicas que finalmente permitían aplicar esas ideas a una escala antes impracticable.
Dos factores resultaron especialmente importantes en esa transformación. El primero fue la disponibilidad de grandes conjuntos de datos digitales. Millones de imágenes, textos, sonidos y registros ofrecían a los modelos una cantidad de ejemplos muy superior a la que había sido posible reunir en etapas anteriores. El segundo fue el aumento radical de la capacidad de cálculo. Las unidades de procesamiento gráfico, o GPU, desarrolladas inicialmente para acelerar operaciones relacionadas con gráficos, resultaron extraordinariamente adecuadas para ejecutar en paralelo muchas de las operaciones matemáticas utilizadas por las redes neuronales. La combinación de datos abundantes, algoritmos más eficaces y hardware especializado permitió entrenar modelos cada vez mayores y convirtió el aprendizaje profundo en una herramienta decisiva para tareas que durante décadas habían resistido los enfoques anteriores.
Esa potencia no elimina los límites. Una red profunda puede descubrir relaciones extraordinariamente complejas y alcanzar un rendimiento impresionante, pero también puede necesitar enormes cantidades de datos y cálculo, aprender correlaciones equivocadas, comportarse de manera inesperada ante situaciones poco representadas o producir resultados difíciles de explicar internamente. Su éxito obliga, por tanto, a comprender tanto aquello que hace posible su capacidad como las condiciones bajo las que puede fallar. Este epígrafe recorrerá ese camino desde la neurona artificial y las conexiones que forman una red hasta el entrenamiento profundo, los grandes conjuntos de datos y la revolución computacional de las GPU. Al final aparecerá una idea esencial para comprender la siguiente etapa de la inteligencia artificial: cuando estas arquitecturas alcanzaron suficiente escala, las máquinas comenzaron a reconocer con una eficacia creciente imágenes, sonidos, voces y otros patrones complejos del mundo.
8.1. La neurona artificial
La neurona artificial nació de una pregunta tan sencilla en su formulación como ambiciosa en sus consecuencias: ¿es posible representar matemáticamente una unidad elemental capaz de recibir varias señales, combinarlas y producir una respuesta? En 1943, Warren McCulloch y Walter Pitts propusieron uno de los primeros modelos formales de neurona artificial. Su intención no era reproducir con fidelidad toda la complejidad de una célula nerviosa, sino mostrar que redes construidas con unidades extremadamente simplificadas podían realizar determinadas operaciones lógicas. Cada unidad recibía entradas, aplicaba una regla y generaba o no una salida según se alcanzara cierto umbral. Aquella abstracción estableció un puente intelectual entre neurociencia, lógica y computación: procesos formados por numerosos elementos conectados podían estudiarse mediante modelos matemáticos y utilizarse para realizar operaciones de tratamiento de información.
Una neurona artificial moderna conserva esa idea básica, aunque adopta formas mucho más flexibles. Recibe una serie de valores numéricos que representan características de los datos y asigna a cada uno un peso. Esos pesos expresan, de manera matemática, cuánto influye cada entrada en el resultado. La neurona combina después los valores ponderados, incorpora normalmente un término adicional denominado sesgo o bias y aplica una función que determina la salida. Si imaginamos un sistema sencillo encargado de decidir si determinadas condiciones favorecen una clasificación, unas entradas pueden contribuir positivamente, otras negativamente y algunas ejercer muy poca influencia. La neurona reúne todas esas señales en una única operación. Lo importante es que los pesos no tienen por qué establecerse manualmente de forma definitiva: pueden modificarse durante el entrenamiento hasta producir una combinación adecuada para la tarea.
La función de activación añade una transformación a esa combinación y permite que la unidad responda de formas distintas según el valor recibido. En los primeros modelos podían utilizarse reglas de umbral relativamente rígidas: por debajo de cierto valor la neurona permanecía inactiva y por encima producía una señal. Las redes posteriores incorporaron funciones de activación continuas y otras transformaciones matemáticas que permitieron construir sistemas mucho más flexibles. Esta característica puede parecer un detalle técnico, pero resulta fundamental. Si todas las unidades se limitaran a realizar únicamente combinaciones lineales, encadenar muchas de ellas seguiría produciendo, en esencia, una transformación lineal. La introducción de comportamientos no lineales permite representar relaciones mucho más complejas y constituye una de las claves que harán posible el desarrollo de redes capaces de enfrentarse a problemas difíciles.
Un paso histórico importante fue el perceptrón, desarrollado por Frank Rosenblatt durante la década de 1950. El perceptrón introdujo un mecanismo mediante el cual los pesos podían ajustarse a partir de ejemplos, vinculando de forma directa la neurona artificial con la idea de aprendizaje. Si la unidad clasificaba incorrectamente un ejemplo, sus pesos podían modificarse siguiendo una regla determinada para mejorar futuras respuestas. El modelo despertó un considerable interés porque sugería que una máquina podía aprender ciertas distinciones sin necesidad de recibir todas las reglas explícitamente. Sin embargo, un perceptrón individual tenía capacidades limitadas: podía resolver determinados problemas de clasificación cuando las categorías podían separarse de una forma relativamente sencilla, pero no representar cualquier relación imaginable. Aquella limitación mostraría que la verdadera potencia no estaba en una neurona aislada, sino en la organización de muchas unidades.
Conviene mantener cierta prudencia ante la palabra «neurona». Una neurona biológica es una célula extraordinariamente compleja que recibe señales electroquímicas, interactúa con miles de conexiones, modifica su comportamiento mediante múltiples mecanismos y forma parte de sistemas vivos cuyo funcionamiento todavía se investiga. La neurona artificial toma de esa realidad una inspiración muy general —entradas, influencia de las conexiones y producción de una salida—, pero reduce el proceso a operaciones matemáticas diseñadas con fines computacionales. Hablar de redes «neuronales» no significa, por tanto, que un ordenador contenga una copia digital del cerebro ni que sus unidades posean las propiedades de las células nerviosas. La analogía histórica es útil para comprender el origen de la idea, siempre que no se confunda una abstracción matemática con una reproducción biológica.
La aparente sencillez de una neurona artificial permite comprender uno de los rasgos más interesantes de las redes neuronales: capacidades complejas pueden surgir de la combinación de operaciones elementales repetidas a gran escala. Una sola unidad dispone de posibilidades muy modestas, pero cuando muchas de ellas intercambian señales y sus pesos se ajustan conjuntamente, el sistema puede construir transformaciones progresivamente más elaboradas de los datos. Ese salto desde la unidad elemental hacia una arquitectura organizada explica por qué la historia de las redes neuronales no puede entenderse observando únicamente cada neurona por separado. La siguiente cuestión es precisamente cómo se conectan esas unidades, cómo se distribuyen en diferentes niveles y dónde queda almacenada la información que el sistema adquiere durante el entrenamiento. Para comprenderlo hay que pasar de la neurona aislada a la estructura completa de capas, conexiones y parámetros.
Redes neuronales y aprendizaje profundo. La imagen sugiere la relación entre la neurona biológica y su traducción computacional: a partir de esa inspiración surgieron modelos capaces de aprender patrones, ajustar conexiones y procesar grandes cantidades de información. © GoldenDayz.
Las redes neuronales organizan unidades de procesamiento en capas capaces de aprender representaciones cada vez más complejas. Inspiradas de manera muy simplificada en la organización de las redes biológicas, las redes neuronales artificiales procesan información mediante numerosas unidades conectadas. El ajuste progresivo de sus parámetros permite reconocer patrones y resolver tareas complejas, especialmente cuando existen grandes conjuntos de datos y abundante capacidad de cálculo.
8.2. Capas, conexiones y parámetros
Una red neuronal adquiere verdadera capacidad cuando muchas unidades se organizan dentro de una arquitectura. En su forma más sencilla, esa arquitectura puede imaginarse como una sucesión de capas por las que circula la información. La primera recibe los datos de entrada; una o varias capas intermedias realizan transformaciones sucesivas; y una capa final produce la salida correspondiente a la tarea. En un sistema que clasifica imágenes, por ejemplo, la entrada puede contener valores asociados a los píxeles y la salida expresar la probabilidad de que aparezca una determinada categoría. Entre ambos extremos se sitúa la parte más importante del proceso: una cadena de transformaciones internas que permite convertir información inicialmente muy elemental en representaciones útiles para producir una respuesta.
Las capas intermedias suelen denominarse capas ocultas porque sus valores no proceden directamente del exterior ni constituyen la respuesta final. En ellas se construyen representaciones internas que pueden llegar a ser difíciles de interpretar de forma individual. Una unidad aislada rara vez corresponde de manera sencilla a un concepto humano reconocible; con frecuencia, la información está distribuida entre muchas activaciones y conexiones. A medida que los datos atraviesan sucesivas capas, determinadas relaciones pueden combinarse con otras y formar patrones progresivamente más elaborados. Esta organización jerárquica permite que una red transforme una entrada compleja mediante numerosos pasos pequeños. Cuantas más capas intervienen, mayor puede ser la profundidad de esa cadena de transformaciones, aunque añadir niveles no garantiza automáticamente un mejor resultado.
Las conexiones determinan cómo se transmite la información entre unas unidades y otras. Cada conexión suele estar asociada a un peso numérico que modifica la influencia de la señal que circula por ella. Un peso elevado puede aumentar la importancia de determinada entrada; uno pequeño puede reducirla, y un valor negativo puede invertir su contribución. Además de estos pesos, muchas unidades incorporan términos de sesgo que permiten desplazar su respuesta y dotar al modelo de mayor flexibilidad. El conjunto formado por pesos, sesgos y otros valores ajustables constituye los parámetros de la red. Estos parámetros son esenciales porque contienen gran parte de aquello que el sistema modifica durante el aprendizaje. Una arquitectura define la estructura general; los parámetros determinan la configuración concreta que adopta esa estructura después del entrenamiento.
El número de parámetros puede crecer con enorme rapidez. Si una capa contiene muchas unidades y cada una se conecta con numerosas unidades de la siguiente, aparecen miles o millones de pesos que deben almacenarse y utilizarse en cada cálculo. Las redes contemporáneas de gran escala pueden alcanzar cantidades muchísimo mayores. Esto ayuda a comprender por qué la potencia de una red no depende únicamente del número de neuronas, sino también de cómo están conectadas y de cuántos grados de libertad posee el sistema. Una red con pocos parámetros puede representar relaciones relativamente sencillas; otra mucho más grande puede modelar estructuras de gran complejidad. Pero una capacidad elevada implica también mayores necesidades de cálculo y aumenta el riesgo de ajustar patrones irrelevantes si los datos o el procedimiento de entrenamiento no son adecuados.
No todas las redes conectan sus unidades del mismo modo. En algunas arquitecturas, cada unidad de una capa se relaciona con todas las de la siguiente; en otras, las conexiones se restringen deliberadamente para aprovechar la estructura del problema. Las redes utilizadas en visión artificial, por ejemplo, pueden aplicar operaciones locales que permiten detectar relaciones espaciales sin conectar cada píxel con todas las unidades posteriores. Otras arquitecturas han sido diseñadas para trabajar con secuencias, señales temporales o diferentes tipos de información. Estas elecciones arquitectónicas introducen determinadas suposiciones sobre qué relaciones pueden resultar importantes y permiten utilizar los parámetros de forma más eficiente. La estructura de una red no es, por tanto, un recipiente neutro: condiciona qué transformaciones puede realizar y cómo circula la información a través del sistema.
Capas, conexiones y parámetros forman así una maquinaria matemática capaz de convertir datos de entrada en respuestas complejas mediante transformaciones sucesivas. La arquitectura proporciona el entramado; los parámetros configuran su comportamiento concreto, y las activaciones producidas en cada capa constituyen estados intermedios que permiten construir representaciones cada vez más útiles. Pero al crear una red aparece inmediatamente una cuestión decisiva: ¿qué valores deben tener todos esos parámetros? Resultaría imposible establecerlos manualmente cuando existen millones de conexiones y cuando la relación entre cada valor y el resultado final es difícil de anticipar. La respuesta está en hacer que la propia red los ajuste utilizando ejemplos y una medida del error. Comprender ese proceso permite pasar de la anatomía de una red neuronal a su dinámica fundamental: cómo aprende.
8.3. Cómo aprende una red neuronal
Una red neuronal comienza su entrenamiento sin conocer qué valores deberían tener sus numerosas conexiones. Los pesos suelen partir de valores iniciales que todavía no permiten resolver correctamente la tarea, de modo que las primeras respuestas pueden ser muy imprecisas. El aprendizaje consiste en modificar progresivamente esos parámetros hasta encontrar una configuración que produzca mejores resultados. Para ello, cada ejemplo atraviesa la red desde la entrada hasta la salida: las unidades de una capa reciben información, realizan sus operaciones y transmiten el resultado a la siguiente. Este recorrido, denominado propagación hacia delante, transforma sucesivamente los datos hasta obtener una predicción. La cuestión decisiva aparece entonces: la red necesita alguna forma de determinar cuánto se ha equivocado para saber en qué dirección conviene modificar sus parámetros.
Esa diferencia se expresa mediante una función de pérdida o función de coste, una medida matemática que compara la respuesta producida con el objetivo establecido. Si una red debe distinguir diferentes tipos de imágenes, por ejemplo, la función permite cuantificar hasta qué punto sus predicciones se alejan de las categorías correctas. Durante el entrenamiento no interesa únicamente saber si una respuesta ha sido acertada o equivocada, sino obtener una señal suficientemente informativa para guiar pequeñas correcciones. El objetivo consiste en reducir progresivamente esa pérdida a medida que se procesan numerosos ejemplos. La red no recibe una explicación humana de por qué ha fallado ni una nueva regla escrita por el programador; recibe una señal matemática que permite evaluar el resultado y utilizarlo para ajustar su estructura interna.
El problema es determinar qué parte de un error corresponde a cada uno de los numerosos parámetros de la red. En una arquitectura profunda, una salida final puede depender de una larga cadena de operaciones realizadas por muchas capas. Para resolver esta dificultad se utiliza la retropropagación del error, conocida habitualmente como backpropagation. Mediante las reglas del cálculo diferencial, el algoritmo determina cómo cambiaría la pérdida si cada parámetro se modificara ligeramente. La información obtenida en la salida se propaga matemáticamente hacia las capas anteriores, permitiendo calcular la contribución de cada peso al resultado. La retropropagación no constituye por sí sola todo el aprendizaje: proporciona los gradientes necesarios para saber hacia dónde conviene mover los parámetros. Es el mecanismo que hace posible repartir una señal global de error entre una enorme cantidad de conexiones individuales.
Una vez calculados esos gradientes entra en juego la optimización. Uno de sus principios fundamentales es el descenso por gradiente: modificar los parámetros en la dirección que tiende a disminuir la función de pérdida. Los cambios suelen realizarse mediante pasos pequeños, porque una corrección excesivamente grande podría sobrepasar configuraciones útiles o volver inestable el entrenamiento. La magnitud de esos pasos está relacionada con la llamada tasa de aprendizaje, uno de los valores que deben elegirse cuidadosamente. En la práctica existen numerosas variantes y optimizadores más sofisticados, pero comparten la misma idea general: observar cómo responde la función de pérdida a pequeñas modificaciones y utilizar esa información para recorrer un espacio de parámetros extraordinariamente grande en busca de configuraciones que funcionen mejor.
El proceso se repite una enorme cantidad de veces. Los ejemplos suelen organizarse en pequeños grupos o lotes, y cuando la red ha recorrido el conjunto de entrenamiento se habla habitualmente de una época. A lo largo de muchas iteraciones, determinadas conexiones aumentan su influencia, otras la reducen y las distintas capas van adquiriendo configuraciones útiles para transformar la información. No existe normalmente un instante en el que la red «comprenda» de repente qué contiene una imagen o qué relación existe entre dos variables. El comportamiento emerge gradualmente de innumerables ajustes numéricos. Además, disminuir el error de entrenamiento no garantiza que el modelo vaya a funcionar bien con datos nuevos, por lo que siguen siendo esenciales la validación, la regularización y el control del sobreajuste examinados anteriormente.
La importancia histórica de este procedimiento reside en que permite coordinar el aprendizaje de enormes cantidades de parámetros sin establecer manualmente la función de cada conexión. El programador diseña la arquitectura, selecciona los datos, determina el objetivo y configura el procedimiento de entrenamiento, pero buena parte de la representación interna surge durante el ajuste del modelo. Durante mucho tiempo, entrenar redes con muchas capas resultó difícil: podían aparecer problemas en la propagación de los gradientes, faltaban datos suficientes y la capacidad de cálculo era limitada. La situación comenzó a transformarse cuando nuevos métodos, arquitecturas mejor diseñadas y un entorno tecnológico mucho más favorable permitieron aumentar considerablemente la profundidad de las redes. De esa convergencia surgiría el aprendizaje profundo, una etapa que convertiría antiguas ideas sobre redes neuronales en uno de los motores principales de la inteligencia artificial moderna.
8.4. El desarrollo del aprendizaje profundo
El aprendizaje profundo no apareció de repente como una tecnología completamente nueva. Sus raíces se encuentran en décadas de investigación sobre redes neuronales que alternaron etapas de entusiasmo, dificultades técnicas y recuperación. Los primeros perceptrones mostraron que una máquina podía ajustar conexiones a partir de ejemplos, pero sus limitaciones contribuyeron a reducir el interés por estos enfoques durante una parte de las décadas de 1960 y 1970. La idea de utilizar varias capas seguía siendo atractiva porque permitía representar relaciones mucho más complejas que una sola unidad, aunque entrenarlas eficazmente resultaba difícil. El problema ya no consistía únicamente en imaginar arquitecturas con numerosos niveles, sino en encontrar procedimientos capaces de modificar coordinadamente las conexiones internas y conseguir que las capas iniciales recibieran una señal útil acerca de los errores cometidos al final de la red.
Un avance decisivo fue la consolidación de la retropropagación como método práctico para entrenar redes multicapa. El principio matemático tenía antecedentes anteriores, pero el trabajo publicado en 1986 por David Rumelhart, Geoffrey Hinton y Ronald Williams contribuyó de manera fundamental a popularizar su utilización dentro de las redes neuronales. La retropropagación permitía calcular cómo debía modificarse cada peso para reducir el error de la red, haciendo posible entrenar capas ocultas que no recibían directamente la respuesta correcta. A partir de entonces se desarrollaron arquitecturas capaces de aprender representaciones internas cada vez más interesantes. En visión, las redes convolucionales exploraron formas de aprovechar la estructura espacial de las imágenes; en el tratamiento de secuencias, las redes recurrentes buscaron conservar información procedente de pasos anteriores.
El progreso, sin embargo, seguía encontrando obstáculos importantes. Cuando las redes incorporaban numerosas capas, las señales utilizadas para modificar los primeros niveles podían hacerse extremadamente pequeñas o, en otros casos, crecer de manera inestable. El llamado problema del desvanecimiento del gradiente dificultaba que las partes más profundas de la red aprendieran con eficacia. También era fácil que modelos grandes se ajustaran demasiado a conjuntos de entrenamiento limitados. Diferentes innovaciones fueron reduciendo progresivamente estas dificultades. Las redes LSTM, desarrolladas por Sepp Hochreiter y Jürgen Schmidhuber en la década de 1990, ofrecieron una respuesta particularmente influyente a algunos problemas presentes en el aprendizaje de secuencias largas. Paralelamente, las redes convolucionales desarrolladas por Yann LeCun y otros investigadores demostraron que estos métodos podían utilizarse con éxito en tareas prácticas como el reconocimiento de caracteres manuscritos.
A comienzos del siglo XXI empezó a producirse una nueva convergencia. Mejoraron los algoritmos de optimización, aparecieron estrategias más eficaces para inicializar y regularizar redes y aumentó la disponibilidad de información digital. En 2006, varios trabajos encabezados por Geoffrey Hinton contribuyeron a reactivar el interés por arquitecturas con muchas capas y mostraron procedimientos capaces de entrenar modelos profundos de manera más eficaz. La expresión deep learning comenzó a consolidarse para describir métodos en los que la información atravesaba numerosos niveles de representación aprendida. La profundidad no debía entenderse simplemente como una acumulación arbitraria de capas: permitía realizar sucesivas transformaciones de los datos y construir características complejas a partir de otras más elementales.
El momento simbólico de esta nueva etapa llegó en 2012 con AlexNet, una red neuronal convolucional desarrollada por Alex Krizhevsky, Ilya Sutskever y Geoffrey Hinton que obtuvo una mejora espectacular en la competición de reconocimiento visual ImageNet. El resultado mostró de manera pública que una combinación de redes profundas, procedimientos de entrenamiento adecuados, grandes cantidades de ejemplos y elevada capacidad de cálculo podía superar ampliamente métodos que hasta entonces dominaban determinadas tareas de visión artificial. Después de aquel éxito, laboratorios académicos y empresas tecnológicas aumentaron rápidamente sus inversiones. Arquitecturas más profundas y eficientes comenzaron a aparecer con gran velocidad y el aprendizaje profundo se extendió desde el reconocimiento de imágenes hacia voz, lenguaje, traducción, sistemas de recomendación y numerosos campos científicos.
El desarrollo del aprendizaje profundo fue, por tanto, el resultado de una larga acumulación de ideas que finalmente encontraron condiciones adecuadas para funcionar a gran escala. La retropropagación, las nuevas arquitecturas y las mejoras matemáticas fueron indispensables, pero ninguna explica por sí sola el cambio. Las redes profundas necesitaban suficientes ejemplos para ajustar enormes cantidades de parámetros y una capacidad computacional capaz de realizar repetidamente las operaciones necesarias durante el entrenamiento. Cuando esos elementos coincidieron, métodos que durante décadas habían parecido prometedores pero limitados adquirieron una eficacia extraordinaria. Para entender por qué esta transformación pudo producirse en ese momento histórico es necesario examinar primero uno de sus combustibles fundamentales: la aparición de conjuntos de datos digitales de una dimensión que habría resultado impensable para las generaciones anteriores de investigadores.
8.5. Grandes conjuntos de datos
Las redes profundas poseen una enorme capacidad para ajustar sus parámetros, pero esa misma flexibilidad exige experiencia suficiente para que el modelo encuentre regularidades útiles. Durante las primeras décadas de la inteligencia artificial, obtener grandes cantidades de ejemplos era difícil: la información debía recopilarse, digitalizarse y, en muchas ocasiones, etiquetarse manualmente. La expansión de los ordenadores personales, las cámaras digitales, los teléfonos móviles, los sensores y especialmente Internet modificó radicalmente esta situación. Textos, imágenes, sonidos y registros comenzaron a producirse y almacenarse a una escala creciente. Por primera vez, los investigadores podían disponer de colecciones suficientemente amplias como para entrenar modelos que contenían cantidades enormes de parámetros sin depender únicamente de pequeños conjuntos preparados artesanalmente.
Los conjuntos de referencia desempeñaron un papel decisivo porque permitieron comparar métodos bajo condiciones comunes. MNIST, creado a finales de la década de 1990 a partir de imágenes de dígitos manuscritos, se convirtió en uno de los bancos de pruebas clásicos para algoritmos de reconocimiento. Su tamaño resultaba modesto frente a los estándares posteriores, pero proporcionaba decenas de miles de ejemplos uniformemente organizados. Con el tiempo aparecieron colecciones mucho mayores y más variadas. ImageNet, iniciado en 2009 bajo la dirección de Fei-Fei Li y su equipo, reunió millones de fotografías asociadas a miles de categorías. Su escala permitió evaluar sistemas de visión en un entorno mucho más exigente y proporcionó el escenario en el que las redes profundas demostrarían, pocos años después, una ventaja decisiva.
Construir un gran conjunto de datos implica mucho más que acumular archivos. Los ejemplos deben organizarse, depurarse y, cuando el aprendizaje lo requiere, recibir etiquetas suficientemente fiables. En proyectos con millones de imágenes, realizar esa tarea exclusivamente mediante pequeños equipos de especialistas sería extraordinariamente lento. Plataformas de trabajo distribuido permitieron repartir parte del etiquetado entre grandes grupos de personas, haciendo posible la creación de colecciones de dimensiones antes inviables. Pero el proceso introduce nuevas preguntas: dos personas pueden interpretar una imagen de forma diferente, determinadas categorías pueden resultar ambiguas y los errores de clasificación pueden propagarse al entrenamiento. La cantidad comienza entonces a depender de una infraestructura humana y técnica encargada de convertir información dispersa en ejemplos que una máquina pueda utilizar.
La diversidad de los datos resulta tan importante como su volumen. Un millón de ejemplos muy parecidos entre sí puede enseñar menos que una colección menor pero mejor distribuida. Si determinados objetos, contextos, acentos, condiciones de iluminación o formas de expresión aparecen escasamente representados, el modelo tenderá a conocerlos peor. Los conjuntos de datos tampoco son fotografías neutrales del mundo: reflejan decisiones acerca de qué se recopila, cómo se clasifica y qué información se descarta. Un sistema puede aprender relaciones presentes en la colección aunque estas dependan de circunstancias históricas o de sesgos en el proceso de selección. Por eso, aumentar la escala no elimina los problemas de representación; en algunos casos puede amplificar patrones defectuosos si estos aparecen sistemáticamente en los datos.
La expansión de los conjuntos disponibles modificó también la manera de diseñar los sistemas. En etapas anteriores, los investigadores dedicaban un gran esfuerzo a identificar manualmente qué características podían resultar relevantes para una tarea. Con las redes profundas, comenzó a ser posible proporcionar información relativamente poco procesada y permitir que el propio entrenamiento desarrollara representaciones internas útiles. Este cambio funcionaba especialmente bien cuando existían suficientes ejemplos para mostrar al modelo una amplia variedad de situaciones. La relación entre datos y arquitectura se hizo así cada vez más estrecha: modelos de mayor capacidad podían aprovechar colecciones más grandes, mientras que esas colecciones justificaban el desarrollo de redes capaces de capturar regularidades cada vez más complejas. El crecimiento de ambos elementos empezó a reforzarse mutuamente.
Los grandes conjuntos de datos se convirtieron de este modo en una infraestructura esencial del aprendizaje profundo. Permitieron entrenar, comparar y mejorar modelos con una amplitud que había sido imposible durante gran parte de la historia de la inteligencia artificial. Pero almacenar millones de ejemplos no garantiza que puedan utilizarse eficazmente: cada uno debe atravesar repetidamente una red durante el entrenamiento y generar enormes cantidades de operaciones matemáticas. Cuando los conjuntos crecieron y las arquitecturas incorporaron más parámetros, el coste computacional pasó a convertirse en un obstáculo central. La siguiente transformación no procedería únicamente de mejores algoritmos ni de disponer de más información, sino de utilizar un tipo de hardware especialmente adecuado para realizar muchas operaciones simultáneamente. Las GPU proporcionarían precisamente esa capacidad y permitirían llevar el entrenamiento de redes profundas a una escala completamente nueva.
8.6. GPU y aumento de la capacidad de cálculo
El crecimiento de las redes neuronales profundas habría sido mucho más lento sin un cambio paralelo en el hardware. Durante décadas, la mayor parte de los cálculos científicos se realizaron sobre unidades centrales de procesamiento, o CPU, diseñadas para ejecutar una gran variedad de instrucciones de forma flexible y eficiente. Este diseño resulta excelente para numerosas tareas, pero el entrenamiento de redes neuronales exige repetir enormes cantidades de operaciones matemáticas muy similares sobre matrices y vectores. A medida que aumentaban el número de capas, los parámetros y los ejemplos de entrenamiento, ese trabajo comenzaba a superar con facilidad lo que podía realizarse en tiempos razonables con procesadores convencionales. La necesidad ya no era únicamente disponer de ordenadores «más rápidos», sino de arquitecturas capaces de efectuar muchas operaciones al mismo tiempo.
Las unidades de procesamiento gráfico, o GPU, habían sido desarrolladas originalmente para acelerar la generación de imágenes en videojuegos y aplicaciones gráficas. Renderizar una escena requiere realizar operaciones semejantes sobre grandes cantidades de píxeles, vértices y fragmentos, lo que favoreció la construcción de procesadores con numerosos núcleos capaces de trabajar en paralelo. Esa característica resultó extraordinariamente útil para el aprendizaje profundo. Muchas de las operaciones fundamentales de una red neuronal —multiplicaciones de matrices, sumas, transformaciones elementales y cálculo de gradientes— pueden dividirse en miles de pequeñas tareas que se ejecutan simultáneamente. Una GPU no sustituye simplemente a una CPU más lenta: organiza el cálculo de otra manera y sacrifica parte de la flexibilidad de propósito general a cambio de una enorme capacidad para realizar operaciones paralelas.
El paso decisivo se produjo cuando las GPU dejaron de utilizarse exclusivamente para gráficos y comenzaron a programarse como herramientas de cálculo general. Durante la década de 2000 se desarrollaron entornos que permitían a científicos e ingenieros utilizar directamente su capacidad paralela para tareas numéricas. La aparición de plataformas como CUDA, presentada por NVIDIA en 2006, facilitó considerablemente este proceso. Los investigadores en redes neuronales pudieron trasladar a las GPU operaciones que antes requerían largos tiempos de procesamiento en CPU. Entrenamientos que podían prolongarse durante semanas comenzaron en algunos casos a completarse en días o incluso horas, lo que no solo aceleraba un experimento concreto, sino que permitía probar más arquitecturas, modificar parámetros y repetir procesos de entrenamiento con una frecuencia antes imposible.
Esta aceleración tuvo consecuencias científicas profundas. Cuando experimentar resulta extremadamente caro en tiempo de cálculo, los investigadores deben limitar el número de hipótesis que pueden comprobar. Con hardware más rápido, se vuelve posible comparar redes mayores, modificar su profundidad, ensayar diferentes configuraciones y utilizar conjuntos de datos mucho más amplios. El aumento de capacidad computacional transformó así el ritmo de investigación. El éxito de AlexNet en 2012 estuvo estrechamente relacionado con el uso de GPU para entrenar una red convolucional de gran tamaño sobre ImageNet. Aquel resultado no demostró únicamente la calidad de una arquitectura concreta; mostró que ideas conocidas podían adquirir una eficacia muy superior cuando se combinaban con suficiente información y con hardware capaz de realizar el volumen de cálculo necesario.
La evolución no se detuvo en las GPU. El crecimiento de la inteligencia artificial impulsó el desarrollo de aceleradores especializados, unidades diseñadas específicamente para ejecutar operaciones habituales en redes neuronales y otros modelos de aprendizaje automático. Las grandes infraestructuras de entrenamiento comenzaron además a distribuir el trabajo entre múltiples procesadores, servidores y centros de datos. El cálculo dejó de depender de una única máquina y pasó a organizarse a escala masiva. Esta tendencia permitió entrenar modelos con cantidades de parámetros y datos cada vez mayores, pero también incrementó el coste económico y energético de los sistemas más ambiciosos. La potencia computacional se convirtió en un recurso estratégico: disponer de mejores algoritmos seguía siendo esencial, pero la capacidad para ejecutarlos a gran escala empezó a influir directamente en qué investigaciones podían realizarse.
Las GPU muestran hasta qué punto el desarrollo de la inteligencia artificial depende de la interacción entre ideas matemáticas y posibilidades materiales. Una arquitectura puede existir sobre el papel durante años y adquirir una importancia completamente distinta cuando aparece el hardware capaz de entrenarla eficazmente. El aprendizaje profundo prosperó porque coincidieron mejores métodos, grandes conjuntos de datos y una expansión extraordinaria de la capacidad de cálculo. Esa combinación permitió alcanzar resultados antes impensables en visión, voz y otras tareas complejas, pero también abrió nuevas preguntas sobre eficiencia, consumo de recursos, accesibilidad y dependencia de infraestructuras cada vez mayores. La potencia de las redes profundas no puede entenderse separada de esta revolución computacional; tampoco pueden entenderse sus límites sin considerar qué ocurre cuando aumentar el tamaño y el cálculo deja de traducirse automáticamente en una mejora equivalente del rendimiento.
8.7. Potencia y límites de las redes profundas
Las redes profundas demostraron que una arquitectura formada por muchas capas podía aprender representaciones extraordinariamente complejas a partir de grandes cantidades de datos. Su capacidad para reconocer regularidades en imágenes, sonidos, textos y otras señales transformó numerosos campos de la inteligencia artificial. Parte de su potencia procede de que no necesitan recibir todas las características relevantes definidas manualmente. Durante el entrenamiento, diferentes niveles de la red pueden especializarse en detectar relaciones cada vez más elaboradas, construyendo representaciones internas que resultan útiles para la tarea. Esta propiedad permitió superar enfoques anteriores en problemas donde era muy difícil establecer reglas explícitas. El avance fue real y profundo: tareas que durante décadas habían resistido métodos tradicionales comenzaron a resolverse con una precisión suficiente para convertirse en tecnologías prácticas.
Esa potencia, sin embargo, no equivale a una comprensión general del mundo. Una red puede aprender asociaciones extremadamente sofisticadas sin disponer de una representación explícita de por qué esas asociaciones funcionan. En numerosas ocasiones, su éxito depende de regularidades estadísticas presentes en los datos y no de conceptos formulados de la misma manera que los utilizaría una persona. Esto explica por qué sistemas capaces de alcanzar resultados excepcionales pueden cometer errores que resultan extraños desde una perspectiva humana. Una pequeña modificación de una imagen, un cambio poco habitual en el contexto o una situación escasamente representada durante el entrenamiento pueden alterar la respuesta de forma inesperada. La competencia observada dentro de un dominio concreto no debe confundirse, por tanto, con una inteligencia uniforme aplicable a cualquier circunstancia.
Otro límite importante está relacionado con la interpretabilidad. En un sistema basado en pocas reglas explícitas, puede resultar relativamente sencillo seguir el camino que conduce desde una entrada hasta una conclusión. En una red profunda, la decisión puede depender de millones de parámetros distribuidos entre muchas capas. Es posible analizar activaciones, estudiar la importancia de ciertas características y desarrollar métodos de explicación, pero reconstruir de manera completa por qué una red produjo exactamente una respuesta determinada puede ser muy difícil. Esta opacidad adquiere especial importancia cuando los modelos intervienen en ámbitos donde las decisiones deben justificarse. Una elevada precisión estadística no resuelve automáticamente la necesidad de comprender qué información ha utilizado el sistema ni si esa información constituye una base adecuada para la decisión.
Las redes profundas también heredan las limitaciones de los datos con los que se entrenan. Si los ejemplos contienen errores, desequilibrios o asociaciones poco representativas, el modelo puede incorporarlos a su comportamiento. Un conjunto enorme no es necesariamente un conjunto completo ni neutral. La red puede aprender atajos inesperados: detalles del fondo de una fotografía, determinadas palabras asociadas accidentalmente a una categoría o correlaciones históricas que no deberían interpretarse como relaciones universales. Cuando el entorno real cambia respecto al conjunto de entrenamiento, el rendimiento puede deteriorarse. Esta sensibilidad muestra que la capacidad de aprendizaje no elimina la necesidad de seleccionar, revisar y evaluar cuidadosamente la información. Cuanto mayor es el modelo, más importante resulta comprender qué clase de experiencia se le ha proporcionado.
La escala introduce además costes materiales. Entrenar grandes redes puede requerir enormes cantidades de cálculo, hardware especializado, almacenamiento y energía. El crecimiento del número de parámetros no puede continuar indefinidamente sin consecuencias económicas y técnicas. Aumentar la escala suele mejorar determinados resultados, pero los beneficios no siempre crecen al mismo ritmo que los recursos utilizados. También existe una concentración tecnológica: los modelos más grandes pueden necesitar infraestructuras que solo están al alcance de universidades muy bien financiadas, grandes empresas o centros de investigación con acceso a aceleradores especializados. Esta situación ha impulsado el interés por redes más eficientes, técnicas de compresión, arquitecturas especializadas y métodos capaces de obtener mejores resultados utilizando menos datos y menor capacidad de cálculo.
La historia de las redes profundas muestra así una combinación de extraordinaria capacidad y limitaciones igualmente importantes. Su éxito no consiste en haber resuelto el problema general de la inteligencia, sino en haber creado una forma extremadamente eficaz de aprender representaciones complejas a partir de datos. Cuando se combinan buena arquitectura, entrenamiento adecuado, información abundante y suficiente potencia de cálculo, pueden realizar tareas que durante décadas parecieron fuera del alcance de las máquinas. Pero sus errores, dependencia de los datos, dificultad de interpretación y coste computacional recuerdan que ninguna técnica constituye por sí sola una solución universal. Precisamente dentro de esos límites aparecerían algunos de los resultados más visibles de la inteligencia artificial moderna: máquinas capaces de identificar objetos, reconocer rostros, transcribir voces, traducir idiomas y recomendar contenidos, aplicaciones en las que el aprendizaje profundo comenzaría a formar parte silenciosa de la vida cotidiana.
Durante gran parte de la historia de la informática, la relación entre persona y máquina estuvo dominada por información preparada expresamente para ser procesada: números introducidos en formularios, instrucciones codificadas, bases de datos organizadas o comandos escritos siguiendo reglas precisas. La inteligencia artificial comenzó a alterar esa relación cuando los sistemas adquirieron capacidad para trabajar directamente con señales mucho más próximas a nuestra experiencia cotidiana. Una fotografía dejó de ser únicamente una matriz de valores; una grabación pudo convertirse en palabras; una frase escrita en un idioma empezó a transformarse automáticamente en otra lengua. Las máquinas no comenzaron a ver u oír en el sentido biológico, pero sí a extraer de imágenes, sonidos y comportamientos regularidades suficientes para reconocer elementos significativos y responder ante ellos.
La visión artificial constituye uno de los ejemplos más claros de esa transformación. Una cámara puede registrar luz sin comprender qué representa la escena; el problema computacional consiste precisamente en convertir esa información visual en estructuras que permitan distinguir objetos, posiciones, movimientos o relaciones espaciales. Reconocer que algo aparece en una imagen es diferente de localizar dónde se encuentra, separar varios objetos o seguirlos mientras se desplazan. Bajo la expresión general de visión artificial conviven por ello numerosas tareas que intentan extraer significado operativo de datos visuales. El reconocimiento de imágenes y objetos mostrará cómo esa capacidad comenzó a utilizarse en ámbitos muy distintos, desde la organización automática de fotografías hasta el análisis científico, industrial o técnico.
Dentro de este campo, el reconocimiento facial constituye un caso especialmente revelador porque introduce una diferencia fundamental entre reconocer qué hay en una imagen e intentar determinar quién aparece en ella. Detectar un rostro, comparar determinados rasgos y establecer una posible correspondencia son operaciones diferentes que pueden combinarse dentro de un mismo sistema. Su desarrollo demuestra la precisión que pueden alcanzar algunos métodos de reconocimiento, pero también permite observar con especial claridad la importancia de la calidad de los datos, de las condiciones en las que se realiza la identificación y del propósito concreto de la aplicación. Más que tratar aquí sus implicaciones sociales en profundidad, interesa comprenderlo como una especialización tecnológica de la visión artificial en la que la identidad se convierte en la información buscada.
El sonido planteó otro desafío. Una grabación de voz contiene variaciones de intensidad, frecuencia, ritmo, pronunciación y ruido ambiental que deben convertirse en unidades lingüísticas antes de obtener una transcripción. Durante décadas, conseguir que una máquina reconociera habla continua resultó extraordinariamente difícil, especialmente cuando cambiaban el hablante, el acento o las condiciones acústicas. Los progresos en modelos estadísticos y posteriormente en aprendizaje profundo permitieron mejorar de manera sustancial esta capacidad. Una vez transformada la voz en lenguaje procesable aparece otra frontera histórica: pasar de unas palabras a otras conservando, en la medida de lo posible, su significado. La traducción automática recorrería su propio camino desde sistemas construidos con reglas y diccionarios hasta métodos capaces de aprender correspondencias a partir de grandes colecciones lingüísticas.
No todas las máquinas que «reconocen» trabajan con imágenes o sonidos. Algunas intentan reconocer patrones en nuestras elecciones. Los sistemas de recomendación utilizan información sobre productos, contenidos, relaciones entre usuarios y comportamientos anteriores para estimar qué puede resultar relevante en una situación determinada. Su presencia se ha extendido silenciosamente por plataformas audiovisuales, comercio electrónico, buscadores, redes sociales y servicios digitales. En estos casos, la inteligencia artificial no necesita identificar un objeto físico: debe descubrir relaciones entre enormes cantidades de opciones y señales de preferencia. Esa capacidad muestra otra dimensión del reconocimiento automático, menos evidente que una cámara que identifica una imagen pero profundamente integrada en la forma en que encontramos información dentro de entornos digitales cada vez más extensos.
Visión, reconocimiento de objetos y rostros, transcripción de voz, traducción y recomendación forman parte de una transformación más amplia: muchas de las aplicaciones de inteligencia artificial dejaron de presentarse como experimentos extraordinarios y comenzaron a incorporarse a herramientas ordinarias. Un teléfono que organiza fotografías, un servicio que transcribe una grabación, una plataforma que propone contenidos o un sistema que mejora una búsqueda pueden utilizar técnicas de IA sin que el usuario perciba el proceso que existe detrás. Esta normalización resulta históricamente significativa: algunas capacidades que en otro momento habrían parecido ejemplos espectaculares de máquinas inteligentes terminan convirtiéndose en funciones discretas de productos cotidianos. Examinar estas tecnologías permitirá comprender cómo la inteligencia artificial empezó a abandonar el laboratorio para integrarse en nuestra experiencia diaria, antes de enfrentarse a una frontera todavía más compleja: el lenguaje.
9.1. Visión artificial
La visión artificial es el conjunto de técnicas que permite a un sistema informático extraer información útil de imágenes y secuencias de vídeo. Su objetivo no consiste simplemente en almacenar una fotografía o mostrarla en una pantalla, sino en analizar su contenido y convertirlo en información susceptible de ser interpretada por otros procesos. Una cámara registra intensidades luminosas transformadas en valores digitales; para una máquina, una imagen comienza siendo una enorme organización de números. La dificultad consiste en pasar de esa estructura numérica a categorías relevantes: distinguir formas, localizar elementos, separar unas regiones de otras, estimar movimiento o reconocer relaciones espaciales. La visión artificial intenta precisamente construir ese puente entre señal visual y representación computacional del entorno.
Los primeros sistemas dependían en gran medida de reglas diseñadas manualmente. Los investigadores buscaban bordes, contrastes, líneas, esquinas, contornos o determinadas configuraciones geométricas que pudieran utilizarse para describir objetos. Este enfoque podía funcionar bien en entornos controlados, como ciertas aplicaciones industriales, pero encontraba dificultades cuando aumentaba la variedad de las escenas. Un mismo objeto cambia de apariencia según la iluminación, la distancia, el ángulo, el fondo, la posición o la existencia de otros elementos que lo oculten parcialmente. Una taza vista de frente no produce los mismos píxeles que una taza observada desde arriba, aunque para una persona siga siendo inmediatamente reconocible. Traducir esa estabilidad perceptiva humana a reglas explícitas resultó mucho más difícil de lo que inicialmente parecía.
El aprendizaje automático modificó progresivamente esta situación al permitir que parte de las características visuales se obtuviera a partir de ejemplos. En lugar de establecer manualmente todas las propiedades que distinguen unas imágenes de otras, los modelos podían aprender relaciones estadísticas presentes en grandes colecciones visuales. Las redes convolucionales desempeñaron un papel especialmente importante porque fueron diseñadas para aprovechar la estructura espacial de las imágenes. Sus operaciones podían detectar patrones locales y reutilizar los mismos filtros en distintas zonas, reduciendo el número de parámetros necesarios respecto a conexiones completamente independientes. A medida que la información atravesaba varias capas, podían construirse representaciones cada vez más elaboradas, haciendo posible abordar tareas visuales de una complejidad que anteriormente requerían una intervención humana mucho mayor.
La visión artificial comprende además tareas distintas que conviene no confundir. Clasificar una imagen significa decidir a qué categoría pertenece el conjunto completo; detectar objetos implica localizar varios elementos y determinar qué son; la segmentación intenta asignar diferentes regiones o píxeles a objetos o clases concretas. Otros sistemas estiman profundidad, reconstruyen escenas tridimensionales, siguen elementos en movimiento o analizan cambios entre fotogramas de un vídeo. Estas capacidades pueden combinarse. Un vehículo automatizado, por ejemplo, puede necesitar distinguir señales, peatones, carriles y otros vehículos, además de estimar su posición y movimiento relativo. Una aplicación industrial puede limitarse a comprobar si una pieza presenta una forma incorrecta. La misma disciplina abarca, por tanto, desde análisis muy especializados hasta representaciones visuales complejas del entorno.
Sus aplicaciones se han extendido ampliamente. En medicina puede utilizarse como herramienta de apoyo para analizar determinadas imágenes diagnósticas; en astronomía ayuda a clasificar grandes colecciones de observaciones; en industria permite detectar defectos y automatizar controles de calidad; en agricultura puede contribuir al seguimiento de cultivos; y en cartografía facilita el análisis de imágenes aéreas y de satélite. Cámaras y sistemas visuales intervienen también en robótica, documentación científica, organización de archivos fotográficos y numerosas funciones incorporadas a dispositivos electrónicos. En todos estos casos, el valor del sistema depende de la tarea concreta y de las condiciones en las que ha sido entrenado y evaluado. Una alta precisión en un conjunto de pruebas no implica automáticamente que el modelo mantenga el mismo comportamiento en cualquier escenario.
La visión artificial muestra de forma especialmente clara tanto la potencia como las limitaciones del aprendizaje moderno. Los sistemas actuales pueden detectar estructuras visuales con una eficacia extraordinaria, pero siguen dependiendo de los datos, de la definición de la tarea y de las condiciones del entorno. Cambios de iluminación, imágenes degradadas, perspectivas inusuales o situaciones muy diferentes de las utilizadas durante el entrenamiento pueden reducir su fiabilidad. Tampoco existe una única operación denominada «ver» que reproduzca todo lo que realiza la percepción humana: reconocer, localizar, interpretar y relacionar visualmente son problemas diferentes. Comprender esta distinción permite analizar con mayor precisión uno de los usos más extendidos de la visión artificial: enseñar a una máquina a identificar qué aparece en una imagen y dónde se encuentra. Ese será el terreno específico del reconocimiento de imágenes y objetos.
9.2. Reconocimiento de imágenes y objetos
Reconocer una imagen supone transformar una enorme colección de valores numéricos en una descripción útil de aquello que aparece representado. Para una persona, distinguir un perro, una bicicleta o una señal de tráfico suele ser una operación inmediata; para un sistema informático, ninguno de esos objetos existe inicialmente como tal. Solo recibe píxeles organizados espacialmente, con determinados valores de color e intensidad. El reconocimiento de imágenes intenta establecer qué categoría describe mejor el contenido visual, mientras que el reconocimiento o detección de objetos añade una dificultad importante: debe determinar también dónde se encuentran uno o varios elementos dentro de la escena. Esta diferencia permite pasar de una respuesta global —«en esta fotografía aparece un automóvil»— a una interpretación espacial capaz de señalar cada automóvil y separarlo de otros elementos presentes.
Durante mucho tiempo, estas tareas dependieron de características diseñadas manualmente. Los algoritmos buscaban contornos, cambios de intensidad, formas geométricas, texturas u otros patrones definidos previamente por investigadores. Después, un clasificador utilizaba esas características para decidir qué objeto podía corresponder a la combinación observada. El procedimiento produjo resultados importantes, pero exigía seleccionar de antemano qué propiedades visuales podían resultar relevantes. La expansión del aprendizaje profundo modificó este esquema. Las redes neuronales convolucionales comenzaron a aprender directamente muchas de esas representaciones a partir de los propios ejemplos, construyendo sucesivos niveles de características. El sistema podía descubrir patrones útiles para la clasificación sin que un programador tuviera que describir de forma explícita todas las variantes posibles de cada objeto.
La detección plantea un problema más complejo que la clasificación porque una escena puede contener numerosos elementos de tamaños y posiciones diferentes. El sistema necesita identificar regiones candidatas, asignarles categorías y estimar su localización mediante coordenadas o delimitaciones equivalentes. Métodos posteriores hicieron posible realizar estas operaciones con creciente rapidez, incluso sobre secuencias de vídeo. Esto abrió aplicaciones en conducción asistida, robótica, vigilancia de procesos industriales, inventarios, análisis de imágenes aéreas y múltiples sistemas interactivos. En otros casos interesa una precisión todavía mayor: en lugar de dibujar simplemente un rectángulo alrededor de un objeto, la segmentación puede identificar qué píxeles pertenecen exactamente a él. Reconocer, localizar y delimitar son así diferentes niveles de análisis visual que pueden integrarse según las necesidades de la aplicación.
El aprendizaje de estos sistemas requiere colecciones de imágenes suficientemente variadas. Un objeto puede aparecer de frente o parcialmente oculto, ocupar casi toda la imagen o apenas unos pocos píxeles, estar iluminado por el sol o encontrarse en penumbra. Las variaciones de perspectiva, tamaño y contexto obligan al modelo a descubrir propiedades que permanezcan relativamente estables a través de situaciones diferentes. Los grandes bancos de imágenes etiquetadas fueron esenciales para conseguirlo. Durante el entrenamiento, la red encuentra innumerables ejemplos de una categoría y ajusta sus parámetros hasta poder distinguirla de otras. Pero los datos también pueden introducir atajos indeseados: si determinadas categorías aparecen repetidamente asociadas a fondos concretos, el sistema puede utilizar el contexto en lugar de las características que realmente interesan.
Por esta razón, un reconocimiento aparentemente correcto no implica necesariamente que la máquina haya identificado un objeto mediante los mismos indicios que utilizaría una persona. Los modelos pueden aprovechar correlaciones visuales difíciles de percibir para nosotros y fallar cuando esas relaciones desaparecen. Objetos parcialmente ocultos, imágenes desenfocadas, perspectivas inusuales o escenas muy alejadas de los datos de entrenamiento pueden producir errores inesperados. También existen ejemplos diseñados específicamente para alterar la respuesta de ciertos modelos mediante modificaciones visuales muy pequeñas. Estos fenómenos recuerdan que una categoría aprendida estadísticamente no equivale a una definición universal del objeto. El rendimiento debe estudiarse en las condiciones reales donde se utilizará el sistema y no únicamente mediante ejemplos cuidadosamente seleccionados.
A pesar de estas limitaciones, el reconocimiento de imágenes y objetos convirtió la percepción visual automática en una tecnología de uso general. Los sistemas pueden clasificar enormes archivos fotográficos, localizar estructuras en observaciones científicas, detectar componentes en líneas industriales o proporcionar información visual a máquinas que interactúan con el entorno. La misma base tecnológica permite además especializaciones mucho más concretas. Una de ellas consiste en tratar el rostro humano no simplemente como otro objeto que debe localizarse, sino como una configuración cuyas características pueden compararse para intentar reconocer identidades. Esa transición desde detectar «un rostro» hasta establecer si corresponde a una persona determinada introduce nuevos métodos y una exigencia de precisión especialmente delicada: el reconocimiento facial.
La infraestructura de cálculo de la inteligencia artificial. El desarrollo de la IA moderna depende de grandes cantidades de datos y de una enorme capacidad de procesamiento. El crecimiento del aprendizaje profundo no puede entenderse sin la expansión de los centros de datos, las GPU y otras formas de computación de alto rendimiento. El entrenamiento de modelos complejos exige procesar cantidades enormes de información mediante infraestructuras capaces de ejecutar millones de operaciones en paralelo. © dotshock / Envato Elements.
9.3. Reconocimiento facial
El reconocimiento facial es una especialización de la visión artificial orientada a analizar rostros humanos y compararlos entre sí. Conviene distinguir varias tareas que a menudo se confunden. Detectar un rostro significa localizarlo dentro de una imagen; verificar una identidad consiste en comprobar si un rostro coincide con una persona concreta; identificar implica buscar a qué individuo corresponde dentro de un conjunto de posibles candidatos. Estas operaciones pueden formar parte de un mismo sistema, pero no plantean exactamente el mismo problema. La primera pregunta es «¿hay aquí una cara?»; la segunda, «¿es esta persona quien dice ser?»; la tercera, «¿quién es esta persona entre todas las registradas?». A medida que se avanza de una tarea a otra, aumenta la importancia de la precisión y de las condiciones en las que se realiza la comparación.
Los primeros métodos intentaban describir un rostro mediante medidas geométricas relativamente explícitas: distancia entre los ojos, posición de la nariz, forma del contorno o relaciones entre determinados puntos característicos. Estos procedimientos podían funcionar en imágenes controladas, pero eran sensibles a cambios de iluminación, expresión, edad, orientación de la cabeza o calidad de la fotografía. El aprendizaje automático y, posteriormente, las redes profundas modificaron profundamente este enfoque. En lugar de depender únicamente de unas pocas medidas diseñadas manualmente, los modelos comenzaron a aprender representaciones numéricas complejas a partir de grandes colecciones de rostros. El objetivo ya no era conservar una fotografía completa, sino obtener una descripción matemática capaz de situar rostros semejantes cerca entre sí y separar aquellos que corresponden a personas diferentes.
Estas representaciones suelen expresarse mediante vectores o embeddings: conjuntos de números que resumen características visuales relevantes para la comparación. Cuando una imagen entra en el sistema, primero se localiza el rostro, se corrigen en cierta medida su orientación y escala y después una red neuronal genera esa representación. El reconocimiento puede realizarse comparando la distancia matemática entre el nuevo vector y otros almacenados previamente. Si la semejanza supera determinado umbral, el sistema puede considerar que existe una coincidencia. Este procedimiento permite realizar comparaciones muy rápidas incluso cuando hay grandes bases de datos. Pero el resultado no es una afirmación absoluta de identidad: es una estimación basada en una medida de similitud y en un criterio de decisión que debe establecerse de acuerdo con la aplicación.
La precisión depende de numerosos factores. Una cámara situada frontalmente y con buena iluminación proporciona información muy distinta de una imagen tomada a distancia, con movimiento o con el rostro parcialmente cubierto. El envejecimiento, las gafas, el maquillaje, el vello facial o los cambios de expresión también pueden alterar la apariencia. Los sistemas modernos han mejorado enormemente frente a muchas de estas variaciones, pero siguen cometiendo errores. En aplicaciones reales resulta especialmente importante distinguir entre falsos positivos —aceptar como coincidencia a personas diferentes— y falsos negativos —rechazar una coincidencia verdadera—. Reducir uno de esos errores puede aumentar el otro, por lo que el umbral utilizado debe adaptarse al contexto. Desbloquear un dispositivo personal y buscar una identidad entre millones de registros no plantean el mismo nivel de exigencia.
Los datos empleados para entrenar y evaluar estos sistemas son igualmente decisivos. Si determinados tipos de rostros, edades, condiciones de iluminación o características demográficas aparecen poco representados, el rendimiento puede variar entre grupos y situaciones. Por ello, una cifra global de precisión puede ocultar diferencias importantes. Además, el reconocimiento facial trabaja con información biométrica vinculada a la identidad de las personas, lo que exige especial cuidado en la obtención, almacenamiento y utilización de los datos. Estas cuestiones adquirirán una dimensión social y jurídica mucho más amplia al estudiar posteriormente los desafíos de la inteligencia artificial; aquí interesa subrayar una idea técnica fundamental: la fiabilidad de un sistema depende tanto de su arquitectura como de la calidad y representatividad de los ejemplos con los que ha aprendido.
El reconocimiento facial muestra hasta qué punto una máquina puede convertir una señal visual extremadamente variable en una representación útil para comparar identidades. Su evolución resume muchas de las transformaciones anteriores de la inteligencia artificial: paso de características manuales a representaciones aprendidas, aumento de los datos disponibles, redes profundas y capacidad computacional creciente. También recuerda que reconocer no significa necesariamente comprender y que una coincidencia matemática debe interpretarse dentro del contexto para el que fue diseñada. Con la visión artificial, las máquinas aprendieron a extraer patrones significativos de la luz convertida en datos; otro desafío histórico consistiría en hacer algo equivalente con el sonido. Transformar una voz continua, cambiante y llena de matices en palabras escritas abriría una nueva frontera para los sistemas de reconocimiento: la transcripción automática del habla.
9.4. Voz y transcripción automática
Transformar la voz humana en texto ha sido uno de los problemas clásicos de la inteligencia artificial porque el habla es una señal continua, variable y profundamente dependiente del contexto. Cuando una persona escucha una frase, separa con enorme facilidad unas palabras de otras, reconoce fonemas, interpreta acentos y compensa ruidos o pronunciaciones incompletas. Para una máquina, en cambio, el sonido llega como una secuencia de variaciones de presión convertidas en valores digitales. El primer desafío consiste en analizar esa señal y descubrir en ella patrones suficientemente estables como para relacionarlos con unidades lingüísticas. La transcripción automática intenta realizar precisamente ese paso: convertir una corriente acústica en una secuencia escrita que represente con la mayor fidelidad posible lo pronunciado.
Los primeros sistemas de reconocimiento de voz trabajaban con vocabularios muy limitados y condiciones cuidadosamente controladas. Podían reconocer palabras aisladas o comandos concretos pronunciados por usuarios entrenados para hablar de una manera determinada. A medida que aumentaba el vocabulario y se intentaba reconocer habla continua, aparecían nuevas dificultades. Las palabras no se pronuncian como bloques separados, sino que se enlazan entre sí; la velocidad cambia, los sonidos se reducen o se transforman y una misma expresión puede sonar de manera distinta según la persona. Durante décadas, los sistemas combinaron modelos acústicos, diccionarios de pronunciación y modelos estadísticos del lenguaje para estimar qué secuencia de palabras explicaba mejor la señal recibida. El reconocimiento era, en esencia, un problema probabilístico de interpretación.
El aprendizaje profundo produjo una mejora importante al permitir aprender representaciones acústicas más complejas directamente a partir de grandes colecciones de grabaciones y transcripciones. Las redes neuronales comenzaron a sustituir o integrar componentes que antes se diseñaban de forma separada y lograron modelar mejor la relación entre sonido y lenguaje. Con arquitecturas más avanzadas, algunos sistemas pudieron procesar fragmentos cada vez mayores de audio y utilizar el contexto para resolver ambigüedades. Una misma secuencia sonora puede corresponder a palabras diferentes, pero la frase completa proporciona pistas sobre cuál resulta más probable. El reconocimiento dejó así de depender únicamente de sonidos locales y empezó a beneficiarse de modelos capaces de considerar relaciones lingüísticas más amplias.
La transcripción automática exige también enfrentarse a condiciones reales: conversaciones con varios hablantes, ruido de fondo, reverberación, micrófonos de distinta calidad, acentos regionales o interrupciones. Un sistema puede funcionar de manera excelente en grabaciones limpias y perder precisión en una calle, una reunión o una llamada telefónica. Además, convertir sonido en palabras no resuelve por sí solo todo el problema. Es necesario determinar puntuación, separar intervenciones, reconocer nombres propios, números o términos técnicos y, en algunos casos, distinguir quién está hablando. La calidad de una transcripción depende por tanto de varios niveles de procesamiento que convierten una señal acústica inicial en un texto legible y estructurado.
Estas tecnologías han pasado de ser herramientas experimentales a integrarse en numerosos servicios cotidianos. Permiten generar subtítulos automáticos, dictar mensajes, transcribir reuniones, facilitar búsquedas dentro de grabaciones o mejorar interfaces para personas con dificultades de movilidad o audición. También constituyen una puerta de entrada para sistemas conversacionales, ya que una máquina puede transformar primero la voz en texto, procesar el contenido y después generar una respuesta. Sin embargo, la precisión sigue dependiendo del idioma, del acento, del contexto y de la calidad de la grabación. Una transcripción aparentemente fluida puede contener errores sutiles que alteren nombres, cifras o términos especializados, por lo que sigue siendo necesaria una evaluación cuidadosa en usos sensibles.
La historia de la transcripción automática muestra cómo una señal física puede convertirse progresivamente en lenguaje procesable por una máquina. Primero se capturan y analizan patrones acústicos; después se relacionan con unidades lingüísticas y finalmente se construye una secuencia de palabras coherente. Este proceso representa una transición importante entre percepción y lenguaje. Una vez que una máquina puede convertir voz en texto, aparece de forma natural otra pregunta: ¿puede transformar ese texto en otra lengua conservando su significado? La traducción automática afronta ese reto y muestra cómo la inteligencia artificial pasó de reconocer sonidos a modelar relaciones entre sistemas lingüísticos completos.
9.5. Traducción automática
La traducción automática intenta resolver un problema más complejo que sustituir palabras de un idioma por sus equivalentes en otro. Cada lengua organiza de manera distinta el vocabulario, la gramática, el orden de los elementos, las expresiones idiomáticas y numerosas formas de ambigüedad. Una misma palabra puede adquirir significados diferentes según el contexto, mientras que una frase perfectamente natural en un idioma puede resultar extraña si se traslada literalmente a otro. Para una máquina, traducir exige establecer relaciones entre estructuras lingüísticas completas y decidir entre varias interpretaciones posibles. Por esta razón, la traducción fue uno de los primeros grandes objetivos de la computación y, al mismo tiempo, una de las tareas que más claramente mostró las dificultades de tratar el lenguaje mediante reglas simples.
Los primeros sistemas se apoyaron principalmente en diccionarios y reglas lingüísticas diseñadas por especialistas. Era necesario especificar correspondencias léxicas, estructuras gramaticales, excepciones y procedimientos para reorganizar las frases. Estos métodos podían ofrecer resultados útiles en dominios restringidos, pero requerían una enorme cantidad de trabajo y encontraban dificultades ante la riqueza del lenguaje cotidiano. Las palabras adquieren significado dentro de frases y situaciones, y las construcciones que resultan naturales en una lengua no siempre tienen una equivalencia directa en otra. La experiencia temprana con la traducción automática mostró precisamente que conocer el vocabulario no bastaba: hacía falta resolver problemas de sintaxis, significado y contexto que podían multiplicar rápidamente el número de reglas necesarias.
A partir de las últimas décadas del siglo XX ganó fuerza un enfoque diferente: la traducción estadística. En lugar de intentar describir manualmente todas las transformaciones posibles, los sistemas aprendían correspondencias utilizando grandes colecciones de textos disponibles en varios idiomas. Si una misma obra, documento institucional o conjunto de noticias existía en dos lenguas, podían compararse sus segmentos y estimar qué palabras o expresiones tendían a aparecer como traducciones unas de otras. Los modelos posteriores trabajaron no solo con palabras aisladas, sino también con grupos o frases, combinando probabilidades para elegir entre distintas alternativas. La traducción pasaba así de estar gobernada principalmente por reglas explícitas a construirse mediante regularidades observadas en grandes cantidades de ejemplos bilingües.
El aprendizaje profundo volvió a transformar el campo con la llamada traducción automática neuronal. En lugar de dividir el problema en numerosos componentes independientes, una red neuronal podía aprender una transformación más integrada entre una secuencia en un idioma y otra en el idioma de destino. Los primeros sistemas neuronales de secuencia a secuencia codificaban la oración de partida en una representación interna y generaban después la traducción palabra a palabra o unidad a unidad. El desarrollo de mecanismos de atención mejoró considerablemente este proceso al permitir que, durante la generación, el modelo concediera mayor importancia a diferentes partes del texto original. De este modo podía manejar mejor frases largas y relaciones lingüísticas alejadas entre sí. Más adelante, nuevas arquitecturas ampliarían radicalmente esta capacidad, una evolución que resultará fundamental al estudiar los modelos de lenguaje.
Los resultados mejoraron hasta hacer posible una traducción automática muy útil en numerosas situaciones, pero las dificultades no desaparecieron. El sistema debe decidir entre significados posibles, mantener referencias a lo largo de una frase, reconocer nombres propios, respetar terminología especializada y adaptar construcciones que carecen de correspondencia literal. También puede perder matices de tono, ironía, registros sociales o referencias culturales. Las lenguas con abundantes recursos digitales suelen disponer de más ejemplos para el entrenamiento que aquellas menos representadas, por lo que la calidad puede variar considerablemente. Incluso una traducción gramaticalmente fluida puede contener una elección semántica incorrecta difícil de detectar a primera vista. Por ello, en ámbitos jurídicos, médicos, literarios o técnicos, la revisión humana puede seguir siendo esencial cuando una pequeña diferencia de significado tiene consecuencias importantes.
La traducción automática constituye un buen ejemplo de cómo la inteligencia artificial comenzó a integrar reconocimiento, aprendizaje estadístico y tratamiento del lenguaje en servicios utilizados por millones de personas. Una tarea que durante décadas fue un problema experimental terminó incorporándose a navegadores, teléfonos, buscadores, aplicaciones de viaje y plataformas de comunicación, hasta convertirse en una función casi invisible. Este proceso revela también una característica común a muchas aplicaciones contemporáneas: el sistema analiza grandes cantidades de información previa para estimar qué resultado es más adecuado ante una nueva entrada. Esa misma lógica de aprender relaciones y probabilidades puede utilizarse fuera del lenguaje. En lugar de decidir qué frase corresponde a otra, una máquina puede intentar estimar qué película, canción, noticia o producto podría interesar a una persona. De ahí surge otra de las tecnologías más extendidas y discretas de la inteligencia artificial cotidiana: los sistemas de recomendación.
9.6. Sistemas de recomendación
Los sistemas de recomendación intentan resolver un problema característico de la era digital: elegir unas pocas opciones relevantes dentro de una oferta demasiado grande para ser examinada por completo. Cuando una plataforma contiene millones de canciones, películas, productos, noticias o publicaciones, mostrar todo con el mismo peso dejaría al usuario ante una cantidad prácticamente inmanejable de información. El recomendador actúa entonces como un mecanismo de selección y ordenación. Utiliza datos disponibles sobre contenidos, usuarios y comportamientos anteriores para estimar qué elementos podrían resultar más pertinentes en cada situación. No necesita «conocer» los gustos de una persona en un sentido humano; construye predicciones a partir de regularidades estadísticas que relacionan elecciones pasadas con posibles preferencias futuras.
Uno de los enfoques clásicos es el filtrado colaborativo. Su principio consiste en aprovechar las relaciones entre usuarios y elementos sin necesitar necesariamente una descripción detallada de cada producto. Si dos personas han mostrado preferencias semejantes en numerosas ocasiones, aquello que interesa a una de ellas puede proporcionar información sobre lo que podría interesar a la otra. También puede trabajarse desde la perspectiva inversa, identificando elementos que suelen ser elegidos por perfiles similares. A gran escala, estas relaciones pueden representarse matemáticamente mediante matrices y modelos capaces de descubrir factores latentes: patrones internos que resumen afinidades sin tener que expresarlas mediante categorías explícitas como «aventuras», «jazz» o «historia». El sistema aprende así una estructura de proximidades construida a partir del comportamiento colectivo.
Otra estrategia utiliza directamente las características de los contenidos. Un recomendador basado en contenido puede analizar atributos de películas, libros, canciones o productos y compararlos con aquellos que una persona ha valorado o utilizado anteriormente. Si alguien consulta con frecuencia documentos de un determinado tema, escucha ciertos estilos musicales o compra productos con propiedades semejantes, el sistema puede localizar otros elementos que compartan características relevantes. Los servicios reales suelen combinar múltiples enfoques y añadir numerosas señales adicionales: búsquedas, clics, tiempo de reproducción, compras, abandonos, contexto temporal o dispositivo utilizado. Algunas de estas señales son explícitas, como una valoración; otras son implícitas y deben interpretarse con cautela, porque detenerse sobre un contenido no significa necesariamente apreciarlo.
La recomendación tampoco consiste únicamente en predecir una puntuación. En muchas aplicaciones, el verdadero problema es ordenar candidatos: decidir cuáles deben aparecer primero entre miles o millones de posibilidades. Los sistemas modernos pueden generar inicialmente un conjunto reducido de opciones y después aplicar modelos más sofisticados para clasificarlas. En esta decisión intervienen varios objetivos posibles. Una plataforma puede intentar estimar relevancia, diversidad, novedad o probabilidad de interacción, y debe evitar mostrar continuamente variantes casi idénticas de aquello que ya conoce. También aparece el problema del arranque en frío: un usuario nuevo apenas dispone de historial y un producto recién incorporado todavía no ha acumulado interacciones. En esos casos, el sistema necesita recurrir a información adicional, tendencias generales o exploración hasta reunir suficientes señales.
La personalización introduce, además, límites importantes. Las preferencias humanas cambian, dependen del momento y pueden contener contradicciones que un historial pasado no refleja bien. Una recomendación técnicamente eficaz puede terminar reduciendo la variedad si insiste demasiado en patrones conocidos, mientras que un exceso de exploración puede ofrecer resultados poco relevantes. También existe una diferencia entre aquello que una persona elige y aquello que un sistema interpreta como señal de interés. Los datos de comportamiento están condicionados por lo que previamente se mostró: si una opción nunca aparece, el usuario tampoco puede seleccionarla. El recomendador participa así en un circuito en el que sus propias decisiones afectan a los datos que utilizará posteriormente para aprender. Evaluarlo exige observar no solo cuántos clics obtiene, sino qué tipo de experiencia produce a lo largo del tiempo.
Los sistemas de recomendación ejemplifican especialmente bien la incorporación silenciosa de la inteligencia artificial a la vida cotidiana. Millones de decisiones digitales están mediadas por mecanismos que seleccionan qué música escuchar después, qué vídeo aparece en una pantalla, qué producto se muestra primero o qué contenido puede resultar más relevante entre una multitud de alternativas. Su presencia suele pasar inadvertida precisamente porque no se presentan como una «máquina inteligente» separada del servicio, sino como parte natural de su funcionamiento. Esta invisibilidad marca una etapa importante en la historia de la IA: muchas de sus técnicas más exitosas dejaron de parecer extraordinarias porque se integraron en objetos y aplicaciones de uso ordinario. Reconocer esa presencia permitirá observar, en el siguiente apartado, cuántas tecnologías utilizamos diariamente sin identificarlas ya como inteligencia artificial.
9.7. IA cotidiana: tecnologías que utilizamos sin percibirlas como inteligencia artificial
Una tecnología deja de parecernos extraordinaria cuando se vuelve habitual. Muchas capacidades que durante décadas fueron presentadas como ejemplos de inteligencia de las máquinas han terminado incorporándose a teléfonos, automóviles, buscadores, cámaras o servicios digitales hasta convertirse en funciones casi invisibles. Cuando un correo no deseado desaparece automáticamente de la bandeja de entrada, una fotografía nocturna mejora al instante o una aplicación calcula una ruta teniendo en cuenta numerosas condiciones, rara vez pensamos en inteligencia artificial. Vemos simplemente una herramienta que funciona. Esta normalización constituye una de las transformaciones más profundas de la historia de la IA: el campo dejó de estar representado únicamente por experimentos de laboratorio o sistemas claramente identificados como «inteligentes» y comenzó a formar parte de una infraestructura digital utilizada continuamente.
Los buscadores ofrecen un ejemplo especialmente claro. Encontrar una página relevante entre cantidades inmensas de información exige mucho más que localizar palabras idénticas a las escritas por el usuario. Los sistemas deben ordenar resultados, interpretar relaciones entre términos, estimar la utilidad de diferentes páginas y adaptarse a consultas que pueden formularse de múltiples maneras. Algo semejante ocurre con los filtros de correo basura, que analizan numerosas señales para distinguir mensajes legítimos de comunicaciones no deseadas, o con los mecanismos utilizados por entidades financieras para detectar operaciones que se apartan de determinados patrones habituales. En estos casos, la IA no se presenta mediante una interfaz espectacular: actúa detrás del servicio, seleccionando, clasificando o estimando probabilidades antes de que el usuario vea el resultado.
El teléfono móvil concentra una cantidad especialmente grande de estas tecnologías. La cámara puede combinar varias exposiciones, reducir ruido, estabilizar una imagen, identificar escenas o separar un rostro del fondo mediante procedimientos que dependen de visión computacional y aprendizaje automático. El teclado propone palabras, corrige errores y puede ajustar sus predicciones a patrones lingüísticos; las galerías fotográficas agrupan imágenes por lugares, objetos o personas; determinadas aplicaciones reconocen música, convierten voz en texto o eliminan sonidos ambientales durante una llamada. Muchas de estas funciones ocurren en segundos y algunas se ejecutan directamente en el dispositivo mediante procesadores diseñados para acelerar operaciones de aprendizaje automático. La inteligencia artificial aparece así integrada en la experiencia ordinaria del aparato, sin exigir que el usuario conozca el mecanismo que la hace posible.
La navegación digital ofrece otro ejemplo de esta presencia discreta. Calcular una ruta entre dos puntos es un problema clásico de búsqueda, pero los sistemas actuales pueden incorporar información sobre tráfico, velocidades habituales, accidentes, restricciones o variaciones temporales para estimar recorridos y tiempos de llegada. En otros ámbitos, aplicaciones de fotografía ordenan archivos, plataformas de vídeo generan subtítulos, servicios de música identifican canciones y programas de seguridad examinan comportamientos potencialmente anómalos. Incluso operaciones aparentemente pequeñas, como mejorar automáticamente la legibilidad de un documento fotografiado o separar la voz de un entorno ruidoso, pueden depender de modelos entrenados con numerosos ejemplos. Ninguna de estas funciones representa una inteligencia general; son capacidades especializadas insertadas en herramientas mayores.
Esta integración ayuda a comprender por qué resulta difícil establecer una frontera permanente entre «software normal» e inteligencia artificial. Una técnica puede considerarse avanzada mientras todavía constituye un problema de investigación y, años después, pasar a formar parte de una aplicación ordinaria sin que cambie su naturaleza técnica. Tampoco todo proceso automatizado debe llamarse inteligencia artificial: existen incontables programas basados en reglas convencionales perfectamente suficientes para realizar sus tareas. En los productos reales, además, ambas formas suelen convivir. Un servicio puede combinar componentes programados explícitamente, bases de datos, algoritmos clásicos y modelos aprendidos. Lo importante no es atribuir la etiqueta de IA a cada función digital, sino reconocer cuándo un sistema utiliza métodos capaces de inferir patrones, clasificar señales o realizar predicciones a partir de experiencia acumulada.
La inteligencia artificial cotidiana representa, en cierto modo, el éxito silencioso de muchas líneas de investigación desarrolladas durante décadas. Ver, escuchar, reconocer, ordenar y recomendar dejaron de ser únicamente aspiraciones científicas y pasaron a constituir componentes habituales de sistemas tecnológicos complejos. Pero una capacidad destaca por la profundidad con la que atraviesa nuestra experiencia y por las dificultades que históricamente planteó a las máquinas: el lenguaje. Las palabras no se limitan a describir objetos; permiten expresar relaciones, preguntas, instrucciones, narraciones y conocimientos dentro de contextos cambiantes. Una vez que los sistemas aprendieron a reconocer señales visuales y acústicas con creciente eficacia, el siguiente desafío consistió en representar esas relaciones lingüísticas de manera computacional. Allí comenzaría otra transformación decisiva: el paso desde el procesamiento elemental del texto hasta los modelos de lenguaje.
El lenguaje convirtió la inteligencia artificial en algo más que una máquina capaz de clasificar señales o reconocer patrones. Una imagen puede contener objetos y una grabación puede convertirse en palabras, pero comprender y producir lenguaje obliga a trabajar con relaciones que cambian según el contexto. Una misma palabra puede adoptar significados distintos, una frase puede insinuar más de lo que afirma literalmente y el sentido de una expresión puede depender de otras aparecidas mucho antes. Durante décadas, conseguir que un ordenador tratara esas estructuras de manera útil fue una de las fronteras más resistentes de la disciplina. De ese desafío surgió el procesamiento del lenguaje natural, un campo situado entre informática, lingüística, estadística y aprendizaje automático cuyo propósito es hacer posible que las máquinas analicen, relacionen y produzcan información expresada mediante lenguas humanas.
Los primeros intentos abordaron el lenguaje como un sistema que podía describirse mediante vocabularios, reglas gramaticales y procedimientos cuidadosamente programados. Era una estrategia razonable: si una lengua posee estructuras, quizá bastaría con convertirlas en instrucciones formales. Sin embargo, pronto apareció una dificultad conocida en otros ámbitos de la inteligencia artificial. Las reglas podían funcionar bien en ejemplos previstos y romperse ante expresiones ambiguas, excepciones, nuevas construcciones o variaciones de uso. A medida que crecieron las colecciones digitales de textos, comenzó a imponerse otra perspectiva. En lugar de indicar manualmente todas las relaciones lingüísticas, los sistemas podían calcular con qué frecuencia aparecían determinadas palabras, qué secuencias eran más probables y qué asociaciones se repetían en grandes corpus. El lenguaje empezaba a ser tratado también como un fenómeno susceptible de aprendizaje estadístico.
Ese cambio planteó una cuestión fundamental: ¿cómo puede representarse matemáticamente una palabra? Para un ordenador, los términos escritos no poseen por sí mismos significado. Deben transformarse en números que permitan compararlos y operar con ellos. Las primeras representaciones podían distinguir unas palabras de otras, pero decían poco acerca de sus relaciones. Métodos posteriores permitieron situarlas dentro de espacios matemáticos donde términos utilizados en contextos semejantes adquirían representaciones próximas. El significado dejaba de depender exclusivamente de una definición introducida manualmente y comenzaba a aparecer parcialmente reflejado en los patrones de uso. Estas representaciones distribuidas hicieron posible capturar semejanzas y relaciones que resultaban difíciles de expresar mediante categorías rígidas.
Pero las palabras aisladas no bastan. «Banco» puede referirse a una entidad financiera o a un asiento; «llave» puede abrir una puerta, regular el paso del agua o designar conceptos distintos según el ámbito. La información que permite elegir una interpretación se encuentra en las palabras que rodean al término y, en ocasiones, en fragmentos mucho más amplios del texto. Modelar ese contexto se convirtió en uno de los grandes problemas del procesamiento del lenguaje. Los sistemas necesitaban conservar relaciones a través de secuencias, determinar qué elementos eran relevantes para interpretar otros y construir representaciones que pudieran variar según el lugar ocupado por una palabra. Esta progresiva atención al contexto transformaría profundamente la manera de construir modelos lingüísticos.
Un modelo de lenguaje persigue una idea aparentemente modesta: aprender regularidades que permitan estimar qué unidades lingüísticas son probables dentro de una secuencia. Sin embargo, para hacer bien esa tarea necesita captar una enorme cantidad de estructura. Debe reconocer combinaciones gramaticales, asociaciones semánticas, estilos, dependencias entre fragmentos y patrones que aparecen a distintas escalas. Los primeros modelos manejaban contextos relativamente pequeños; después llegaron arquitecturas capaces de procesar secuencias cada vez más extensas. El gran cambio se produciría con el Transformer, presentado en 2017, cuya arquitectura basada en mecanismos de atención permitió relacionar diferentes partes de una secuencia de una manera especialmente eficaz y favoreció un entrenamiento mucho más paralelo que el de muchos modelos recurrentes anteriores.
De esta evolución surgiría una conexión decisiva entre predicción y generación. Si un modelo puede estimar qué palabra o unidad es probable después de un contexto, puede repetir el procedimiento una y otra vez y construir progresivamente una nueva secuencia. Una operación concebida inicialmente como predicción estadística se convierte así en un mecanismo capaz de producir texto. Comprender este proceso resulta esencial para evitar dos simplificaciones opuestas: reducir estos sistemas a una mera copia de frases almacenadas o atribuirles automáticamente una comprensión humana del lenguaje. Entre ambos extremos existe una maquinaria matemática capaz de aprender estructuras lingüísticas extraordinariamente complejas. Este epígrafe recorrerá ese camino, desde el procesamiento del lenguaje natural y las primeras reglas hasta las representaciones matemáticas, el contexto, los modelos de lenguaje y la arquitectura Transformer, dejando preparada la transición hacia la nueva etapa en la que los sistemas pasarán de reconocer información a generar contenidos.
10.1. Procesamiento del lenguaje natural
El procesamiento del lenguaje natural, conocido habitualmente por sus siglas PLN o NLP en inglés, es el área de la inteligencia artificial dedicada a trabajar con lenguaje humano en forma escrita o hablada. Su objetivo no es únicamente almacenar palabras o buscar coincidencias, sino convertir textos y expresiones en estructuras que puedan ser analizadas por una máquina. Esto incluye tareas tan diferentes como identificar palabras relevantes, clasificar documentos, extraer información, responder preguntas, resumir textos o participar en una conversación. La dificultad reside en que el lenguaje no es una simple sucesión de símbolos independientes: cada término puede cambiar de significado según el contexto y una misma intención puede expresarse de muchas formas distintas.
El lenguaje humano combina varios niveles de organización. En la base aparecen sonidos y palabras; después, reglas sintácticas que determinan cómo se combinan; más arriba, relaciones semánticas vinculadas al significado; y finalmente aspectos pragmáticos relacionados con la intención, el contexto y la situación comunicativa. Un sistema puede reconocer correctamente todas las palabras de una frase y aun así interpretar mal lo que quiere decir. También puede producir una oración gramaticalmente impecable pero poco adecuada al contexto. Por esta razón, el procesamiento del lenguaje natural ha tenido que enfrentarse a problemas que van mucho más allá de identificar vocabulario. Analizar una frase exige considerar cómo se relacionan sus partes y qué papel cumple cada una dentro del mensaje.
La ambigüedad constituye uno de los mayores obstáculos. Muchas palabras poseen varios significados y numerosas estructuras sintácticas admiten más de una interpretación. La frase «vi al hombre con el telescopio» puede indicar que quien observa utilizó un telescopio o que el hombre observado lo llevaba. Una persona suele resolver esa ambigüedad mediante conocimientos previos y contexto; para una máquina, esa información debe representarse de alguna manera. Lo mismo ocurre con pronombres, elipsis, ironía o referencias indirectas. El lenguaje cotidiano está lleno de elementos que no pueden comprenderse observando una palabra aislada. El procesamiento natural necesita por tanto modelos capaces de relacionar fragmentos y estimar qué interpretación resulta más plausible dentro de una situación.
Otra dificultad aparece porque las lenguas cambian continuamente. Incorporan nuevas palabras, modifican significados, adoptan expresiones y presentan enormes diferencias entre registros formales, conversaciones, textos científicos o mensajes breves. Además, no todos los idiomas disponen de la misma cantidad de recursos digitales. Los sistemas suelen funcionar mejor cuando cuentan con grandes colecciones de textos y ejemplos de uso, mientras que las lenguas con menos datos disponibles pueden quedar peor representadas. Incluso dentro de un mismo idioma existen variantes geográficas, sociales y profesionales que alteran vocabulario y estilo. El procesamiento del lenguaje natural debe enfrentarse, por ello, a una realidad lingüística mucho más variable que cualquier conjunto cerrado de reglas.
A lo largo de su historia, el campo ha utilizado estrategias muy diferentes. Los primeros sistemas dependían en gran medida de gramáticas, diccionarios y reglas diseñadas manualmente. Más tarde cobraron fuerza los métodos estadísticos, capaces de aprender regularidades a partir de grandes colecciones de textos. Con el aprendizaje profundo aparecieron modelos que podían construir representaciones internas mucho más complejas y manejar secuencias extensas con mayor eficacia. Cada etapa amplió las capacidades disponibles, pero también mostró que el lenguaje exige combinar estructura, contexto y experiencia. La evolución del PLN refleja así una transformación general de la inteligencia artificial: pasar de intentar describir explícitamente cada regla a aprender patrones a partir de datos.
El procesamiento del lenguaje natural ocupa un lugar central porque el lenguaje es una vía privilegiada para acceder al conocimiento humano. Libros, artículos, documentos, conversaciones y archivos digitales contienen enormes cantidades de información expresada mediante palabras. Poder trabajar con ese material permite a una máquina clasificar, buscar, relacionar y generar información de formas cada vez más sofisticadas. Sin embargo, para llegar a los sistemas actuales fue necesario abandonar progresivamente la idea de que bastaba con programar reglas lingüísticas detalladas. El siguiente paso histórico consistió en observar el lenguaje como un fenómeno estadístico: estudiar qué palabras aparecen juntas, qué secuencias son frecuentes y qué regularidades pueden aprenderse a partir de grandes corpus. De esa transición surgiría una nueva etapa en el tratamiento computacional del lenguaje.
10.2. De las reglas lingüísticas a los métodos estadísticos
Durante las primeras décadas del procesamiento del lenguaje natural predominó una idea intuitiva: si las lenguas poseen gramática, vocabulario y estructuras reconocibles, una máquina debería poder tratarlas mediante reglas explícitas. Lingüistas e informáticos construían diccionarios, analizadores sintácticos y conjuntos de instrucciones destinados a identificar categorías gramaticales, relaciones entre palabras o transformaciones necesarias para pasar de una expresión a otra. El enfoque produjo sistemas valiosos y permitió formalizar numerosos aspectos del lenguaje, pero tenía un coste elevado. Cada nueva construcción podía exigir nuevas reglas, las excepciones se acumulaban y una modificación introducida para resolver un caso podía provocar errores en otros. El problema no era que las reglas lingüísticas fueran inútiles, sino que el lenguaje real presentaba demasiada variedad para quedar completamente encerrado en sistemas elaborados manualmente.
La dificultad se hacía especialmente visible cuando un programa abandonaba los ejemplos cuidadosamente preparados y encontraba textos cotidianos. Una frase podía admitir varias interpretaciones sintácticas, una palabra podía desempeñar funciones diferentes y expresiones perfectamente comprensibles para una persona podían no ajustarse a las estructuras previstas por el sistema. Para decidir entre alternativas, las reglas necesitaban incorporar cada vez más conocimientos adicionales. El número de posibilidades crecía y el mantenimiento de grandes gramáticas computacionales se volvía complejo. Además, distintos especialistas podían formular de maneras diferentes una misma regularidad lingüística. La construcción del sistema dependía así de un trabajo artesanal considerable: expertos humanos debían anticipar cómo podía aparecer el lenguaje y traducir ese conocimiento a representaciones formales capaces de ser ejecutadas por un ordenador.
La creciente disponibilidad de textos digitalizados abrió otra posibilidad: en lugar de indicar a la máquina cómo debía comportarse ante cada estructura, podía observarse cómo se utiliza realmente el lenguaje en grandes colecciones de documentos. Durante las décadas de 1980 y 1990, los métodos estadísticos adquirieron una importancia creciente en reconocimiento del habla, traducción automática y otras áreas del PLN. El objetivo era estimar probabilidades a partir de ejemplos. Si determinadas palabras aparecían frecuentemente juntas, esa regularidad podía utilizarse para decidir entre interpretaciones; si una secuencia era habitual y otra extremadamente rara, el sistema podía asignar mayor probabilidad a la primera. El lenguaje comenzaba así a tratarse no únicamente como un conjunto de reglas, sino como una distribución de patrones observables cuyo comportamiento podía medirse.
Los modelos de n-gramas constituyen un ejemplo clásico de esta perspectiva. En lugar de analizar toda la estructura profunda de una oración, estimaban la probabilidad de una palabra a partir de una pequeña cantidad de palabras anteriores. Un bigrama utiliza la precedente; un trigrama considera las dos anteriores, y así sucesivamente. El procedimiento parece muy limitado, pero con suficientes datos podía captar regularidades útiles sobre qué secuencias resultaban habituales. Otros métodos probabilísticos, como los modelos ocultos de Markov, se aplicaron a tareas como el etiquetado gramatical y el reconocimiento de secuencias. La idea común era sustituir decisiones absolutamente rígidas por estimaciones: ante varias posibilidades, el sistema escogía aquella que los datos indicaban como más probable.
Este cambio modificó también la manera de evaluar el progreso. Un sistema basado en reglas podía discutirse examinando la corrección de su gramática o la lógica de sus transformaciones; los métodos estadísticos favorecieron comparaciones cuantitativas sobre conjuntos de datos comunes. Se entrenaba un modelo con una parte del corpus y después se comprobaba su comportamiento sobre ejemplos que no había visto. La calidad de los datos adquirió una importancia central, porque las probabilidades aprendidas reflejaban aquello que aparecía en ellos. Un corpus pequeño podía dejar sin observar secuencias relevantes, mientras que uno poco representativo podía transmitir patrones demasiado específicos. La investigación lingüística computacional comenzó así a relacionarse estrechamente con recopilación de corpus, estadística, aprendizaje automático y métodos sistemáticos de evaluación.
La transición no eliminó de inmediato las reglas ni convirtió el lenguaje en una simple tabla de frecuencias. Durante muchos años coexistieron sistemas simbólicos, estadísticos e híbridos, y numerosos conocimientos lingüísticos siguieron siendo útiles. Lo verdaderamente decisivo fue el cambio de perspectiva: la máquina podía aprender una parte considerable de las regularidades lingüísticas observando ejemplos, en lugar de recibirlas todas formuladas de antemano. Ese principio preparó el terreno para modelos cada vez más flexibles, pero todavía quedaba una dificultad fundamental. Contar palabras y secuencias permite estimar probabilidades, aunque ofrece una representación muy pobre de las relaciones entre significados. El siguiente paso consistiría en transformar las palabras en objetos matemáticos capaces de expresar semejanzas y asociaciones: representaciones numéricas donde parte de la estructura del lenguaje pudiera quedar reflejada en la propia geometría.
Visión artificial y reconocimiento. Los sistemas de visión artificial pueden detectar patrones, objetos, rostros y otras características presentes en imágenes y vídeo. La visión artificial constituye uno de los campos más desarrollados de la inteligencia artificial. A través de modelos entrenados con grandes conjuntos de imágenes, los sistemas pueden identificar objetos, analizar escenas, reconocer rostros y extraer características visuales útiles para numerosas aplicaciones. © DepictionImages.
10.3. Representaciones matemáticas de palabras y significados
Para que una máquina pueda trabajar con lenguaje, las palabras deben transformarse en objetos matemáticos. Una forma elemental de hacerlo consiste en asignar a cada término un identificador diferente, como si cada palabra ocupara una casilla propia dentro de un vocabulario. Este procedimiento permite distinguir «casa» de «árbol» o «mar», pero no expresa que algunas palabras están más relacionadas entre sí que otras. Desde el punto de vista del sistema, dos identificadores distintos pueden estar tan separados como cualquier otro par. Las representaciones llamadas one-hot llevaron esta idea a vectores muy grandes en los que cada palabra se identifica mediante una única posición activa. Son útiles para distinguir elementos, pero no contienen por sí mismas información sobre semejanza, afinidad o significado. El reto consistía en construir una representación donde las relaciones lingüísticas pudieran reflejarse también numéricamente.
Una respuesta decisiva surgió de una idea conocida en lingüística distribucional: las palabras que aparecen en contextos parecidos tienden a compartir alguna relación de significado o función. Si «perro» y «gato» aparecen frecuentemente junto a términos como «animal», «doméstico», «veterinario» o «alimentar», mientras que «telescopio» aparece asociado a «estrella», «observatorio» o «galaxia», esos patrones de uso proporcionan información. En lugar de definir cada palabra mediante una entrada de diccionario, puede describirse estadísticamente por los entornos lingüísticos en los que aparece. El significado computacional comienza entonces a construirse a partir de relaciones. Una palabra no queda representada únicamente por su identidad aislada, sino también por su posición dentro de una red de asociaciones formada por millones de apariciones en textos.
De esta perspectiva surgieron las representaciones vectoriales distribuidas, conocidas habitualmente como embeddings. Cada palabra puede asociarse a un vector compuesto por numerosos valores numéricos dentro de un espacio de varias dimensiones. Durante el entrenamiento, esos valores se ajustan de manera que palabras utilizadas en contextos semejantes terminen ocupando regiones próximas del espacio. La proximidad matemática puede reflejar así ciertos tipos de semejanza semántica o funcional. «Madrid» puede aparecer más cerca de otras ciudades que de nombres de animales; verbos relacionados con movimiento pueden formar patrones propios; términos científicos pertenecientes a un mismo ámbito pueden compartir determinadas direcciones. Ninguna dimensión individual necesita equivaler de forma sencilla a una categoría humana: el significado está distribuido entre numerosos valores que adquieren sentido conjuntamente.
Métodos como Word2Vec, presentado en 2013 por Tomas Mikolov y colaboradores, mostraron de manera especialmente influyente hasta qué punto estas representaciones podían capturar regularidades lingüísticas. Sus modelos aprendían vectores intentando predecir una palabra a partir de su contexto o, en la dirección inversa, predecir términos cercanos a partir de una palabra dada. Otros métodos, como GloVe, aprovecharon estadísticas globales de coaparición dentro de grandes corpus. Estas técnicas hicieron célebres determinadas relaciones vectoriales aproximadas entre conceptos, porque ciertas diferencias entre palabras parecían conservar patrones comparables dentro del espacio matemático. Aunque estos ejemplos no deben interpretarse como una comprensión completa del significado, demostraban que una representación aprendida podía codificar relaciones mucho más ricas que una simple identificación de vocabulario.
Los embeddings también mostraron sus límites. Una representación clásica asigna normalmente un mismo vector a una palabra aunque esta aparezca con significados diferentes. «Banco» conserva esencialmente la misma representación tanto si se refiere a una entidad financiera como a un asiento, a menos que el sistema disponga de mecanismos adicionales para distinguir los contextos. Además, los espacios vectoriales reflejan los patrones presentes en los textos utilizados para aprenderlos, incluidas asociaciones accidentales, desequilibrios o sesgos. La semejanza matemática tampoco debe confundirse con una definición filosófica del significado: el modelo captura regularidades de uso, no una experiencia directa de aquello que las palabras designan. Aun así, estas representaciones ofrecieron una herramienta extraordinariamente poderosa para convertir relaciones lingüísticas en estructuras que podían ser procesadas mediante aprendizaje automático.
El verdadero avance posterior consistiría en abandonar la idea de que una palabra debe poseer siempre una representación fija. Si el significado depende de la frase, entonces la representación debería poder cambiar también según las palabras que la rodean. «Ratón» no debería ocupar exactamente el mismo estado interno cuando aparece junto a «ordenador» que cuando aparece junto a «mamífero». Este paso desde vectores estáticos hacia representaciones sensibles al contexto transformaría profundamente los modelos de lenguaje. Las palabras seguirían convirtiéndose en números, pero esos números pasarían a depender dinámicamente de sus relaciones dentro de la secuencia. Comprender esa transición es esencial para explicar cómo los sistemas modernos dejaron de tratar el vocabulario como un conjunto de piezas aisladas y comenzaron a modelar el lenguaje como una estructura en la que cada elemento modifica el sentido de los demás.
10.4. Contexto y relaciones entre palabras
El significado de una palabra rara vez puede determinarse de forma completa cuando aparece aislada. «Planta» puede referirse a un organismo vegetal, al nivel de un edificio o a una instalación industrial; «capital» puede designar una ciudad, una cantidad de recursos económicos o adquirir otros sentidos según el contexto. Una persona suele resolver estas diferencias casi de inmediato porque interpreta cada término dentro de la frase, del tema tratado y de lo dicho anteriormente. Para una máquina, reproducir esa capacidad exige representar no solo las palabras, sino también las relaciones que mantienen entre sí. El lenguaje deja entonces de parecer una colección de unidades independientes y pasa a entenderse como una estructura dinámica en la que cada elemento contribuye a modificar la interpretación de los demás.
Algunas de esas relaciones se encuentran muy cerca. Un adjetivo puede modificar al sustantivo que lo acompaña, un verbo establece vínculos con sus complementos y determinadas combinaciones resultan mucho más probables que otras. Pero otras dependencias pueden recorrer una frase entera o incluso atravesar varias oraciones. En «el libro que María compró ayer estaba agotado», la forma verbal final se relaciona con «el libro» aunque entre ambos aparezcan varias palabras. Los pronombres plantean dificultades semejantes: interpretar correctamente «él», «ella», «este» o «aquello» puede requerir localizar una referencia mencionada anteriormente. Captar estas dependencias a larga distancia fue durante años uno de los desafíos fundamentales de los sistemas lingüísticos, porque analizar únicamente pequeñas ventanas de palabras dejaba fuera una parte esencial de la información.
Los modelos secuenciales intentaron resolver el problema procesando el lenguaje según el orden en que aparece. Las redes neuronales recurrentes introdujeron mecanismos mediante los cuales parte de la información obtenida al procesar una palabra podía mantenerse y utilizarse al analizar las siguientes. De este modo, cada nuevo elemento no se interpretaba completamente desde cero, sino en relación con un estado interno construido a partir de la secuencia anterior. Las arquitecturas LSTM y otras variantes mejoraron esta capacidad al permitir conservar información durante intervalos más largos y reducir algunas dificultades del entrenamiento. Estos métodos fueron especialmente importantes en traducción, reconocimiento de voz y modelado lingüístico, aunque seguían encontrando problemas cuando las dependencias se extendían demasiado o cuando era necesario procesar secuencias muy extensas de manera eficiente.
El concepto de representación contextual supuso un cambio todavía más profundo. En lugar de asignar siempre el mismo vector a una palabra, el sistema puede generar una representación distinta según la frase en la que aparece. Así, «banco» puede adquirir estados internos diferentes en «me senté en el banco del parque» y «el banco concedió un préstamo». La identidad escrita del término permanece, pero su representación matemática se modifica al incorporar información procedente de otras partes de la secuencia. Esto permite que el modelo distinga significados, funciones gramaticales y relaciones sin necesitar una entrada independiente para cada posible uso. El significado computacional deja de estar asociado exclusivamente a una palabra y comienza a distribuirse entre la palabra y el entorno lingüístico que la acompaña.
El contexto, sin embargo, no se reduce a resolver palabras ambiguas. También determina relaciones de causa, tiempo, negación, comparación o referencia. «No fue Pedro quien abrió la puerta» contiene prácticamente las mismas palabras que una afirmación positiva, pero su estructura cambia por completo la interpretación. Del mismo modo, comprender una explicación extensa puede requerir conservar información introducida varios párrafos antes. Cuanto mayor es la ventana contextual disponible, más relaciones potenciales puede considerar el modelo, aunque también aumenta la dificultad de decidir cuáles son realmente relevantes. La cuestión central pasa entonces de recordar indiscriminadamente todo lo anterior a seleccionar qué partes de la secuencia deben influir más en cada momento.
Esta necesidad de relacionar elementos distantes preparó una transformación decisiva en el procesamiento del lenguaje. Las palabras ya no podían tratarse únicamente como símbolos individuales ni como vectores fijos, y tampoco bastaba con recorrer una frase conservando un resumen imperfecto de lo anterior. Era necesario construir mecanismos capaces de comparar directamente distintas posiciones y determinar de forma flexible qué elementos merecían mayor atención para interpretar cada uno de los demás. Antes de llegar a esa arquitectura, sin embargo, conviene comprender el marco más amplio en el que aparecieron estas ideas: los modelos de lenguaje, sistemas diseñados para aprender regularidades de enormes cantidades de texto y estimar cómo se organizan las secuencias lingüísticas. Su evolución prepararía el terreno inmediato para una de las innovaciones más influyentes de la inteligencia artificial contemporánea.
10.5. El desarrollo de los modelos de lenguaje
Un modelo de lenguaje intenta describir matemáticamente qué secuencias lingüísticas resultan más probables dentro de una lengua. La idea puede parecer modesta: dado un fragmento de texto, estimar qué palabra o unidad podría aparecer después. Pero realizar esa tarea con precisión exige aprender una gran cantidad de regularidades. Para decidir cómo continúa una frase, el sistema debe reconocer combinaciones habituales, estructuras gramaticales, concordancias, usos de vocabulario y relaciones que pueden extenderse a través de varias palabras. Los primeros modelos abordaron este problema mediante probabilidades calculadas a partir de corpus: observaban qué secuencias aparecían con mayor frecuencia y utilizaban esas estadísticas para estimar nuevas combinaciones. Así surgió una forma cuantitativa de modelar el lenguaje sin necesidad de describir explícitamente todas sus reglas.
Los modelos basados en n-gramas desempeñaron durante años un papel central. Calculaban la probabilidad de una palabra atendiendo únicamente a una cantidad limitada de términos anteriores. Su ventaja era la simplicidad y podían ofrecer resultados muy útiles en reconocimiento de voz, corrección automática y otras aplicaciones. Pero también tenían una limitación estructural: trataban como diferentes secuencias que podían ser lingüísticamente semejantes y dependían de haber observado suficientes ejemplos de cada combinación. A medida que aumentaba el tamaño del vocabulario y se ampliaba el contexto, el número de posibles secuencias crecía de forma explosiva. Muchas combinaciones razonables nunca aparecían en los datos de entrenamiento, mientras que conservar tablas estadísticas de todas las posibilidades se volvía impracticable. El lenguaje necesitaba una representación capaz de generalizar mejor entre situaciones parecidas.
Las redes neuronales ofrecieron una alternativa al sustituir parte de esas tablas por representaciones aprendidas. A comienzos del siglo XXI comenzaron a desarrollarse modelos neuronales capaces de transformar palabras en vectores y utilizar esas representaciones para estimar probabilidades. Un trabajo influyente publicado en 2003 por Yoshua Bengio y colaboradores mostró cómo un modelo neuronal podía aprender simultáneamente representaciones distribuidas de palabras y una función capaz de predecir la siguiente palabra. La ventaja era fundamental: términos utilizados de manera semejante podían compartir parte de la estructura matemática, permitiendo que el sistema generalizara incluso ante combinaciones que no había observado exactamente. La predicción lingüística comenzaba a depender menos de contar secuencias completas y más de aprender regularidades continuas distribuidas entre numerosos parámetros.
Las redes recurrentes ampliaron después esta perspectiva al introducir un estado interno que evolucionaba conforme avanzaba la secuencia. En lugar de limitarse necesariamente a unas pocas palabras anteriores, podían incorporar información procedente de una parte más amplia del texto. Arquitecturas como las LSTM ayudaron a conservar determinadas dependencias durante intervalos mayores y adquirieron una gran importancia en modelado lingüístico, traducción y reconocimiento de voz. El modelo iba construyendo una representación de lo procesado hasta ese momento y utilizaba ese estado para estimar lo que podía venir después. Sin embargo, esta organización secuencial imponía dificultades: la información debía atravesar sucesivamente numerosos pasos, las dependencias muy largas seguían siendo complicadas y el entrenamiento tenía una capacidad limitada para aprovechar plenamente el procesamiento paralelo disponible en el hardware moderno.
Mientras mejoraban las arquitecturas, también cambió la escala de los modelos y la forma de utilizarlos. La expansión de Internet proporcionó colecciones textuales inmensas, y comenzó a resultar posible entrenar sistemas sobre grandes cantidades de lenguaje antes de adaptarlos a tareas concretas. En lugar de construir desde cero un modelo independiente para cada aplicación, se podía realizar un entrenamiento previo sobre textos generales y aprovechar después las representaciones adquiridas para clasificación, respuesta a preguntas u otros problemas. Esta estrategia de preentrenamiento permitió que el conocimiento estadístico obtenido a partir de grandes corpus se reutilizara de maneras diferentes. La frontera entre un modelo destinado exclusivamente a predecir texto y una infraestructura lingüística capaz de apoyar numerosas tareas comenzó a hacerse cada vez menos clara.
El desarrollo de los modelos de lenguaje fue convirtiendo así una técnica de predicción local en una forma cada vez más poderosa de representar estructura lingüística. Desde las tablas de frecuencias hasta las redes neuronales y los modelos recurrentes, cada etapa amplió el contexto que podía utilizarse, mejoró la capacidad de generalización y redujo la dependencia de reglas lingüísticas escritas manualmente. Pero seguía existiendo un obstáculo fundamental: relacionar de manera eficiente elementos muy alejados dentro de una secuencia sin obligar a que toda la información recorriera el texto paso a paso. Resolver ese problema requería una arquitectura distinta, capaz de determinar directamente qué partes del contexto eran relevantes para cada elemento y de aprovechar mucho mejor el cálculo paralelo. En 2017, esa propuesta adquiriría una forma concreta con la arquitectura Transformer, que transformaría profundamente el desarrollo de los modelos de lenguaje.
10.6. La arquitectura Transformer
La arquitectura Transformer marcó un punto de inflexión en el tratamiento computacional del lenguaje. Fue presentada en 2017 por un equipo de investigadores de Google en el artículo Attention Is All You Need, inicialmente en el contexto de la traducción automática. Hasta entonces, muchas redes utilizadas para trabajar con secuencias procesaban las palabras de manera recurrente: avanzaban paso a paso y conservaban un estado interno que resumía parte de la información anterior. Este procedimiento había producido resultados importantes, pero dificultaba el tratamiento de dependencias muy largas y limitaba el aprovechamiento del cálculo paralelo. El Transformer propuso una solución diferente: permitir que los elementos de una secuencia establecieran relaciones directas entre sí mediante mecanismos de atención, sin depender de una cadena recurrente que tuviera que recorrer obligatoriamente el texto en orden.
La pieza fundamental es la autoatención o self-attention. Cuando el modelo procesa una palabra o unidad lingüística, puede calcular qué otros elementos del contexto resultan relevantes para construir su representación. En una frase como «el científico que presentó los resultados afirmó que eran concluyentes», interpretar correctamente «eran» exige relacionarlo con «resultados» pese a que varias palabras se interpongan entre ambos. El mecanismo de atención permite establecer esa conexión directamente. Para ello, cada elemento genera representaciones matemáticas conocidas como consulta, clave y valor —query, key y value—. De forma simplificada, la consulta expresa qué información busca una posición, las claves permiten medir su relación con otras posiciones y los valores contienen la información que puede incorporarse. Las afinidades calculadas determinan cuánto debe influir cada elemento sobre los demás.
El Transformer no utiliza una sola relación de atención. Mediante la llamada atención multicabeza o multi-head attention, varias operaciones de atención pueden ejecutarse en paralelo, permitiendo que distintas partes del modelo aprendan relaciones diferentes. Una cabeza puede resultar sensible a ciertas dependencias sintácticas, otra a asociaciones semánticas y otras a patrones más difíciles de describir mediante categorías humanas simples. Después, estas informaciones se combinan y atraviesan nuevas transformaciones matemáticas dentro de cada bloque. Al apilar numerosos bloques, el sistema construye representaciones progresivamente contextualizadas. Una palabra deja así de poseer una descripción fija: su estado interno depende de los elementos con los que aparece y de las relaciones que el modelo considera relevantes en cada nivel de procesamiento.
Al abandonar la recurrencia aparece, sin embargo, una dificultad: el mecanismo de atención por sí solo no sabe en qué orden aparecen las palabras. Una frase contiene los mismos términos aunque se altere su posición, pero su significado puede cambiar completamente. Por ello, el Transformer incorpora información posicional que permite distinguir el primer elemento del segundo, el tercero y los siguientes. En el modelo original se utilizaron codificaciones posicionales matemáticas añadidas a las representaciones de entrada; arquitecturas posteriores desarrollaron otras soluciones. El diseño inicial incluía además dos grandes componentes, un codificador y un decodificador. El codificador construía representaciones de la secuencia de entrada y el decodificador utilizaba esa información para producir la secuencia de salida, una organización especialmente adecuada para tareas como la traducción.
Una de las grandes ventajas del Transformer fue su capacidad para aprovechar el procesamiento paralelo. Durante el entrenamiento, muchas posiciones de una secuencia podían calcularse simultáneamente, lo que encajaba especialmente bien con GPU y otros aceleradores. Esta característica facilitó trabajar con cantidades crecientes de datos y construir modelos mucho mayores. A partir de la arquitectura original aparecieron numerosas variantes. Algunos sistemas utilizaron principalmente el codificador para aprender representaciones útiles del lenguaje, como BERT; otros emplearon arquitecturas orientadas a la generación secuencial, como la familia GPT; y otros conservaron estructuras de codificador y decodificador para tareas de transformación entre secuencias. El Transformer pasó así de ser una propuesta concreta para traducción a convertirse en una arquitectura general utilizada en buena parte del procesamiento moderno del lenguaje.
Su éxito tampoco significa que haya eliminado todas las dificultades. La atención puede exigir una cantidad considerable de memoria y cálculo cuando aumenta la longitud de las secuencias, y ampliar los modelos incrementa los recursos necesarios para entrenarlos y utilizarlos. Además, las relaciones aprendidas continúan dependiendo de los datos disponibles y no garantizan por sí mismas una comprensión humana de aquello que se procesa. La verdadera importancia histórica del Transformer reside en haber proporcionado una arquitectura extraordinariamente eficaz para combinar contexto, escala y aprendizaje. Gracias a ella fue posible entrenar modelos lingüísticos con cantidades crecientes de parámetros y texto, capaces de capturar relaciones cada vez más amplias dentro de una secuencia. Sobre esta estructura se desarrollaría el paso que completa el recorrido de este epígrafe: utilizar la predicción de unidades lingüísticas no solo para modelar el lenguaje, sino también para generar texto nuevo de manera progresiva.
Modelos de lenguaje y generación de texto. Los grandes modelos de lenguaje utilizan arquitecturas capaces de analizar contexto y predecir secuencias lingüísticas. La arquitectura Transformer permitió procesar relaciones entre diferentes partes de un texto de forma especialmente eficaz. Sobre esta base se desarrollaron modelos capaces de trabajar con enormes cantidades de lenguaje y generar respuestas coherentes mediante la predicción de secuencias.
10.7. Predicción lingüística y generación de texto
La generación automática de texto parte de una operación aparentemente sencilla: estimar qué unidad lingüística debería aparecer después de una secuencia determinada. Un modelo recibe un contexto y calcula una distribución de probabilidades sobre las posibles continuaciones. Ante «La Tierra gira alrededor del…», por ejemplo, algunas opciones resultarán mucho más probables que otras porque el sistema ha aprendido regularidades presentes en los textos utilizados durante su entrenamiento. Pero los modelos actuales no trabajan necesariamente con palabras completas. El texto suele dividirse en unidades denominadas tokens, que pueden corresponder a palabras, fragmentos de palabras, signos de puntuación u otras secuencias frecuentes. La predicción se realiza sobre estas unidades, lo que permite manejar vocabularios amplios, términos poco comunes y diferentes formas lingüísticas mediante un repertorio limitado de componentes.
La capacidad generativa aparece cuando este procedimiento se repite. El modelo calcula una posible continuación, selecciona un token, lo incorpora al contexto y vuelve a estimar qué podría venir después. Cada nueva unidad modifica las probabilidades de las siguientes, de modo que el texto se construye progresivamente. Una oración conduce a otra y el modelo puede mantener relaciones con elementos anteriores mientras la información permanezca dentro del contexto que puede procesar. No existe necesariamente un texto completo almacenado de antemano esperando ser recuperado. La salida emerge paso a paso a partir de los parámetros aprendidos y de la secuencia generada hasta ese momento. Esta característica explica por qué una misma entrada puede producir respuestas diferentes y por qué el desarrollo de una frase condiciona continuamente aquello que resulta probable después.
Elegir siempre el token con mayor probabilidad produciría textos posibles, pero podría generar respuestas demasiado rígidas o repetitivas. Por ello, los sistemas de generación pueden utilizar distintos procedimientos de selección. Algunos restringen la elección a un grupo de alternativas relativamente probables; otros modifican cuánto se favorecen las opciones dominantes frente a las menos probables. Parámetros como la temperatura permiten, de manera simplificada, controlar esa distribución: valores bajos tienden a concentrar las elecciones y hacer la salida más predecible, mientras que valores mayores permiten una variación más amplia, aunque también pueden aumentar el riesgo de resultados incoherentes. La generación lingüística contiene así un equilibrio entre regularidad y variación. El modelo no necesita elegir siempre la continuación más frecuente para producir un texto plausible, pero tampoco puede alejarse arbitrariamente de los patrones aprendidos.
Para predecir bien, el sistema debe haber captado mucho más que asociaciones superficiales entre palabras consecutivas. Una continuación correcta puede depender de concordancia gramatical, referencias introducidas varias frases antes, conocimientos expresados repetidamente en los datos o convenciones propias de distintos géneros textuales. Durante el entrenamiento, la presión constante por mejorar la predicción obliga al modelo a desarrollar representaciones internas útiles para manejar parte de esa estructura. De ahí surge una propiedad sorprendente: una tarea de aprendizaje formulada como predicción puede producir capacidades que resultan útiles para completar frases, resumir, reformular, traducir o responder preguntas. Estas habilidades no tienen que haber sido programadas mediante una regla independiente para cada caso; pueden aprovechar regularidades compartidas que el modelo ha adquirido al trabajar con cantidades muy grandes de lenguaje.
Esta capacidad también tiene límites esenciales. Generar una secuencia lingüísticamente convincente no garantiza que su contenido sea verdadero. El objetivo inmediato del modelo consiste en producir continuaciones plausibles según los patrones aprendidos, no en comprobar automáticamente cada afirmación frente a la realidad. Puede combinar correctamente estructuras lingüísticas y, aun así, producir nombres, fechas, explicaciones o relaciones que no se correspondan con hechos verificables. La fluidez puede ocultar el error precisamente porque el sistema ha aprendido muy bien cómo se construyen textos que parecen coherentes. Tampoco la predicción lingüística demuestra por sí sola que la máquina posea experiencia, intención o comprensión humana. Lo que sí demuestra es que una cantidad enorme de estructura lingüística puede aprenderse mediante representaciones matemáticas y utilizarse después para producir secuencias nuevas con notable coherencia.
La predicción de tokens convirtió así el modelado del lenguaje en una tecnología generativa. Desde los primeros modelos probabilísticos hasta las redes neuronales y los Transformer, la evolución consistió en ampliar el contexto, mejorar las representaciones y aumentar la capacidad para aprender relaciones complejas. Cuando estos modelos comenzaron además a crecer en número de parámetros, volumen de datos y potencia de cálculo, sus posibilidades dejaron de limitarse a unas pocas tareas lingüísticas especializadas. El mismo sistema podía mostrar competencias diversas sin necesidad de construir desde cero un programa independiente para cada una. Esa transformación señala el final de una etapa y el comienzo de otra. La inteligencia artificial había pasado de reconocer y clasificar información a disponer de modelos capaces de producir contenido nuevo a partir de estructuras aprendidas. El siguiente paso será comprender qué ocurrió cuando esa capacidad se llevó a una escala mucho mayor y abrió el camino hacia una nueva generación de sistemas de inteligencia artificial.
La historia recorrida hasta aquí conduce a un cambio de escala que altera la propia forma de entender un sistema de inteligencia artificial. Durante décadas fue habitual construir programas destinados a resolver tareas relativamente delimitadas: reconocer una imagen, traducir una frase, clasificar un documento o predecir una determinada variable. Con el crecimiento del aprendizaje profundo comenzó a consolidarse otra posibilidad: entrenar modelos suficientemente amplios sobre cantidades masivas de información para que una misma base aprendida pudiera utilizarse después en muchas tareas diferentes. El sistema ya no tenía necesariamente que diseñarse desde cero para cada problema. Un modelo previamente entrenado podía convertirse en una infraestructura general sobre la que adaptar nuevas funciones, una transformación que acercaba la inteligencia artificial a arquitecturas mucho más versátiles que las generaciones anteriores.
Este cambio estuvo impulsado por una relación cada vez más estrecha entre datos, parámetros y capacidad de cálculo. Los modelos crecieron porque podían procesarse colecciones de información mayores, pero al mismo tiempo esas colecciones hacían útil aumentar la capacidad de los propios modelos. Millones de parámetros se convirtieron en miles de millones y, en algunos sistemas, en cantidades todavía superiores. La escala no constituía únicamente una cuestión de tamaño: modificaba qué regularidades podían aprenderse y qué clases de comportamiento aparecían después del entrenamiento. Sin embargo, tampoco existía una regla sencilla según la cual duplicar recursos produjera automáticamente el doble de inteligencia. Comprender esta nueva etapa exige observar cómo interactúan arquitectura, información disponible, procedimiento de entrenamiento y potencia computacional.
Al crecer los modelos comenzó además a hacerse menos clara la frontera entre reconocer información y producirla. Las redes habían alcanzado excelentes resultados clasificando imágenes, identificando sonidos o analizando textos; ahora, arquitecturas entrenadas sobre grandes cantidades de ejemplos podían también generar continuaciones lingüísticas, sintetizar imágenes, producir código o transformar unas representaciones en otras. Reconocer y generar no son procesos idénticos, pero pueden apoyarse en una misma capacidad fundamental: aprender la estructura estadística de grandes conjuntos de datos. Una máquina que ha captado suficientemente bien cómo se organizan ciertas formas de información puede utilizar ese conocimiento tanto para distinguirlas como para construir nuevas combinaciones. Esta transición será una de las claves para comprender por qué la IA generativa terminó adquiriendo una importancia tan visible.
La ampliación de escala trajo consigo otro fenómeno especialmente interesante: modelos entrenados con objetivos relativamente generales comenzaron a mostrar habilidades que no siempre habían sido programadas como módulos independientes. En la literatura científica se habla con frecuencia de capacidades emergentes para describir ciertos comportamientos que se hacen apreciables al aumentar la escala o cambiar las condiciones de entrenamiento. El concepto requiere prudencia, porque algunas aparentes discontinuidades pueden depender de la forma de medir el rendimiento y existe debate sobre qué debe considerarse realmente «emergente». Lo significativo es que los grandes modelos comenzaron a mostrar repertorios de comportamiento mucho más amplios que los sistemas especializados tradicionales: podían reutilizar representaciones aprendidas y responder a tareas diferentes mediante una misma arquitectura, aunque su rendimiento siguiera siendo irregular y dependiente del contexto.
También empezó a cambiar la separación entre modalidades. Durante buena parte de la historia de la IA, visión, lenguaje y sonido se desarrollaron como campos relativamente diferenciados, cada uno con modelos y técnicas propias. Las nuevas arquitecturas permitieron acercar progresivamente esas áreas y representar distintos tipos de información dentro de sistemas relacionados. Texto e imagen podían asociarse durante el entrenamiento; una descripción lingüística podía conectarse con características visuales, y otras combinaciones incorporarían posteriormente audio, vídeo o señales adicionales. Los sistemas multimodales representan así un paso hacia modelos capaces de relacionar diferentes formas de información, aunque ello no signifique que posean una percepción humana integrada. Su importancia reside en que reducen la necesidad de construir mundos computacionales completamente separados para cada tipo de dato.
Este último epígrafe del recorrido debe entenderse, por tanto, como un umbral. El crecimiento de los grandes modelos, la combinación de datos y parámetros a enorme escala, la aparición de capacidades más generales y la progresiva integración de distintas modalidades transformaron el panorama de la inteligencia artificial. Las técnicas desarrolladas durante décadas comenzaron a converger en sistemas capaces de reconocer, transformar y producir información dentro de una misma familia tecnológica. Aquí interesa comprender cómo se llegó hasta ese punto, no desarrollar todavía todas sus aplicaciones y consecuencias. Esa tarea pertenece a la etapa siguiente. El recorrido terminará precisamente cuando la generación de contenido deje de ser una capacidad secundaria y pase a ocupar el centro de una nueva generación de herramientas, asistentes y modelos: la inteligencia artificial generativa.
11.1. El crecimiento de los grandes modelos
Durante buena parte de la historia de la inteligencia artificial, los modelos se construían para tareas relativamente delimitadas. Un sistema destinado a reconocer determinadas imágenes, clasificar documentos o traducir textos se entrenaba con un objetivo concreto y su utilidad fuera de ese dominio podía ser muy reducida. El avance del aprendizaje profundo empezó a modificar esta lógica. A medida que aumentaban la capacidad de cálculo, la disponibilidad de información digital y la eficacia de las arquitecturas neuronales, resultó posible entrenar modelos cada vez mayores sobre conjuntos de datos mucho más amplios. El tamaño comenzó a medirse también por el número de parámetros ajustables: desde miles o millones en sistemas anteriores hasta cientos de millones, miles de millones y cantidades superiores en algunas generaciones posteriores. Ese crecimiento no fue simplemente cuantitativo. Permitió explorar la posibilidad de que un mismo modelo aprendiera representaciones suficientemente generales como para ser útil en muchas tareas diferentes.
El desarrollo del preentrenamiento fue fundamental para este cambio. En lugar de comenzar siempre con un modelo prácticamente vacío y entrenarlo exclusivamente para una aplicación determinada, podía realizarse primero una fase extensa sobre grandes colecciones de datos y adaptar después el conocimiento adquirido a objetivos más específicos. En lenguaje, por ejemplo, un sistema podía aprender inicialmente regularidades generales presentes en enormes cantidades de texto y utilizar posteriormente esas representaciones para clasificación, análisis o respuesta a distintas tareas. Esta estrategia aprovechaba una idea poderosa: buena parte de la estructura aprendida en un problema puede resultar útil en otros. El coste del entrenamiento inicial podía ser elevado, pero el modelo obtenido constituía una base reutilizable. La inteligencia artificial comenzaba así a desplazarse desde numerosos sistemas independientes hacia modelos amplios capaces de servir como punto de partida para aplicaciones diversas.
La arquitectura Transformer aceleró extraordinariamente esta evolución porque permitía entrenar modelos lingüísticos de gran tamaño de una forma adecuada al procesamiento paralelo disponible en el hardware moderno. A partir de 2018, sistemas como BERT mostraron el valor de preentrenar grandes redes sobre enormes cantidades de texto y adaptarlas posteriormente a diferentes problemas lingüísticos. La familia GPT siguió otra dirección especialmente orientada a la predicción y generación secuencial, aumentando progresivamente el tamaño de los modelos y la cantidad de información utilizada durante su entrenamiento. No fueron los únicos desarrollos, pero hicieron visible una tendencia general: en determinadas condiciones, ampliar la capacidad del modelo y proporcionarle más experiencia podía mejorar su rendimiento en una variedad creciente de tareas sin necesidad de diseñar para cada una una arquitectura completamente independiente.
Este crecimiento cambió también la economía de la investigación. Entrenar un modelo grande exige realizar cantidades inmensas de operaciones y almacenar numerosos parámetros, lo que requiere GPU, aceleradores especializados, sistemas distribuidos y centros de datos capaces de coordinar miles de dispositivos. La investigación puntera comenzó a depender de infraestructuras que podían superar ampliamente las posibilidades de un laboratorio convencional. Junto a universidades y centros públicos, las grandes empresas tecnológicas adquirieron un papel creciente porque disponían de datos, recursos informáticos y capacidad de inversión suficientes para realizar entrenamientos a gran escala. Al mismo tiempo, la publicación de modelos, herramientas y técnicas permitió que una parte importante de esos avances se difundiera por comunidades científicas y de desarrollo mucho más amplias. La escala se convirtió así tanto en una oportunidad tecnológica como en una nueva condición material de la investigación.
El tamaño, sin embargo, no constituye por sí solo una explicación del progreso. Un modelo con más parámetros puede disponer de mayor capacidad para representar relaciones complejas, pero necesita datos adecuados, una arquitectura eficaz y procedimientos de entrenamiento capaces de aprovechar esa capacidad. Un sistema enorme entrenado deficientemente puede rendir peor que otro menor y mejor diseñado. Además, el crecimiento introduce costes, dificultades de evaluación y comportamientos que no siempre mejoran de manera uniforme. Algunas tareas responden claramente al aumento de escala, mientras que otras continúan requiriendo datos especializados, métodos adicionales o modificaciones específicas. Hablar de «grandes modelos» no significa, por tanto, que exista una frontera exacta a partir de la cual un sistema se vuelva cualitativamente distinto; describe una tendencia histórica hacia modelos de alta capacidad entrenados con recursos cada vez mayores y utilizados como plataformas para múltiples funciones.
La importancia de esta transformación reside en que empezó a cambiar la unidad básica con la que se construía inteligencia artificial. En lugar de imaginar únicamente una colección de programas separados —uno para clasificar, otro para traducir y otro para analizar— comenzó a ser posible partir de modelos generales previamente entrenados y obtener de ellos comportamientos diferentes según la tarea y la forma de utilizarlos. Esa versatilidad preparó una modificación todavía más visible. Durante décadas, gran parte del aprendizaje automático había destacado por reconocer, ordenar, clasificar o predecir información existente. Los grandes modelos mostraron que las representaciones aprendidas a gran escala podían emplearse también para construir nuevas secuencias, imágenes y otros contenidos. El crecimiento de los modelos proporcionaba así la infraestructura sobre la que empezaría a hacerse evidente otro cambio histórico: el paso del reconocimiento a la generación.
De la inteligencia artificial especializada a los sistemas generativos. La nueva generación de modelos puede combinar lenguaje, imágenes y otros tipos de información en sistemas cada vez más versátiles. Los sistemas contemporáneos han ampliado las capacidades tradicionales de clasificación y reconocimiento hacia la generación de contenidos. Los modelos multimodales pueden trabajar simultáneamente con texto, imágenes, sonido y otras formas de información, abriendo una nueva etapa en la evolución de la inteligencia artificial. © FoToArtist_1.
11.2. Del reconocimiento a la generación
Durante décadas, muchas de las aplicaciones más visibles de la inteligencia artificial estuvieron orientadas a decidir qué era algo, dónde se encontraba o qué resultado debía asociarse a una entrada. Un sistema clasificaba una fotografía, detectaba una anomalía, reconocía una palabra pronunciada o estimaba la categoría de un documento. Estas tareas pueden ser extraordinariamente complejas, pero comparten una lógica general: parten de información existente y producen una decisión, una etiqueta o una predicción sobre ella. El desarrollo de modelos generativos introdujo una posibilidad diferente. En lugar de limitarse a reconocer estructuras presentes en los datos, el sistema podía aprender suficientemente bien algunas de sus regularidades como para producir nuevos ejemplos que conservaran características semejantes. La máquina pasaba de responder principalmente «esto pertenece a esta clase» a enfrentarse también a preguntas como «¿qué ejemplo podría existir dentro de esta distribución?».
La distinción puede entenderse comparando dos formas de modelar un problema. Un modelo discriminativo aprende principalmente a separar categorías o predecir una salida a partir de una entrada: dadas ciertas características, determina cuál es la respuesta más probable. Un modelo generativo intenta aprender aspectos de la distribución que produjo los datos, de modo que pueda representar cómo se organizan y, bajo determinadas condiciones, producir nuevas muestras. Esta diferencia no establece una frontera absoluta entre dos mundos tecnológicos; numerosos sistemas combinan ambas ideas y los métodos concretos son muy diversos. Pero históricamente permite comprender un cambio importante. Reconocer un rostro requiere distinguirlo de otros; generar una imagen exige construir una configuración nueva de píxeles que mantenga relaciones visuales plausibles. Ambas tareas se apoyan en aprendizaje, aunque persiguen objetivos distintos.
La generación computacional posee antecedentes mucho anteriores al auge reciente de la IA generativa. Los modelos probabilísticos ya podían producir secuencias siguiendo distribuciones aprendidas, y diversos sistemas de síntesis habían generado música, texto o imágenes mediante reglas y procedimientos estadísticos. El aprendizaje profundo amplió enormemente estas posibilidades. Los autoencoders mostraron que una red podía aprender representaciones comprimidas de los datos y reconstruirlos; los autoencoders variacionales desarrollaron espacios latentes desde los que podían obtenerse nuevas muestras. En 2014, las redes generativas adversarias, o GAN, introducidas por Ian Goodfellow y colaboradores, propusieron un entrenamiento en el que un generador intentaba producir ejemplos capaces de confundir a un discriminador encargado de distinguirlos de los reales. La competencia entre ambos permitió alcanzar resultados visuales cada vez más convincentes.
Otras familias de modelos siguieron caminos diferentes. Los modelos autorregresivos aprendieron a generar información paso a paso, estimando cada nuevo elemento a partir de los anteriores, una lógica especialmente importante en el lenguaje. Los modelos de difusión desarrollaron posteriormente procedimientos en los que el sistema aprende a revertir gradualmente un proceso de adición de ruido, hasta poder construir nuevas muestras a partir de una señal inicialmente desordenada. Estas estrategias muestran que no existe una única técnica denominada «generación». Lo común es que el modelo haya aprendido suficiente estructura estadística como para producir configuraciones nuevas compatibles con aquello que observó durante el entrenamiento. Dependiendo del método, esa generación puede aplicarse a secuencias lingüísticas, imágenes, sonido u otras representaciones digitales.
Este cambio alteró también la relación entre usuario y sistema. En muchas aplicaciones tradicionales, la persona proporcionaba un objeto para que la máquina lo analizara: una fotografía que debía clasificarse, una frase que debía traducirse o una señal que debía reconocerse. Los modelos generativos podían recibir además una condición y construir una salida nueva a partir de ella. Esa condición puede adoptar formas muy distintas: una categoría, una descripción, otra imagen, una secuencia previa o determinadas propiedades deseadas. La generación condicionada permite orientar el espacio de posibilidades aprendido sin especificar manualmente cada detalle del resultado. Aun así, «nuevo» no significa independiente de los datos: las capacidades del sistema proceden precisamente de las regularidades adquiridas durante el entrenamiento y están condicionadas por su arquitectura, su información de partida y el procedimiento utilizado para generar.
El paso del reconocimiento a la generación no sustituyó las capacidades anteriores, sino que las amplió. Los sistemas continuaron clasificando, detectando y prediciendo, pero algunos modelos comenzaron a utilizar representaciones aprendidas para construir también información que no existía previamente en esa forma concreta. Esta transición preparó el terreno para una inteligencia artificial capaz de funcionar simultáneamente como analizador y como productor de contenido. Su desarrollo, sin embargo, dependió de una condición material decisiva: aumentar conjuntamente la cantidad de información utilizada, la capacidad interna de los modelos y los recursos necesarios para entrenarlos. Antes de considerar las nuevas habilidades que comenzaron a observarse en estos sistemas, es necesario comprender esa relación entre tres magnitudes que impulsaron buena parte de su expansión: datos, parámetros y escala.
La inteligencia artificial en la vida cotidiana. Muchos sistemas de inteligencia artificial forman parte de actividades cotidianas sin que los percibamos necesariamente como tales. Motores de recomendación, asistentes digitales, clasificación automática, búsquedas, traducción o reconocimiento de imágenes utilizan técnicas de inteligencia artificial. Su presencia cotidiana muestra hasta qué punto estas tecnologías han dejado de ser únicamente herramientas experimentales. © AndersonPiza.
11.3. Datos, parámetros y escala
El crecimiento reciente de la inteligencia artificial puede entenderse como el resultado de una interacción entre tres elementos que se refuerzan mutuamente: los datos utilizados para entrenar, los parámetros que permiten al modelo representar relaciones y la capacidad de cálculo necesaria para ajustar esos parámetros. Ninguno de ellos actúa de forma aislada. Un modelo enorme entrenado con pocos datos puede desaprovechar buena parte de su capacidad; un conjunto inmenso de información puede resultar poco útil si la arquitectura no dispone de suficiente flexibilidad para aprender de él; y ambos elementos quedan limitados si el entrenamiento no cuenta con recursos computacionales suficientes. La escala aparece precisamente cuando estas dimensiones comienzan a crecer de manera coordinada. El avance no consiste simplemente en «hacer modelos más grandes», sino en encontrar combinaciones capaces de convertir una cantidad creciente de experiencia digital en estructuras internas cada vez más ricas.
Los parámetros son los valores ajustables que el modelo modifica durante el entrenamiento. En una red neuronal, determinan cómo se ponderan las señales y qué transformaciones se aplican a la información a medida que atraviesa las diferentes capas. Aumentar su número amplía, en términos generales, la capacidad del sistema para representar relaciones complejas, aunque esa capacidad potencial no garantiza por sí sola un buen aprendizaje. Un modelo con muchos parámetros puede describir patrones extraordinariamente sofisticados, pero también puede desperdiciar recursos, aprender correlaciones poco útiles o resultar difícil de entrenar si no dispone de suficientes ejemplos. El tamaño debe entenderse, por tanto, como capacidad representacional: una especie de espacio matemático dentro del cual el entrenamiento busca una configuración que permita realizar adecuadamente las tareas para las que se prepara el sistema.
Los datos proporcionan la experiencia que da forma a esa capacidad. A medida que los modelos crecieron, fue necesario alimentarlos con colecciones cada vez mayores y más diversas para evitar que su enorme flexibilidad se limitara a repetir estructuras estrechas o excesivamente particulares. En lenguaje, esto significó trabajar con grandes corpus formados por libros, artículos, páginas web y otros documentos; en visión, con colecciones masivas de imágenes; y en otros dominios, con señales, registros o combinaciones de distintas modalidades. Pero la escala de los datos no puede reducirse a contar ejemplos. Importan también su variedad, calidad, distribución y grado de redundancia. Millones de muestras casi idénticas no proporcionan la misma riqueza que una colección capaz de mostrar contextos, estructuras y situaciones diversas.
El tercer componente es el cálculo. Ajustar miles de millones de parámetros sobre enormes conjuntos de datos exige realizar cantidades extraordinarias de operaciones matemáticas, muchas de ellas repetidas durante sucesivas fases del entrenamiento. La expansión de GPU, aceleradores especializados y sistemas distribuidos permitió repartir ese trabajo entre numerosos procesadores y reducir tiempos que, de otro modo, resultarían impracticables. La computación se convirtió así en una variable fundamental para decidir qué modelos podían entrenarse realmente. Aumentar datos y parámetros sin aumentar también los recursos de cálculo puede producir entrenamientos incompletos o ineficientes. La escala tecnológica surge, por tanto, de una coordinación entre capacidad del modelo, información disponible y presupuesto computacional, no de una carrera independiente por maximizar cada magnitud.
Los investigadores comenzaron a observar además relaciones relativamente regulares entre estas variables y el rendimiento. En determinados contextos, aumentar de forma sistemática el tamaño del modelo, la cantidad de datos o el cálculo utilizado producía mejoras previsibles en medidas concretas del entrenamiento. Estas relaciones, conocidas habitualmente como leyes de escala, ayudaron a planificar modelos mayores y a estudiar cómo distribuir los recursos disponibles. Pero no deben interpretarse como una ley universal según la cual más siempre significa mejor. El rendimiento puede saturarse, una mala selección de datos puede limitar el progreso y diferentes arquitecturas aprovechan los recursos de manera desigual. Además, mejoras pequeñas en una métrica pueden exigir incrementos muy grandes de cálculo. La escala abre posibilidades, pero también introduce rendimientos decrecientes, costes crecientes y decisiones cada vez más importantes sobre eficiencia.
Datos, parámetros y cálculo forman así una relación de equilibrio. La historia reciente de la IA muestra que los grandes avances aparecieron cuando las tres dimensiones crecieron de manera suficientemente coordinada y cuando los algoritmos permitieron aprovechar esa expansión. Esta perspectiva ayuda a entender por qué determinados modelos comenzaron a mostrar una versatilidad mucho mayor que las generaciones anteriores sin recurrir necesariamente a una regla independiente para cada nueva tarea. Una capacidad interna más amplia, entrenada con información diversa y sostenida por enormes recursos computacionales, podía reutilizar regularidades adquiridas en contextos diferentes. Sin embargo, a medida que aumentaba la escala empezó a discutirse otro fenómeno todavía más llamativo: la aparición de comportamientos que parecían hacerse visibles solo a partir de determinados niveles de capacidad o entrenamiento. Esa cuestión conduce directamente al debate sobre las llamadas capacidades emergentes.
11.4. Capacidades emergentes
A medida que los modelos aumentaron de tamaño y fueron entrenados con datos más variados, los investigadores comenzaron a observar un fenómeno difícil de describir mediante una simple curva de mejora gradual. Algunas habilidades parecían ser escasas o casi inexistentes en modelos pequeños y hacerse mucho más visibles cuando aumentaban los parámetros, los datos o el cálculo utilizado durante el entrenamiento. A estos comportamientos se los ha denominado con frecuencia capacidades emergentes. La expresión no implica que aparezca misteriosamente una facultad inexistente, sino que determinadas competencias pueden alcanzar un nivel apreciable cuando el sistema dispone de suficiente capacidad para combinar regularidades aprendidas previamente. La imagen resulta sugerente: numerosas mejoras pequeñas en representación, memoria contextual y predicción pueden acumularse hasta producir un comportamiento que, observado desde fuera, parece cualitativamente distinto.
Un ejemplo importante aparece en la posibilidad de afrontar tareas para las que el modelo no ha sido entrenado mediante un procedimiento independiente. Un sistema lingüístico de gran escala puede recibir una instrucción y unos pocos ejemplos dentro del propio contexto y utilizar esa información para inferir provisionalmente qué debe hacer. Esta capacidad, conocida como aprendizaje en contexto o in-context learning, no modifica necesariamente los parámetros del modelo durante la conversación; el sistema utiliza las relaciones presentes en la secuencia para producir la respuesta correspondiente. Clasificar un texto después de observar algunos ejemplos, transformar una expresión siguiendo un patrón o adaptar momentáneamente el formato de una respuesta pueden surgir de esta manera. El modelo reutiliza regularidades aprendidas durante su entrenamiento general para resolver una tarea formulada mediante el propio lenguaje.
También se observaron mejoras en actividades que exigían combinar varias operaciones: determinadas formas de razonamiento lingüístico, manipulación de símbolos, resolución de analogías, traducción entre lenguas menos frecuentes o seguimiento de instrucciones con varios pasos. Ninguna de estas capacidades debe interpretarse como una prueba automática de razonamiento humano general. Los resultados pueden ser muy desiguales y una pequeña modificación en la formulación de una tarea puede alterar considerablemente el rendimiento. Lo relevante desde el punto de vista histórico es otra cosa: una arquitectura entrenada originalmente mediante objetivos generales podía llegar a realizar un repertorio de tareas mucho más amplio que el previsto por los sistemas especializados tradicionales. La frontera entre «modelo» y «colección de aplicaciones» comenzaba así a volverse menos nítida.
El término «emergencia», sin embargo, ha generado debate científico. Algunas investigaciones mostraron que una capacidad podía parecer surgir bruscamente porque se estaba utilizando una medida que solo registraba el éxito cuando la respuesta era completamente correcta. Si se observa una métrica más gradual, parte del supuesto salto puede convertirse en una progresión continua. Esto significa que no toda capacidad presentada como emergente representa necesariamente una transición repentina en el funcionamiento interno del modelo. En otros casos, las mejoras sí pueden ser muy pronunciadas al alcanzar determinadas escalas o combinar ciertos métodos de entrenamiento. Por ello conviene utilizar el concepto con prudencia: describe un patrón empírico interesante, pero no constituye una explicación completa de por qué aparece una habilidad ni demuestra por sí mismo que se haya producido un cambio fundamental en la naturaleza de la inteligencia del sistema.
La dificultad para anticipar estas capacidades introduce una cuestión nueva en el desarrollo de la IA. Cuando un programa se diseña para una función muy específica, resulta relativamente claro qué comportamiento se espera de él. Un gran modelo entrenado con un objetivo amplio puede adquirir usos que no estaban enumerados individualmente durante su construcción. Esto convierte la evaluación en una tarea más compleja. No basta con medir el rendimiento sobre una sola prueba; es necesario explorar diferentes tipos de problemas, analizar errores y comprobar cómo cambian las respuestas según el contexto. La versatilidad se convierte simultáneamente en una ventaja y en una fuente de incertidumbre: el mismo sistema puede resolver tareas sorprendentes y, poco después, fallar ante otra aparentemente sencilla. La escala amplía el repertorio, pero no garantiza uniformidad ni fiabilidad.
Las capacidades emergentes ayudan así a comprender por qué los grandes modelos comenzaron a percibirse como algo diferente de una colección tradicional de herramientas especializadas. No porque hubieran alcanzado una inteligencia general plenamente definida, sino porque una misma estructura podía mostrar comportamientos diversos sin haber sido construida mediante un módulo independiente para cada uno. Esta flexibilidad preparó el terreno para sistemas capaces de adaptarse a instrucciones, reutilizar conocimientos estadísticos adquiridos durante el entrenamiento y combinar competencias dentro de una única interacción. A partir de ese punto, la inteligencia artificial dejó de evolucionar únicamente mediante mejoras aisladas en reconocimiento, traducción o clasificación y comenzó a organizarse alrededor de modelos de propósito más amplio. Esa transformación conduciría al nacimiento de una nueva generación de sistemas, concebidos no solo como algoritmos especializados, sino como plataformas capaces de sostener múltiples formas de interacción y procesamiento.
11.5. El nacimiento de una nueva generación de sistemas de IA
La combinación de grandes modelos, entrenamiento previo y capacidades reutilizables comenzó a transformar la propia arquitectura de los sistemas de inteligencia artificial. Durante mucho tiempo, desarrollar una aplicación implicaba reunir datos específicos, seleccionar un algoritmo adecuado y entrenarlo para resolver una tarea relativamente concreta. La nueva generación invirtió parcialmente ese proceso: primero podía entrenarse un modelo muy amplio sobre enormes cantidades de información y, posteriormente, adaptarlo a numerosas funciones diferentes. El núcleo tecnológico dejaba de construirse necesariamente alrededor de una única aplicación y pasaba a funcionar como una base común sobre la que podían desarrollarse múltiples usos. Esta transformación dio protagonismo a los llamados modelos fundacionales, concebidos como estructuras generales cuyo entrenamiento inicial proporciona capacidades que después pueden aprovecharse, ajustarse o especializarse para tareas diversas.
Este cambio modificó profundamente la relación entre especialización y reutilización. Un modelo previamente entrenado puede adquirir una representación amplia de regularidades lingüísticas, visuales o de otro tipo y utilizar después esa base para resolver problemas que requieren cantidades mucho menores de información específica. En algunos casos se ajustan sus parámetros mediante nuevos ejemplos; en otros, bastan instrucciones o demostraciones introducidas en el contexto para orientar temporalmente su comportamiento. El conocimiento estadístico acumulado durante el entrenamiento general se convierte así en una infraestructura reutilizable. Esto no significa que el modelo posea una competencia uniforme en todos los dominios ni que deje de necesitar adaptación, pero reduce la necesidad de construir desde cero un sistema independiente para cada nueva función.
También cambió la forma de interactuar con la máquina. En muchas generaciones anteriores, utilizar un sistema requería aprender comandos, seleccionar categorías concretas o introducir información mediante interfaces diseñadas específicamente para una tarea. Los modelos lingüísticos de gran escala hicieron posible emplear el propio lenguaje como mecanismo de control mucho más flexible. Una instrucción escrita podía describir el objetivo, proporcionar ejemplos, especificar un formato o solicitar una transformación sin que todas esas posibilidades hubieran sido convertidas previamente en botones o menús independientes. El lenguaje comenzaba a funcionar como una interfaz general entre la persona y el modelo. Este hecho tiene una importancia histórica considerable: una capacidad que durante décadas había sido objeto de investigación —procesar lenguaje humano— se convertía al mismo tiempo en el medio mediante el cual podían solicitarse otras capacidades.
La nueva generación tampoco puede entenderse únicamente como una colección de modelos aislados. En una aplicación real, el modelo suele formar parte de un sistema más amplio que incluye software convencional, mecanismos de recuperación de información, filtros, bases de datos, interfaces y procedimientos destinados a controlar cómo se procesa la entrada y cómo se presenta la salida. Esta distinción entre modelo y sistema resulta esencial. El modelo proporciona determinadas capacidades aprendidas, pero el comportamiento final depende también del entorno tecnológico en el que se integra. Dos aplicaciones construidas sobre modelos semejantes pueden ofrecer experiencias muy distintas según las fuentes de información disponibles, los métodos de adaptación, las restricciones impuestas o la manera en que se organiza la interacción. La inteligencia artificial moderna comienza así a adoptar una estructura por capas en la que un gran modelo constituye el núcleo, pero no la totalidad del producto.
Esta transformación amplió también las posibilidades de transferencia entre tareas. Una representación desarrollada mientras el modelo aprende grandes cantidades de información puede resultar útil después para resumir, clasificar, transformar, comparar o completar contenidos. El sistema deja de depender exclusivamente de una función rígidamente definida durante su construcción y adquiere una versatilidad que recuerda, con todas las diferencias necesarias, a una plataforma informática. Esa analogía ayuda a comprender el cambio: del mismo modo que un ordenador de propósito general puede ejecutar programas diferentes, un gran modelo previamente entrenado puede servir como base para comportamientos distintos sin que todos ellos hayan requerido un entrenamiento completamente independiente. La comparación tiene límites, pero señala una transformación histórica desde algoritmos estrechamente especializados hacia infraestructuras capaces de sostener familias enteras de aplicaciones.
El nacimiento de esta nueva generación no significó la desaparición de los modelos especializados. En muchas tareas, sistemas más pequeños y específicamente diseñados siguen siendo más rápidos, económicos o precisos. La novedad reside en que apareció otra posibilidad tecnológica: modelos amplios capaces de actuar como núcleo común para múltiples funciones y de adaptar su comportamiento según el contexto. Este cambio prepara además un paso adicional. Si una misma arquitectura puede aprender representaciones extensas del lenguaje y reutilizarlas en tareas diversas, resulta natural intentar conectar esa capacidad con otras formas de información. Imágenes, sonidos y vídeo dejan entonces de pertenecer necesariamente a mundos computacionales separados. La siguiente etapa consistirá precisamente en observar cómo los grandes modelos comenzaron a cruzar esas fronteras y dieron origen a sistemas capaces de trabajar con varias modalidades dentro de una misma arquitectura.
11.6. De los modelos especializados a los sistemas multimodales
Durante buena parte del desarrollo de la inteligencia artificial, cada modalidad de información tendió a tratarse como un problema relativamente independiente. Las imágenes se analizaban mediante sistemas de visión artificial, el sonido mediante modelos acústicos y el texto mediante técnicas de procesamiento del lenguaje. Esta especialización permitió avances extraordinarios, pero también generó compartimentos separados: una máquina podía describir con precisión una imagen sin comprender una instrucción escrita, o procesar lenguaje sin relacionarlo directamente con aquello que aparecía en una fotografía. Los sistemas multimodales surgieron de la posibilidad de conectar esas formas de información dentro de representaciones compatibles. El objetivo ya no era únicamente dominar una modalidad concreta, sino aprender correspondencias entre varias: relacionar una imagen con su descripción, una grabación con su transcripción o una escena visual con instrucciones expresadas mediante lenguaje.
Una de las claves consiste en construir espacios de representación donde datos de naturaleza distinta puedan aproximarse cuando expresan contenidos relacionados. Si una fotografía de un caballo y la frase «un caballo corriendo por un campo» se transforman en representaciones matemáticas comparables, el sistema puede aprender que ambas hacen referencia a una estructura común pese a que una proceda de píxeles y la otra de palabras. Esta idea permitió desarrollar modelos capaces de asociar imágenes y textos a gran escala. Sistemas como CLIP, presentado en 2021, mostraron la eficacia de entrenar conjuntamente enormes colecciones de pares formados por imágenes y descripciones. En lugar de necesitar una categoría cerrada definida previamente para cada imagen, el modelo podía aprender relaciones más generales entre lenguaje y contenido visual y reutilizarlas después en numerosas tareas de clasificación o búsqueda.
La multimodalidad también transformó la manera de organizar las arquitecturas. Algunos sistemas utilizan componentes especializados para cada tipo de entrada y después combinan sus representaciones; otros intentan convertir diferentes modalidades en secuencias de unidades que puedan ser procesadas por una arquitectura común. Una imagen puede dividirse en regiones o fragmentos, un sonido en representaciones temporales y un texto en tokens, permitiendo que mecanismos de atención establezcan relaciones entre ellos. El lenguaje adquiere con frecuencia un papel de enlace porque puede describir objetos, acciones, propiedades y relaciones presentes en otras modalidades. Pero esa conexión no significa que todas las formas de información se vuelvan equivalentes. Cada una contiene estructuras propias que deben preservarse: la disposición espacial de una imagen, la continuidad temporal del sonido o el orden sintáctico de una frase plantean problemas diferentes.
El valor de estos sistemas aparece precisamente cuando una tarea exige cruzar esas fronteras. Un modelo puede recibir una imagen y producir una descripción, localizar visualmente aquello a lo que se refiere una expresión, responder preguntas sobre una escena o relacionar documentos que combinan texto y elementos gráficos. En otros casos, audio y lenguaje pueden integrarse para trabajar con habla, mientras que vídeo añade una dimensión temporal mucho más compleja al requerir interpretar secuencias de imágenes junto con sonido y movimiento. Históricamente, este cambio resulta importante porque desplaza la inteligencia artificial desde modelos que interpretan señales aisladas hacia sistemas capaces de construir relaciones entre distintas fuentes de información. La percepción computacional empieza a parecer menos fragmentada, aunque siga estando muy lejos de reproducir la integración sensorial y cognitiva propia de los seres humanos.
La multimodalidad introduce también dificultades específicas. Asociar texto e imagen exige datos donde ambas partes estén razonablemente relacionadas, y esa relación puede ser imperfecta o ambigua. Una descripción no recoge necesariamente todos los elementos de una fotografía, mientras que una misma imagen admite múltiples interpretaciones. Los modelos pueden aprender correlaciones superficiales y depender de convenciones presentes en los conjuntos de entrenamiento. Además, unir modalidades incrementa considerablemente la complejidad computacional y obliga a coordinar representaciones con escalas y estructuras muy diferentes. Evaluar estos sistemas resulta igualmente difícil: responder correctamente a una pregunta sobre una imagen puede requerir reconocer objetos, comprender la frase, relacionar ambos dominios y generar finalmente una respuesta adecuada. Un fallo puede producirse en cualquiera de esas etapas y no siempre resulta sencillo determinar dónde se originó.
El paso de los modelos especializados a los sistemas multimodales amplió así el alcance de la inteligencia artificial sin eliminar la importancia de la especialización. Las arquitecturas generales pueden integrar texto, imagen, audio y otras señales, mientras que componentes especializados siguen aportando eficiencia y precisión en tareas concretas. Lo decisivo es que distintas modalidades comenzaron a formar parte de un mismo espacio tecnológico y a combinarse dentro de modelos entrenados a gran escala. Esta convergencia prepara el último movimiento de este recorrido histórico: sistemas capaces no solo de reconocer o relacionar varias formas de información, sino también de producirlas. Cuando lenguaje, imágenes, sonido y otras modalidades pueden generarse a partir de instrucciones o representaciones aprendidas, la inteligencia artificial entra plenamente en una nueva etapa. Ese umbral conduce directamente a la inteligencia artificial generativa.
11.7. Hacia la inteligencia artificial generativa
La inteligencia artificial generativa representa la culminación provisional de muchas de las transformaciones recorridas a lo largo de esta historia. No nació de una ruptura absoluta con el aprendizaje automático anterior, sino de la convergencia entre redes profundas, grandes conjuntos de datos, arquitecturas capaces de manejar contextos extensos y una capacidad de cálculo cada vez mayor. Durante décadas, buena parte de la IA se había orientado a reconocer, clasificar, estimar o decidir. Los nuevos modelos conservaron esas capacidades, pero añadieron otra posibilidad especialmente visible: producir información nueva siguiendo las regularidades aprendidas durante el entrenamiento. Texto, imágenes, sonido, código u otras representaciones podían construirse a partir de una condición inicial, una descripción o un fragmento previo. La generación pasaba así de ser una función experimental y especializada a convertirse en uno de los centros de desarrollo de la disciplina.
El término «generativa» puede inducir a pensar que la máquina crea de la misma manera que una persona imagina una obra antes de realizarla. Técnicamente, el proceso es diferente. Un modelo generativo aprende estructuras estadísticas presentes en grandes cantidades de ejemplos y utiliza esas estructuras para producir nuevas configuraciones compatibles con ellas. Según la arquitectura, puede predecir sucesivamente unidades lingüísticas, reconstruir información desde espacios latentes o transformar progresivamente ruido en una imagen organizada. El resultado puede ser novedoso en el sentido de que esa combinación concreta no existía previamente, pero sus posibilidades dependen del aprendizaje realizado. La generación se sitúa, por tanto, entre dos simplificaciones equivocadas: no consiste simplemente en copiar una base de datos, pero tampoco debe interpretarse automáticamente como una imaginación autónoma equivalente a la creatividad humana.
Lo verdaderamente transformador fue la amplitud que alcanzaron estos sistemas cuando se apoyaron en modelos previamente entrenados a gran escala. Una misma base podía responder a instrucciones diversas, cambiar de estilo, resumir, reorganizar información, completar fragmentos o producir diferentes tipos de salida sin que cada comportamiento exigiera construir desde cero un programa independiente. El lenguaje se convirtió además en una forma particularmente poderosa de interacción, porque permitía expresar objetivos mediante instrucciones ordinarias en lugar de recurrir siempre a interfaces rígidas. Esta combinación entre modelos amplios y comunicación lingüística acercó capacidades antes reservadas a especialistas a usuarios sin conocimientos técnicos avanzados. La IA empezó a presentarse menos como un algoritmo oculto dentro de una aplicación y más como un sistema con el que podía establecerse una interacción flexible.
La integración multimodal amplió todavía más este cambio. Si un modelo podía relacionar texto e imagen, o conectar posteriormente lenguaje, sonido, vídeo y otras señales, las fronteras entre aplicaciones comenzaron a hacerse menos rígidas. Una descripción podía orientar la creación de una imagen; una imagen podía convertirse en objeto de análisis lingüístico; una grabación podía transformarse, resumirse o relacionarse con otras formas de información. La importancia de esta convergencia no reside únicamente en acumular funciones dentro de una misma herramienta, sino en construir representaciones capaces de cruzar modalidades. La inteligencia artificial avanzaba desde una colección de sistemas separados hacia arquitecturas que podían recibir información de diferentes tipos y producir respuestas en formatos también diferentes, utilizando una base de aprendizaje cada vez más compartida.
Este avance abrió posibilidades extraordinarias, pero también hizo más visibles los límites que acompañaban a los modelos. Un texto bien escrito puede contener errores; una imagen convincente puede representar algo imposible; una respuesta segura en su forma puede apoyarse en relaciones estadísticas incorrectas. La capacidad de generar incrementa precisamente la importancia de distinguir plausibilidad y verdad. Del mismo modo, cuanto mayor es la diversidad de tareas accesibles mediante un mismo sistema, más difícil resulta anticipar todos sus comportamientos. La IA generativa no elimina los problemas estudiados anteriormente —dependencia de los datos, sesgos, sobreajuste, coste computacional o dificultades de interpretación—, sino que los traslada a sistemas con una capacidad de producción mucho mayor. Su potencia procede de la escala y la flexibilidad, y esas mismas propiedades hacen necesario examinarla con especial rigor.
Con esta transformación se cierra una trayectoria que comenzó mucho antes de que existieran los ordenadores modernos: del sueño de construir máquinas capaces de actuar, al cálculo mecánico; de la lógica formal a la computación; de los símbolos y reglas al aprendizaje estadístico; de los modelos especializados a las redes profundas; y de la predicción a sistemas capaces de producir nuevos contenidos. La inteligencia artificial generativa no constituye el final de esa historia, sino la apertura de otra etapa. A partir de aquí cambian las preguntas: cómo funcionan los grandes modelos generativos en la práctica, qué ocurre cuando texto, imagen, voz y vídeo convergen, cómo surgen asistentes y agentes capaces de utilizar herramientas, qué aplicaciones pueden transformar y qué problemas plantean sus errores, sus datos, su impacto cultural o su relación con el trabajo humano. Esas cuestiones pertenecen ya a un nuevo recorrido: el de la inteligencia artificial generativa, sus aplicaciones, sus agentes y sus desafíos.
Epílogo: de las máquinas que obedecen a las máquinas que aprenden
La historia de la inteligencia artificial permite contemplar con perspectiva una transformación que, vista únicamente desde el presente, puede parecer repentina. Detrás de los sistemas actuales existe una larga cadena de preguntas sobre cálculo, lógica, conocimiento, lenguaje y aprendizaje. Los autómatas anticiparon el deseo de construir mecanismos capaces de actuar; Leibniz imaginó la posibilidad de mecanizar ciertas formas de razonamiento; Babbage y Ada Lovelace ampliaron la idea de máquina calculadora hacia una máquina programable; Turing proporcionó un marco fundamental para pensar la computación y formuló de manera moderna la pregunta por la inteligencia de las máquinas. Dartmouth convirtió después aquellas inquietudes dispersas en un campo de investigación reconocible. Desde entonces, la historia de la IA ha estado marcada tanto por avances extraordinarios como por decepciones, rectificaciones y periodos de crisis que obligaron a comprender mejor la verdadera dificultad del problema.
Durante una primera etapa dominó la aspiración de representar explícitamente el conocimiento. Símbolos, reglas, búsquedas y sistemas expertos mostraron que una máquina podía resolver problemas sofisticados siempre que el mundo al que debía enfrentarse estuviera suficientemente delimitado. Sus límites llevaron a explorar otra vía: permitir que parte del comportamiento se obtuviera mediante aprendizaje. El centro de gravedad comenzó entonces a desplazarse desde la regla escrita por el programador hacia los datos, los ejemplos y el entrenamiento. Aprendizaje supervisado, no supervisado y por refuerzo ofrecieron distintas maneras de construir modelos capaces de extraer regularidades de la experiencia computacional. Con las redes neuronales, esa capacidad adquirió una nueva dimensión: millones de parámetros podían ajustarse conjuntamente hasta construir representaciones internas que ningún programador había especificado conexión por conexión.
El aprendizaje profundo multiplicó las posibilidades de ese paradigma cuando coincidieron mejores métodos de entrenamiento, grandes colecciones digitales y una capacidad de cálculo que generaciones anteriores no habían tenido a su alcance. Las máquinas comenzaron a reconocer objetos, analizar imágenes, transcribir voces, traducir idiomas y ordenar cantidades inmensas de información. Muchas de aquellas funciones terminaron integrándose silenciosamente en herramientas cotidianas, hasta el punto de que dejamos de percibirlas como ejemplos extraordinarios de inteligencia artificial. Pero el lenguaje planteó una frontera especialmente importante. Representar palabras mediante estructuras matemáticas, modelar relaciones contextuales y desarrollar arquitecturas como el Transformer permitió construir sistemas capaces de aprender regularidades lingüísticas a una escala inédita. La predicción de unidades dentro de una secuencia terminó convirtiéndose, mediante repetición y contexto, en una poderosa capacidad para producir lenguaje.
Al crecer los modelos, los datos y los recursos de entrenamiento, la inteligencia artificial dejó además de estar formada únicamente por programas estrechamente especializados. Los grandes modelos previamente entrenados pudieron reutilizar una misma base para tareas diferentes, mostrar capacidades que no habían sido construidas como módulos independientes e integrar progresivamente distintas modalidades de información. Texto, imagen, sonido y otras señales comenzaron a encontrarse dentro de sistemas relacionados. El cambio fundamental no consistió en que las máquinas hubieran adquirido una inteligencia humana completa, sino en que la frontera entre analizar y producir información se hizo mucho más permeable. Un modelo podía reconocer una estructura y, a partir de las regularidades aprendidas, generar también nuevas combinaciones. Con ello aparecía el punto de llegada de esta entrada y, al mismo tiempo, el comienzo de una nueva etapa.
Esta perspectiva histórica complementa la entrada ya publicada en el blog, «ChatGPT: conversación, asistencia y escritura en la era de la inteligencia artificial». Allí, la inteligencia artificial aparece ya convertida en experiencia concreta: una herramienta con la que conversar, redactar, estudiar, organizar información, revisar ideas y desarrollar trabajos mediante lenguaje natural. El recorrido realizado aquí mira deliberadamente en la dirección contraria: retrocede desde esa interfaz aparentemente sencilla hasta las décadas de investigación que hicieron posible que una conversación con una máquina llegara a existir. Leer ambas entradas desde esos dos extremos permite contemplar el mismo fenómeno desde perspectivas complementarias. Una muestra lo que significa utilizar una herramienta avanzada de IA en la vida cotidiana; esta reconstruye los fundamentos científicos y tecnológicos que se encuentran detrás de esa posibilidad. El presente se entiende mejor cuando sabemos de dónde procede.
Pero la historia no termina ante una ventana de conversación. La siguiente entrada de esta serie, «Inteligencia artificial generativa: aplicaciones, agentes y desafíos», con el subtítulo «De los modelos capaces de crear contenido a los agentes inteligentes y la transformación de la sociedad digital», retomará precisamente el punto en que este recorrido se detiene. Si aquí hemos seguido el camino que conduce desde las primeras máquinas y la lógica formal hasta el aprendizaje automático, las redes profundas, los Transformer y los grandes modelos, allí la mirada avanzará hacia lo que esos sistemas están empezando a hacer: generar diferentes formas de contenido, combinar modalidades, utilizar herramientas, evolucionar hacia asistentes y agentes, integrarse en ámbitos científicos y profesionales y plantear nuevas preguntas sobre creatividad, fiabilidad, trabajo, responsabilidad y organización social. Mirar hacia atrás permite comprender cómo llegamos hasta aquí; mirar hacia adelante obliga a preguntarnos qué haremos con lo que hemos construido. Entre ambas direcciones se encuentra la cuestión que seguirá acompañando a toda la serie: no solo hasta dónde puede llegar la inteligencia artificial, sino cómo queremos relacionarnos con ella.